airllm:逐层加载模型,让小显存跑大模型
airllm 是 Apache-2.0 的 Python 库,每次只把一层放进显存。README 称 70B 模型可在 4GB 显卡上运行,速度受磁盘读取限制。
项目资料
GitHub Ecosystem- 许可证
- Apache-2.0
- 主语言
- Jupyter Notebook
- 星标
- 39,988
- 核查时间
- 2026-10-21
以上快照资料以核查当日为准,可能随版本或运营策略变化。
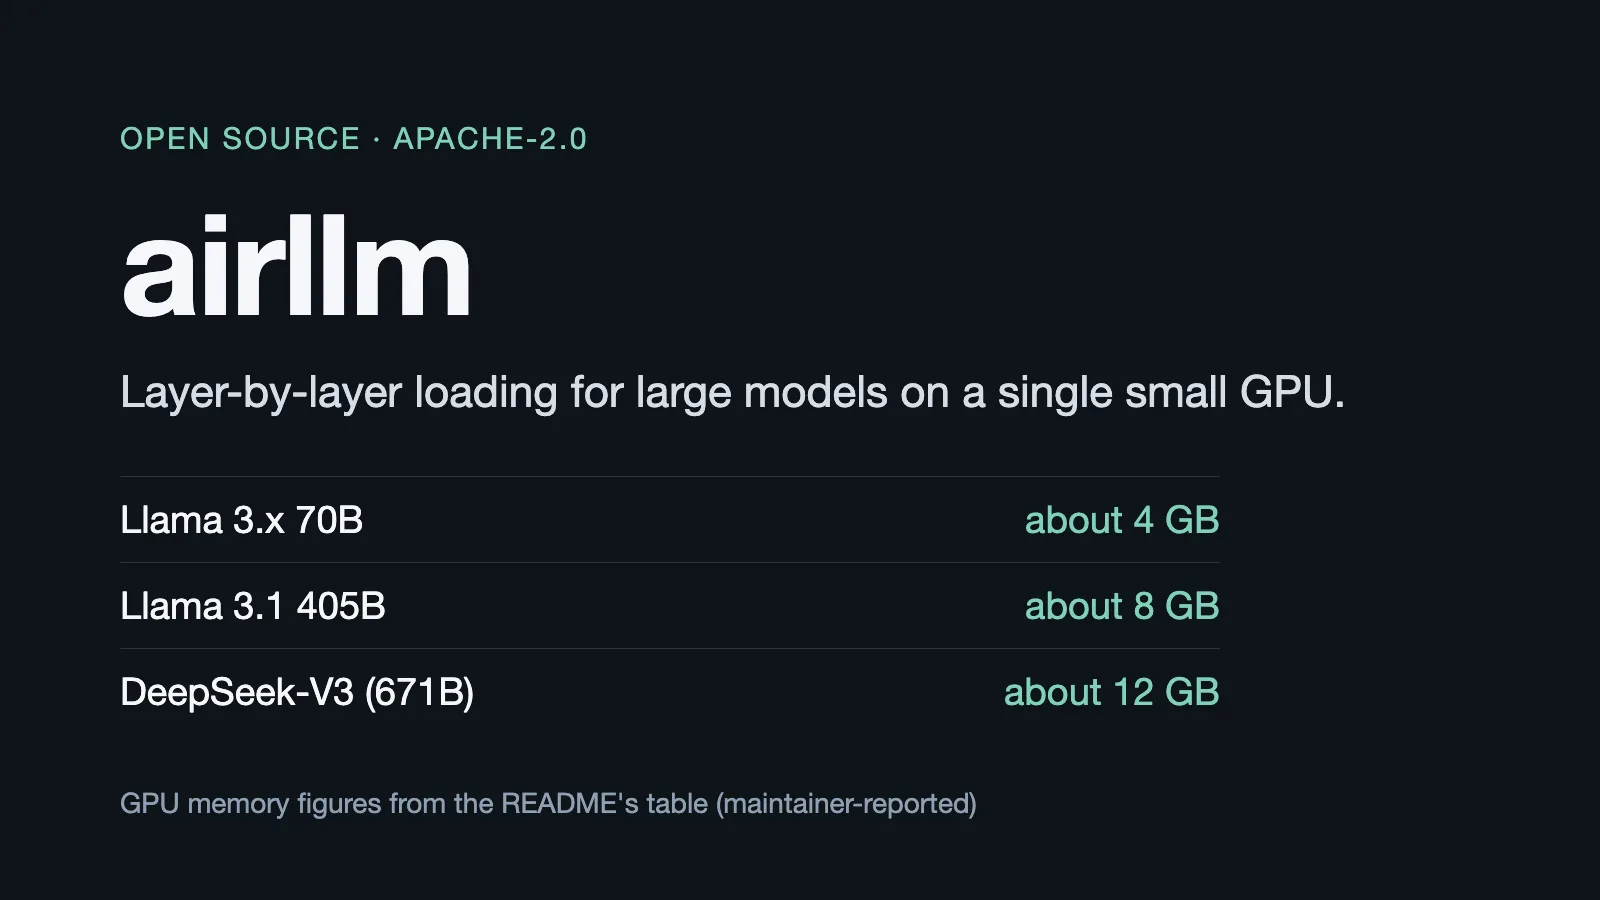
跑 70B 级别的模型,通常得准备一张显存很大的显卡。airllm 走的是另一条路:推理时每次只让一层留在显存里,算完再换下一层。它是 Apache-2.0 许可的 Python 库,README 写明,不做量化、蒸馏或剪枝,也能在单张 4GB 显卡上跑 70B 模型。仓库在 GitHub 上约有 4 万颗星,最近一次正式发布是 2026 年 9 月的 v4.0.0。
核心功能
- 逐层加载:README 写明,显存占用取决于单层的大小,而不是整个模型的大小。表格里,Llama 3.x 70B 约需 4GB,Llama 3.1 405B 约需 8GB,DeepSeek-V3(671B)约需 12GB。这些是维护者给出的数字,我们没有在这些显卡上测量。
- 可选的块级压缩:初始化时传入
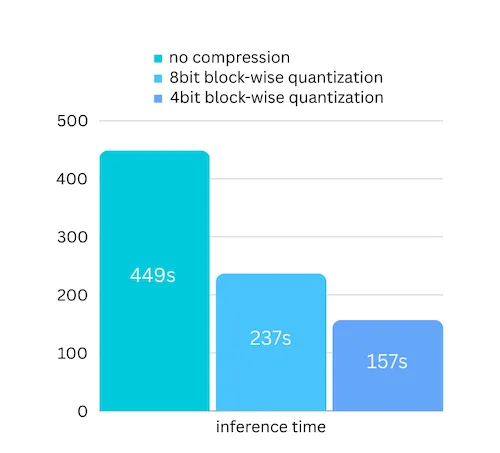
compression='4bit'或'8bit',README 称推理最多快 3 倍,精度损失「几乎可以忽略」。上图就是这组对比,但图中没有标注模型和硬件。 - 更新日志里的实测记录:2026 年 7 月的记录称,Kimi K3(2.8T)在一张 RTX 6000 Ada 上端到端运行,显存为 3.72GB。2026 年 8 月的记录称,Qwen3.8-Flash-Next 在一张 RTX 4090 上为 5.95GB。
- v4.0.0 的流式 LoRA 训练:冻结的权重留在磁盘上,适配器留在显存里。README 写 Qwen3.8-Flash-Next 可在 6GB 显存下训练,Qwen3.8-27B 在序列长度 512 时约需 2GB。
- 沿用 Hugging Face 的模型 ID:把仓库 ID 传给
AutoModel.from_pretrained,写法接近普通的 Transformers 模型,也可以直接传入本地模型路径。
典型使用场景
- 只有一张消费级显卡、想试大模型行为的学生和研究者:速度会慢,但完整的推理流程能跑通。
- 能接受慢速、需要批量处理长文本的开发者:比如夜里批量做长文档摘要,单次延迟并不重要。
- 想在小显存上做 LoRA 实验的人:v4.0.0 的训练示例给出了 Flash-Next 与 27B 模型的显存数字,可以拿来对照自己的机器。
- 想理解分层加载原理的读者:README 的显存表格把显存和模型大小之间的关系讲得很直接。
- 用 Mac 试一试的人:README 的更新记录里有 v2.8.2(2023 年 12 月)支持 macOS 运行 70B 模型的条目。
快速上手
pip install airllm
用 Hugging Face 的仓库 ID 加载模型:
from airllm import AutoModel

model = AutoModel.from_pretrained("Qwen/Qwen3-32B")
README 还列出了 Qwen/Qwen3.8-27B(3.33GB)和 deepseek-ai/DeepSeek-V3(约 12GB)等例子,换掉仓库 ID 即可试用。
README 还提到,模型初次加载时会被切分成按层保存的文件,可以在初始化时用 layer_shards_saving_path 指定保存位置。切分后的文件会占用磁盘空间,磁盘读取也是速度受限的原因之一。
运行 v4.0.0 的训练示例需要更新依赖:先执行 pip install -U airllm,再从 GitHub 安装 transformers 的主分支(pip install git+https://github.com/huggingface/transformers.git),因为 Qwen3.8-Flash-Next 依赖主分支里的 qwen4_exp。
Hugging Face 上的受限模型需要先在网页上申请访问权限,否则加载时会报 401 Client Error。README 的 FAQ 里有这条说明。
小结
airllm 适合想在有限显存上跑大模型、又能接受慢速输出的人。它不适合需要低延迟的在线服务。README 没有给出每秒生成多少 token,只说明使用压缩功能时,瓶颈主要在磁盘读取。如果是离线批量推理,慢速的影响不大;如果要做交互式对话,最好先在自己的机器上测一下等待时间。
几件事要先知道。第一,README 里的显存数字大多是维护者的测量或估算,我们没有在任何一张显卡上运行。第二,「精度损失几乎可以忽略」没有附测试结果,我们也没有核对。第三,README 页面上的许可证徽章链接指向另一个仓库,我们以本仓库的 LICENSE 文件为准,内容是 Apache-2.0。
仓库创建于 2023 年 6 月 12 日,最近一次推送是 2026 年 10 月 21 日,未归档。截至 2026-10-21,有 39,988 颗星。GitHub 把主语言标为 Jupyter Notebook,但这个库本身是 Python 包。