LlamaFactory:一份配置微调上百款大模型
hiyouga 的开源微调框架(Apache-2.0),上百款语言与多模态模型共用一套配置,4-bit QLoRA 跑 7B 约 6GB 显存。
项目资料
GitHub Ecosystem- 许可证
- Apache-2.0
- 主语言
- Python
- 星标
- 75,235
- 核查时间
- 2026-09-30
以上快照资料以核查当日为准,可能随版本或运营策略变化。
在本地微调一个大模型,最劝退的往往不是算力,是环境:数据格式要对上、聊天模板要对上、显存一不够就得推倒重来。hiyouga 开源的 LlamaFactory 把这一整套收成一份配置——上百款语言和多模态模型共用一个训练入口,LoRA、QLoRA、全参数、偏好训练之间切换改的是配置字段,不用重写脚本。仓库按 Apache-2.0 发布,论文发在 ACL 2024,截至 2026-09-30 有 75.2k 星,官方页面上 Amazon、NVIDIA、阿里云都列在使用者名单里;公众号「开源软件社」最近也专门介绍过它。
核心功能
- 模型覆盖:支持列表从 Llama、Qwen3、DeepSeek、Gemma 到 GLM、Phi,多模态覆盖 LLaVA、InternVL、Qwen3-VL,音频和视频模型也在列;新模型基本当天跟进,Qwen3、Gemma 3、GLM-4.1V、InternLM 3、MiniCPM-o-2.6 都在官方的 Day 0 支持表里。
- 训练方式:预训练、SFT、奖励建模、PPO、DPO、KTO、ORPO、SimPO 都有实现,全参数、冻结、LoRA、QLoRA、OFT 任意搭配;GaLore、BAdam、APOLLO、Adam-mini、Muon 这些省显存优化器只是配置里的一行字段。
- 显存门槛:官方估算表里 16-bit LoRA 跑 7B 约 16GB 显存,4-bit QLoRA 约 6GB,2-bit 压到 4GB(详见下方性能数据)。
- 加速开关:FlashAttention-2、Unsloth、Liger Kernel、KTransformers 都以开关形式接入,
use_unsloth: true、enable_liger_kernel: true按需打开;监控接 LlamaBoard、TensorBoard、Wandb、MLflow、SwanLab。 - 零代码入口:
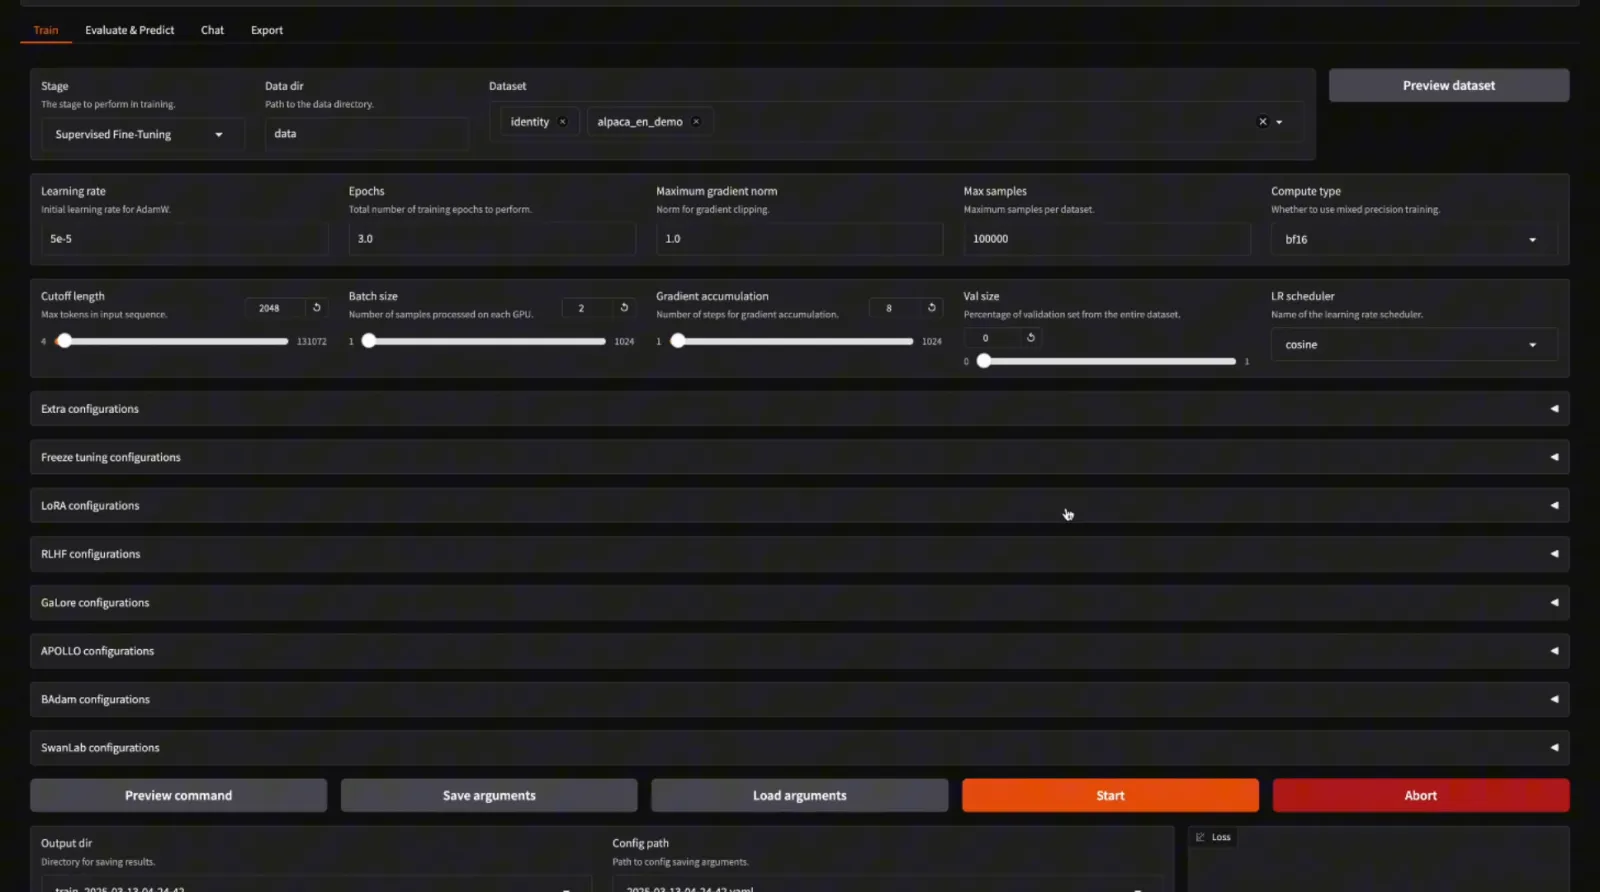
llamafactory-cli webui起一个网页界面,训练、评测、推理都在表单里点,不用写一行训练代码。 - 训后落地:LoRA 权重可合并导出,导出时能一并生成 Ollama 的 modelfile;也能直接起 OpenAI 风格 API 给别的程序调用。
典型使用场景
- 手里一张 16–24GB 显存的卡,想把私有数据喂给 7B–14B 模型做领域微调的个人和中小团队。
- 想横向比较多种训练方法(LoRA 对比 DPO 对比全参数)的人——换方法改的是配置字段,不用重写脚本。
- 教学与演示:网页界面零代码跑通一遍微调流程,训练曲线接 TensorBoard 或 SwanLab 就能看到。
快速上手
git clone --depth 1 https://github.com/hiyouga/LlamaFactory.git
cd LlamaFactory
pip install -e .
pip install -r requirements/metrics.txt
要求 Python 3.11 以上、PyTorch 2.0 以上(推荐 2.6.0)、transformers 4.49 以上。装好后官方快速开始用 Qwen3-4B 走三条命令,分别对应微调、推理和合并:
llamafactory-cli train examples/train_lora/qwen3_lora_sft.yaml
llamafactory-cli chat examples/inference/qwen3_lora_sft.yaml
llamafactory-cli export examples/merge_lora/qwen3_lora_sft.yaml
不想碰命令行就跑 llamafactory-cli webui,训练、推理、导出都在表单里选;也可以直接用官方 Docker 镜像(Ubuntu 22.04 + CUDA 12.4 + PyTorch 2.6.0 的固定组合),或者用 uv run llamafactory-cli webui 让它自己建隔离环境。
性能数据
官方 README 的显存估算表(标注为 estimated,按 7B/14B/70B 摘录):
| 方法 | 量化位数 | 7B | 14B | 70B |
|---|---|---|---|---|
| 全参数(bf16/fp16) | 32 | 120GB | 240GB | 1200GB |
| 冻结 / LoRA / GaLore / APOLLO / BAdam / OFT | 16 | 16GB | 32GB | 160GB |
| QLoRA / QOFT | 4 | 6GB | 12GB | 48GB |
| QLoRA / QOFT | 2 | 4GB | 8GB | 24GB |
同一份表也给出了边界:bf16 全参数微调 70B 要 1200GB 显存,这不是单机能扛的数字——想全参数微调大模型,先看这张表再排期。
小结
手上有卡、数据在手、又不想把时间花在环境上的个人和中小团队,从它起步最划算;已有成熟训练平台的团队,它的价值在快速试错和横向对比基线。几件事先说清:数据质量和标注一致性它一点不替你分担,这部分时间往往比训练本身还长;Windows 要先手动装 CUDA 版 PyTorch,FlashAttention-2 得自己编译;模型不在支持列表就要自己加 chat template;HuggingFace 直连不顺时切 ModelScope(USE_MODELSCOPE_HUB=1)。Apache-2.0、Python 编写,训练和推理必须用同一个 template(推理模型用带 _nothink 后缀的),结果前后不一致多半是这里没对上。