VLX-Flow:流式视频理解模型
VLX-Flow 是流式视频理解模型:视频按块处理、增量更新记忆,提问时直接从记忆作答。仓库目前只含文档和图片,权重尚未发布。
项目资料
GitHub Ecosystem- 许可证
- Apache-2.0
- 星标
- 188
- 核查时间
- 2026-10-10
以上快照资料以核查当日为准,可能随版本或运营策略变化。
很多视频理解模型把视频当成一个文件:整段读进去,分析一次,给出答案。摄像头、机器人和无人机的画面却是持续进来的,问题也可能在任何时刻出现。VLX-Flow 由 OmAI Lab 在 2026 年 6 月发布,它把输入切成连续的小块,每来一块就编码一次,并增量更新模型内部的记忆。用户提问时,模型从这份记忆里作答,不必把整段历史重新处理一遍。
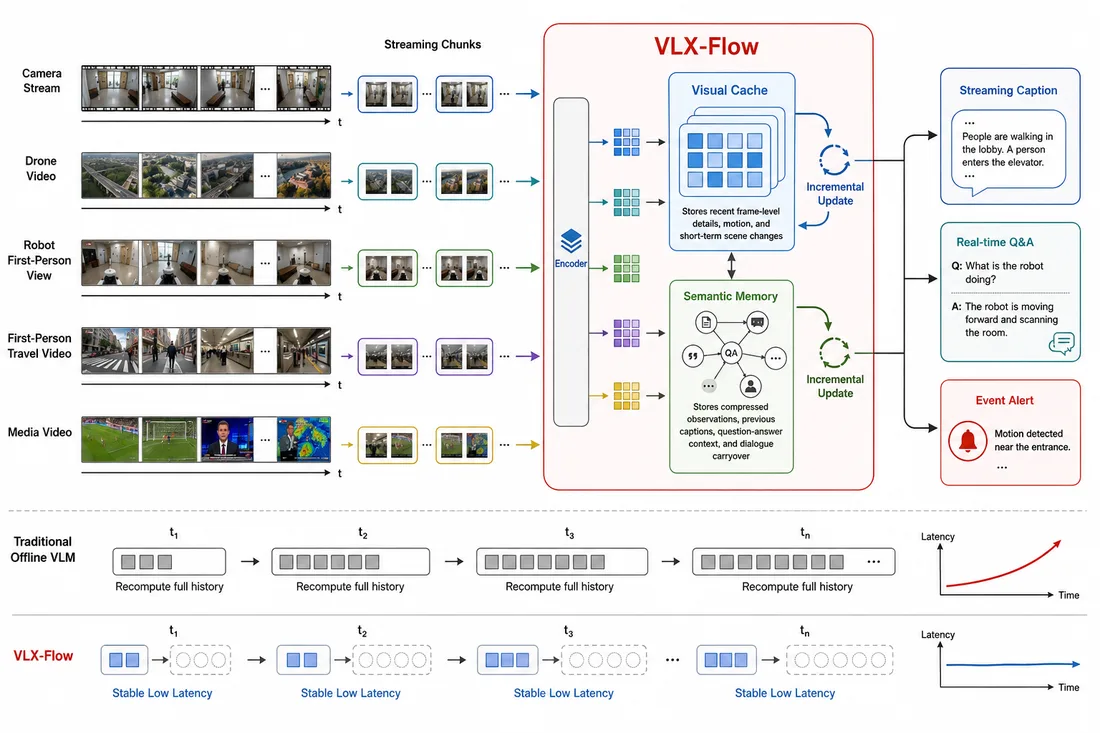
README 的总览图画的就是这条链路:分块输入、两层记忆、低延迟交互。
核心功能
- 流式分块:视频按时间顺序切成包含少量帧的连续块,逐块处理。已经处理过的历史不再作为原始帧反复追加,而是以压缩形式保留在模型状态里。
- 两层记忆:视觉缓存保存最近的帧级细节,用来即时回答和检测事件;语义记忆保存模型从视频流和对话中积累的高层上下文,包括流式描述、已有观察、用户问题和模型回答,让较长时间的叙事保持连贯。
- 线性注意力:语言模型包含 Linear Attention 组件。标准自注意力需要随序列增长维护一份不断变大的 KV 缓存,线性注意力则把历史保存在循环状态里,新块到来时增量更新,内存增长更平缓。
- 低延迟问答:问题到达时,模型直接从已经维护好的状态回答,不必为每次交互重算全部历史。
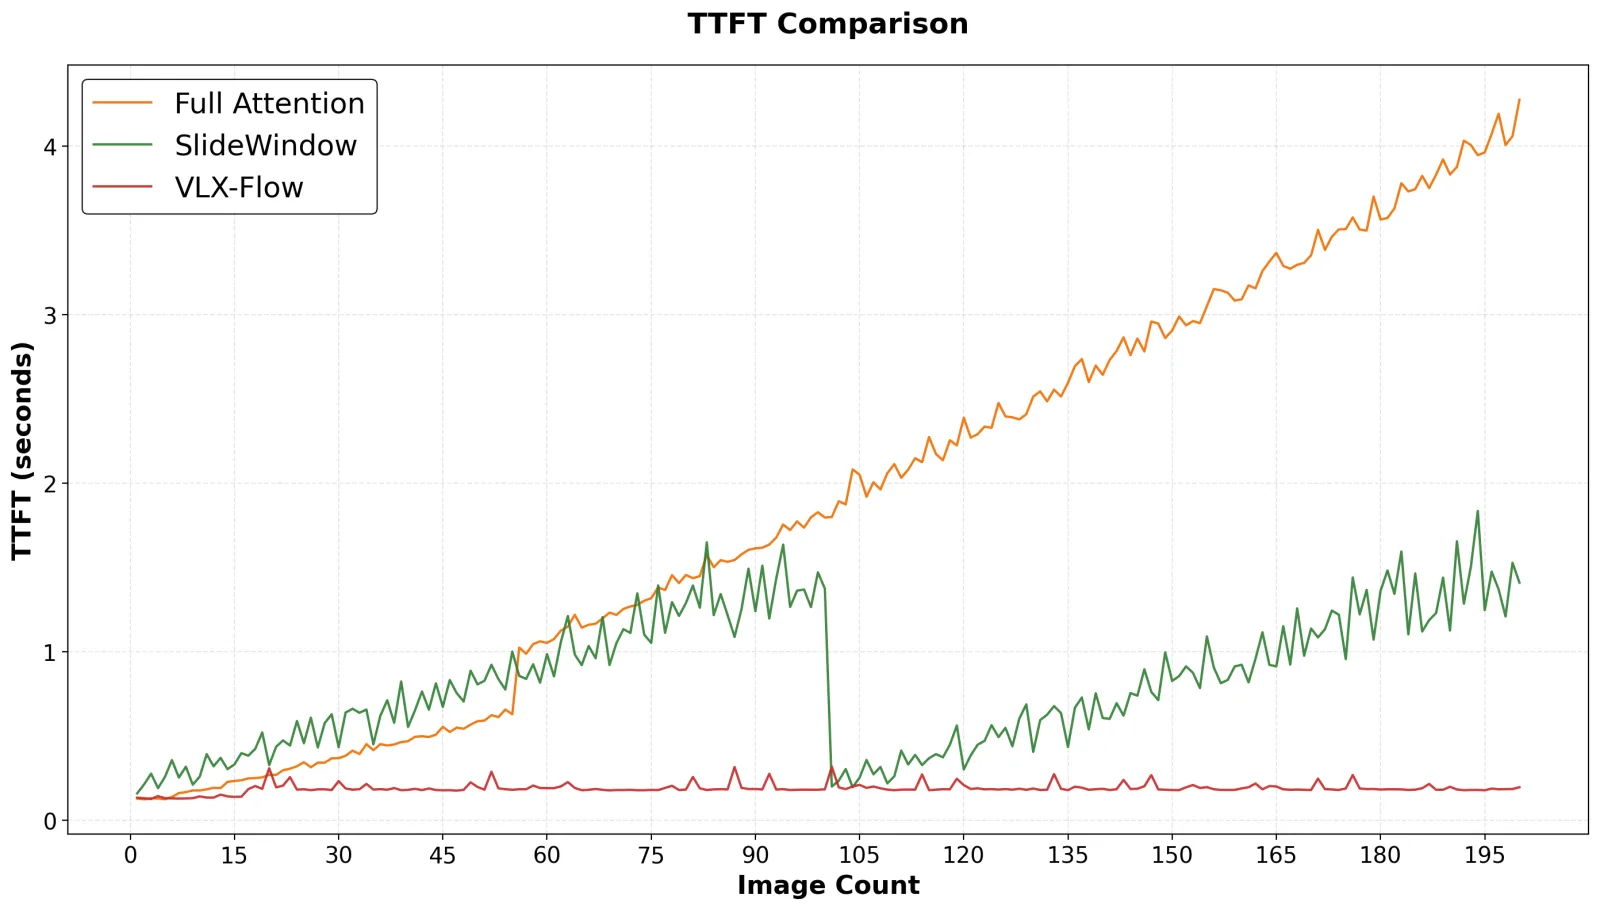
README 对这张图的描述是定性的:Full Attention 随历史变长而持续上升;SlideWindow 用窗口重置历史,曲线呈现“上升、重置、再上升”的锯齿;VLX-Flow 通过两层记忆压缩历史,首 token 延迟保持在低位且稳定。图上没有具体的毫秒数,README 也没有公布问答准确率,因此它说明的是设计取向,还不是性能结论。
典型使用场景
- 持续描述:一位需要盯着产线或仓库的工程师,希望随时知道刚才发生了什么。README 列出的“流式字幕”能力正对应这种持续描述。
- 边看边答:机器人或无人机在移动中接收画面,同时回答“前面那个箱子还在吗”这类随时可能出现的问题。
- 事件提醒:README 提到,当模型维护的状态满足某个事件条件时,可以扩展为告警。这是 README 中的方向性描述,仓库里没有对应的实现代码。
快速上手
这个仓库目前没有可以直接安装运行的内容。根目录只有 README、LICENSE、CONTRIBUTING.md 和 assets 图片文件夹,没有模型代码。README 的 Release 部分写的是 “Checkpoints: Coming soon”,权重尚未发布。想先看效果,可以走 README 里的 “Try VLX” 入口 om-agent.com,那是 OmAI 的开发者平台,页面标题写的是“VLX 端侧流式多模态模型”。等 Release 部分列出权重后,再回来看本地部署。
小结
适合关注实时视频理解、机器人和安防场景的研究者与工程师,尤其是想跟进流式多模态模型方向的人。不适合现在就想在本地跑起来的人:仓库没有代码,权重标注为 Coming soon,README 没有给出基准分数,也没有公布参数量和训练数据。仓库使用 Apache-2.0 许可,最后一次推送是 2026 年 9 月 24 日;星标数 188 与推送日期的核对时间为 2026 年 10 月 10 日。如果你现在就需要能用的视频工具,可以看 video-use,它让编码代理直接剪辑视频。