Unsloth 放出 DeepSeek-V4.1-Flash-1017 量化:Engram 查表挪去 SSD,64GB 内存也能跑
Unsloth 10 月 30 日发布 V4.1-Flash-1017 量化:196B Engram 查表移到 SSD 按需调页,128GB 内存可跑。
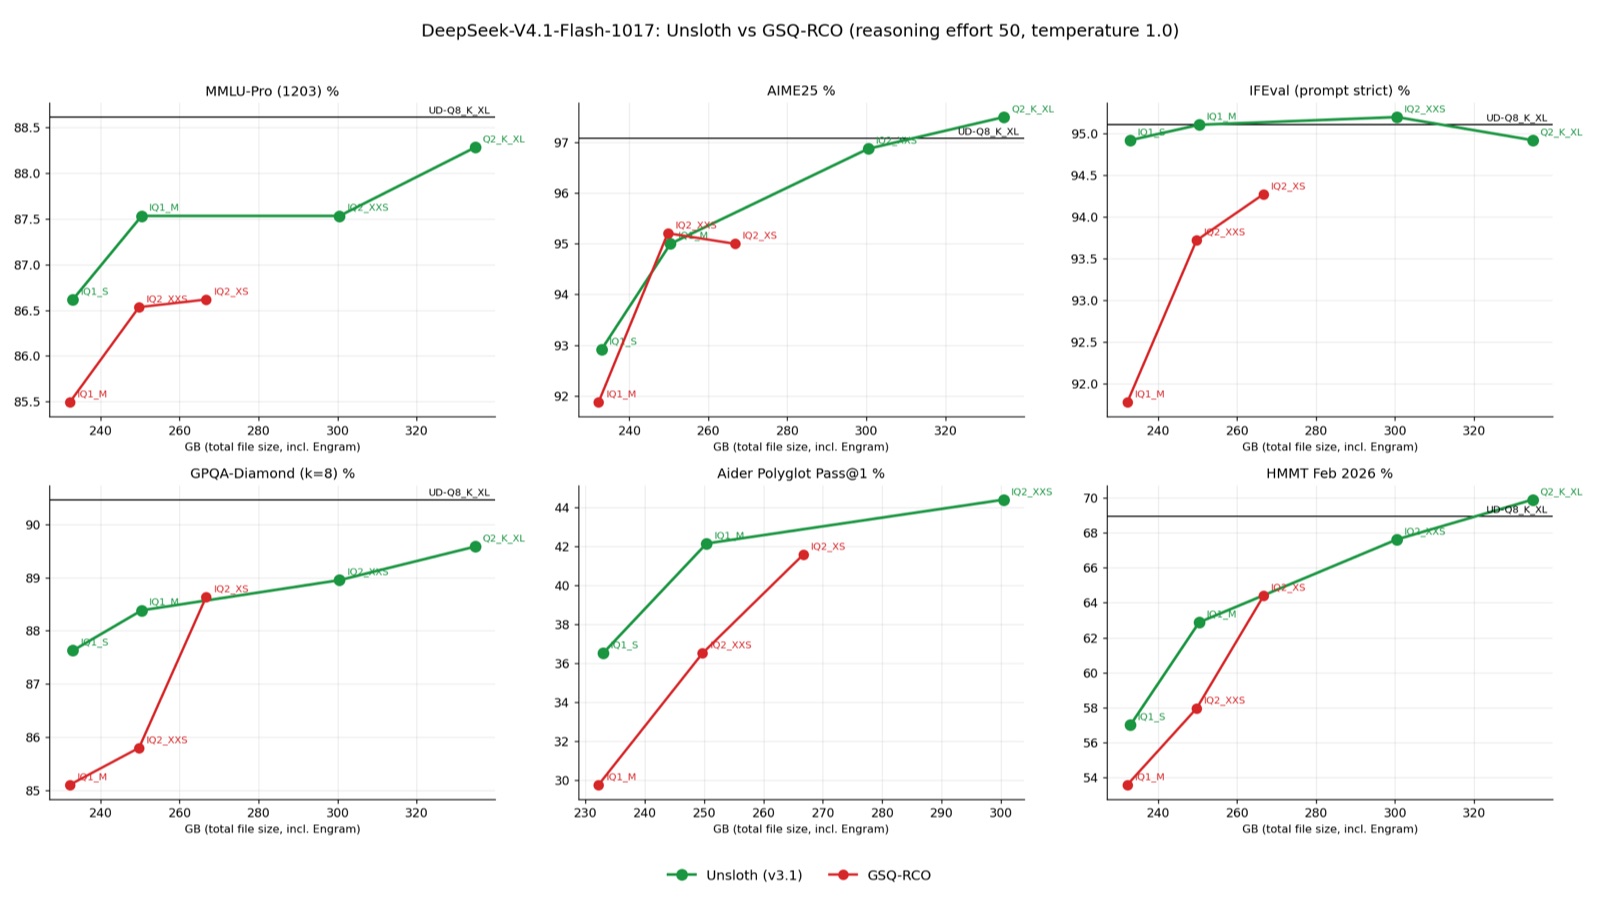
10 月 30 日,Unsloth 为 DeepSeek 十天前更新的 V4.1-Flash-1017(MIT、多模态、1M 上下文)发布了 Dynamic V3.1 GGUF 量化。这个模型号称 7,480 亿参数——Unsloth 的指南把它拆成 552B 主干加 196B 的 Engram 条件记忆层,而 Engram 是一张 n-gram 查表,可以整个留在 SSD 上用 mmap 按需调页。结果是无损档 UD-Q8_K_XL 在磁盘上占 508.4GB、Q4 档 500.7GB 的怪物,在官方口径下只需 128GB 内存即可运行(64GB「较慢」)——门槛从内存挪到了硬盘和耐心。
要点
- Unsloth 的 Dynamic V3.1 GGUF 覆盖 1-bit 到 8-bit(UD-IQ1_S 233.0GB 起),10 月 30 日上线,累计下载已超 42 万次(截至 11 月 2 日)。
- Engram 表 202.8GB(MXFP8 原始)到 110.6GB(IQ4_NL)可整表留 SSD,行按需进内存缓存;官方硬件表:8-bit 需 315GB RAM+VRAM,1-bit 128–145GB。
- HN 上 1017 发布帖 959 分 726 评,「a minor update」的自嘲式措辞与基准涨幅的反差是最高赞调侃。
背景
DeepSeek-V4.1-Flash 主模型 9 月 10 日发布,1017 是 10 月 17 日的小幅迭代,官方模型卡称在推理、编码、agent 与视觉基准上全面增强(Terminal-Bench 4.0 从 31.2 提到 42.3、Automation-Bench 从 54.8 到 60.5,对照表还列了 GLM-5.3、GPT-5.6 Sol 与 Opus 5)。本站 9 月曾报道过 V4.1-Flash 的发布与 HN 社区对其基准的热议。这次量化的关键在于内存布局:Q4 档仍然有 500.7GB,Engram 这张最多 4-gram 的 n-gram 查表(config 实证:两层、各约 3.84 亿条目、1600 万词表压缩嵌入)从「必须进内存」变成了「按需调页」。
事实部分
| 项目 | 数值 | 出处 |
|---|---|---|
| 参数构成 | 552B 主干 + 196B Engram | Unsloth 指南 |
| UD-Q8_K_XL(无损) | 508.4GB | Unsloth 指南与 HF 文件树实测 |
| UD-Q4_K_XL | 500.7GB(其中 Engram 分片 202.8GB) | 同上 |
| UD-IQ1_S(最小) | 233.0GB(含 110.6GB IQ4_NL Engram) | Unsloth 指南 |
| 内存要求(RAM+VRAM) | 1-bit 128–145GB;8-bit 315GB;64GB 可跑但「较慢」 | 官方硬件表 |
| 上下文 | 1M tokens,建议 max_tokens ≥256K | 官方模型卡 |
| Engram 精度可换 | MXFP8/Q6_K 161.3/Q5_K 135.2/IQ4_NL 110.6GB | Mix n match 指南 |
量化沿用 Unsloth Dynamic 3.1:Q4/Q8 档保留 MXFP4 专家权重与同一张 Engram 表,Q4 的非专家权重多为 Q8_0,Q8 用 BF16——所以 Q4 与 Q8 只差 8GB:省的位几乎不值钱,压不下去。推理需 llama.cpp 的对应 PR 或 Unsloth Desktop;官方称比其他 CPU/ngram 方案快至多 3 倍,另有 8GB DSpark 投机解码模块可再提速,低比特档还需为变长的思考过程预留更高的推理预算。
各方说法
HN 帖(959 分)里最高赞是 @freakynit 的 Padmé 梗:「这些基准不可能是真的吧?」;@jononor 的评论点出本地派的处境:「希望再见到更小的 flash 型号——本地跑这个太难了(成本很高)」,[@Pragmata] 则算了笔账:两台 DGX Spark 就能跑,按首发零售价约 8,000 美元硬件。对 Engram 路线本身,Unsloth 指南把 KLD 对齐数据放在了首页(Q8 对 wiki1100 的 top-1 一致性差距 0.3 个百分点),属于少见的给量化发质量账的做法;而 Engram 能否在长上下文高命中率场景保持 SSD 调页的吞吐,官方数据没有覆盖,这一点要等第三方复测。
量化生态的另一个参照系是 nvidia 10 月 30 日放出的 NVFP4 官方量化——那是面向数据中心 GPU 的路线,与 Unsloth 面向消费级内存的 GGUF 各走一端。想了解依赖同类 mmap 思路把大模型塞进小内存的消费级硬件,可回顾我们报道过的 GPU 解锁与 podroid 一类把系统装进余量资源的项目;企业侧把开源模型接进生产网关的部署形态则见 agentgateway。
编辑判断
对本地部署社区,这条新闻的实际信息是「瓶颈搬家了」:显存/内存预算表让位于硬盘容量和随机读速度,买内存条不如买 NVMe。对企业部署,128GB 一台 Mac Studio 能跑 MIT 权重的旗舰模型,数据不出门的合规场景有了新的价格锚点。诚实的代价是:64GB「能跑」与「能舒服跑」之间的距离没有量化数字,Engram 调页在长会话下的表现也只有官方单方说法;另外 508GB 的下载与磁盘占用对多数人仍是一次性的高墙。值得观察的下一步是 llama.cpp PR 合入主线的时间,以及 vLLM 系是否会跟进 Engram offload。