蚂蚁开放双向世界模型 Duo v1:边看边听,还能被打断
蚂蚁 Ant Research 开放双向世界模型 Duo v1:708 毫秒一块边看边听,可被打断;代码 Apache-2.0,权重许可排除美欧英韩。
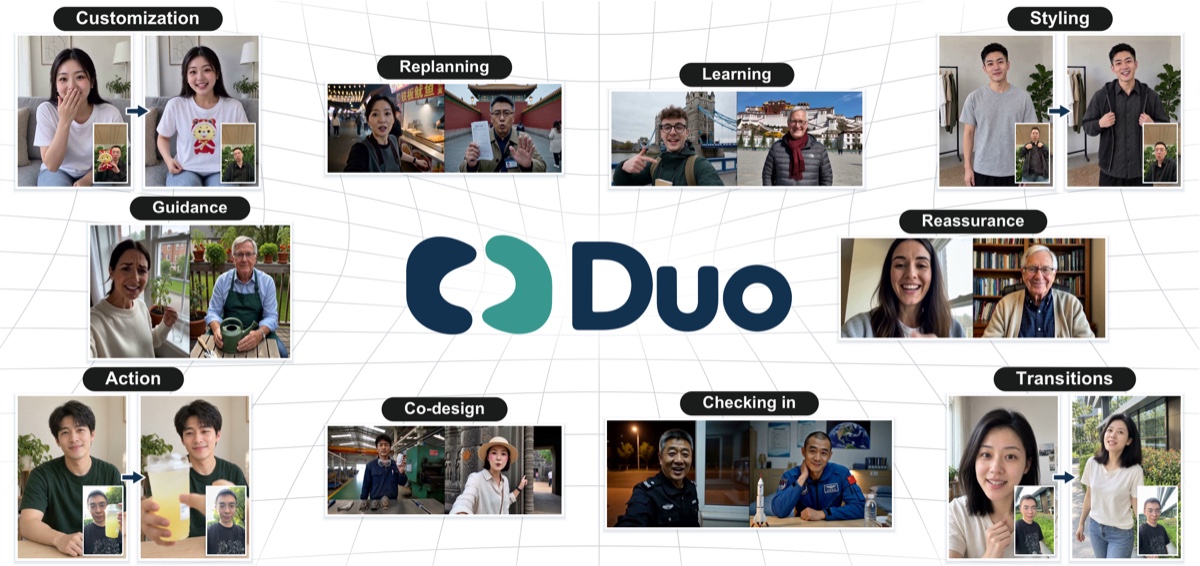
11 月 13 日,蚂蚁集团的研究团队 Ant Research 宣布开放双向世界模型 Duo v1:权重在 Hugging Face,推理代码在 GitHub 以 Apache-2.0 发布;论文 11 月 11 日已上传 arXiv(2611.15131)。Duo v1 把交互切成 17 帧视频、24 fps 下约 708 毫秒一块。每个块里,Intent 模块先决定这一块是说话(<speak>,附文本)还是继续听(<wait>),Realization 模块再把决定变成同步的音频和视频。团队称,用户说话时模型可以插话,也可以保持沉默,输入和输出不再排队。
要点
- 双向指的是两条流同时走:用户音视频持续输入,模型持续输出音视频,每 708 毫秒做一次「说还是等」的决策;对比对象是靠键盘、鼠标或文本指令驱动场景演化的世界模型,以及 ASR→LLM→TTS 的回合制数字人。
- 93.3% 是作者给自己打分:30 组案例 × 6 项标准共 180 项检查,168 项通过;语言一致性、语音可懂度、视觉身份稳定性 90/90,内容响应只有 22/30(73.3%),论文没有和任何基线模型做头对头比较。
- 代码和权重是两个许可:GitHub 代码 Apache-2.0;Hugging Face 上的四个权重仓库都是 MiniMax H3 社区许可,排除欧盟、英国、韩国和美国,且仓库只给推理代码,没有训练脚本或训练入口。
背景
世界模型这条线,主流做法是模拟物理世界:模型看过去的画面和控制信号,预测下一帧,用户通过键盘、鼠标、手柄或文字改变环境。我们此前报道过 Google DeepMind 的 Genie 4,它已经能原生出音频、在会话中改写场景,但交互仍是「用户下指令、世界给反应」。另一条线是数字人:ASR 转写、LLM 生成回复、TTS 合成语音,一轮说完再等下一轮。
Duo v1 想改的是这个接口。论文把「智能」和「物理现实」并列为世界的两个基础,提出 Reciprocal World Model(RWM,双向世界模型):世界里的角色要能持续感知用户,自己决定何时参与。Duo v1 是这个范式的第一个模块化实现,Intent 负责认知和参与决策,Realization 负责生成连贯的视听行为。
它不是从零训一个统一模型。论文写明 Realization 从 MiniMax H3 的权重初始化;第三方拆包(OrcaRouter)从仓库配置读出,Intent 是 Qwen3VLForConditionalGeneration,上面挂一个 rank 8 的 LoRA,并新增 <wait>、<blank>、<chunk_708>、<speak> 四个特殊 token。这套组合也解释了后面的许可问题:MiniMax H3 的社区许可跟着衍生权重走。
蚂蚁的开放权重线此前主要在大语言模型上。10 月我们写过 Ling-3.1-flash 以 MIT 许可开源,那次是文本模型;Duo v1 把同一套「放权重、放推理代码」的做法搬到了音视频世界模型,但许可条款完全不同。
事实部分
Duo v1 的核心是一个 708 毫秒的块时钟。论文第 1 节写明,交互按 17 帧视频分块,24 fps 下约 0.71 秒;第 6 节给出的采样窗口是 17/24 秒,即约 708 毫秒。每个块内,Intent 读取截至当前块的用户音频、视频和 ASR 文本,输出 <speak> 加文本,或 <wait> 不加文本;它的隐藏状态会传给 Realization,而不只是解码后的文字。Realization 是一个因果音视频扩散 Transformer,用流匹配联合生成音频和视频潜变量,注意力掩码保证当前块看不到未来输入。
训练分三段:先监督微调 Intent 的参与决策和文本,再训练 Realization 的因果联合生成,最后用双 Rollout 蒸馏把生成压到四步。第三段是关键:训练时 Intent 自回归生成助手回合(Language Rollout),Realization 以这些意图特征和自己合成的音视频历史为条件(Media Rollout),让训练条件和推理条件对齐。论文称,不做这一步,训练时用的是真实录制的助手文本和媒体历史,推理时却要用模型自己的输出,分布会对不上。
延迟数字来自论文第 6.3 节,对应 768×576 的生成分辨率:
| 环节 | 论文数字 | 说明 |
|---|---|---|
| Intent 单块推理 | 90–160 ms | 随输入和上下文长度变化 |
| Realization 联合生成 | 200–450 ms | 768×576,随上下文长度变化 |
| 传输与显示等开销 | 约 40 ms | 论文合计口径 |
| 单块端到端 | 330–650 ms | 不含首帧解码,也不含块边界等待 |
| 块边界采样等待 | 最多约 708 ms | 话语在窗口中途结束时 |
| 交互块 | 17 帧 @ 24 fps ≈ 708 ms | 论文第 1、6 节 |
机器之心的报道把 Realization 的生成分辨率写作 720p,论文的延迟表写的是 768×576;本文按论文数字。另一个容易被忽略的差别是硬件:论文的 330–650 ms 来自八卡布局,Intent 在 GPU 0–3 上做四路张量并行,扩散 Transformer 铺满八卡,流式 VAE 在 GPU 4–7 上分四块;README 的离线 demo 只要求两张 CUDA GPU,一张给 Intent 和编解码器,一张给 Realization。两个数字都是真的,回答的是不同问题。
权重和许可是这次发布里最需要看清的部分。Hugging Face API 显示,Duo-1.0-causal-base 与 Duo-1.2-causal-base 各约 153.46 GB;Duo-1.0-distill 是 2.79 GB 的覆盖包,Duo-1.0-distill-quant 是 47.03 GB 的 FP8 版本。四个仓库的模型卡都标 license: other、license_name: minimax-h3-community-license。许可正文把「适用区域」定义为全球减去排除区域,排除区域包括欧盟、英国、韩国和美国;这些地区的团队要另行联系 MiniMax。GitHub 仓库本身是 Apache-2.0,但那只覆盖代码。
评测在论文第 7.1 节。30 组实时双向交互案例,每组按六项二元标准打分:内容响应、语言一致性、语音可懂度、视觉身份稳定性、音视频同步、音视频情绪一致性。180 项检查通过 168 项,总体 93.3%。分项如下:
| 维度 | 通过率 |
|---|---|
| 语言一致性 | 30/30 |
| 语音可懂度 | 30/30 |
| 视觉身份稳定性 | 30/30 |
| 音视频情绪一致性 | 96.7% |
| 口型与语音同步 | 90.0% |
| 内容响应 | 73.3%(22/30) |
| 合计 | 168/180(93.3%) |
论文自己解释了内容响应为什么低:一类是笑话、怪话这类需要读出言外之意的长尾对话;另一类是只有把语音和画面合起来才能确定意图的情况。论文举的例子是用户坐在室内,说刚解锁了一辆共享单车就下雨了——模型建议「先别骑」,把它当成了求建议,而结合室内画面更合理的读法是抱怨。这个例子也说明,Duo v1 的短板不在生成质量,在「读懂人」。
至于「接住递来的水瓶」:它出现在论文 Figure 1 的 Action 场景和机器之心的开篇描述里,属于演示画面,不是定量实验。论文的评测协议没有针对物体交互的专项指标;项目页的 Moments 一栏也把一部分演示标为训练数据里的例子。把它当成能力方向可以,当成已测得的指标不行。
各方说法
机器之心 11 月 17 日的报道把 Duo v1 写成「蚂蚁团队联合西湖心辰」的成果,标题强调「两个世界彻底连上了」,开篇就是递水瓶和西湖昼夜切换两个演示。报道对架构和训练三段的梳理与论文一致,但没有提许可限制,也没有提评测是作者自评。
OrcaRouter 11 月 13 日的拆包文章给出了另一种读法。它统计出权重共 153.46 GB、80 个文件(Hugging Face API 现在算到 81 个),指出这次发布「没有 launch post、没有托管端点、没有定价页、没有独立基准」,并把许可称为「决定你这周能不能用」的部分。文章还点明,93.3% 是作者批改自己的试卷:有书面失败条件的二元评分表比排行榜 Elo 更可证伪,但评分人就是作者;论文里唯一的定量对比是数据合成的消融(60 秒序列到第九个 6 秒块时,基线掉了 34.2 个亮度级,方法稳定在约 99),没有和 Moshi、Qwen-Omni、Wan-Streamer 等做头对头。
论文自己的结论也留了余地:「Duo v1 仍是初步的,目前支持基础的音视频对话」,响应时机、长会话一致性和误解恢复都还需要更广的评测。团队把 v2 的方向写成「让 Realization 直接以用户音频和视频为条件」,也就是视觉交互——这恰好是「接水瓶」这类演示真正需要的能力。
两处口径需要说明。作者单位方面,论文首页只放了 Ant Group 的标志,没有单位行,正文也没有出现西湖心辰;机器之心的「联合西湖心辰」是媒体说法,论文本身没有这样署名。分辨率方面,机器之心写 720p,论文写 768×576。两处都不影响主结论,但引用时应该分清。
编辑判断
对做实时交互的研究者,Duo v1 值得读的是那个 708 毫秒的块时钟和「说还是等」的分离决策。多数音视频生成系统把「什么时候说」交给用户或固定轮次,Duo 把它变成一个每块一次的预测,再用因果掩码保证不进未来。这个设计可以迁移到别的模型上,哪怕你不跑 Duo。
对做数字人、陪伴或游戏 NPC 的团队,先看许可再看跑分。权重不是 Apache-2.0:美国、欧盟、英国和韩国不在授权区域内,这些地区的团队要另行联系 MiniMax;153 GB 的下载、两张 CUDA GPU 的离线门槛、八卡才有的低延迟,也都是排期时要算进去的成本。它没有托管 API,也没有推理服务商,想试只能自己部署。
有三点需要说清楚。第一,「世界模型」在这里指音视频交互模型,不是通用机器人模型:它输出的是语音、表情和画面,不是机器人动作或物理仿真状态,论文也没有机器人控制实验。第二,评测是作者自评,内容响应 73.3% 说明「读懂人」还是短板;没有第三方复测之前,93.3% 只能当团队内部口径。第三,演示和实测要分开:接水瓶、西湖昼夜切换是展示,论文的定量评测是 30 组案例的六项打分,两者不是一回事。
接下来值得盯三件事:有没有第三方按同一套六项标准复测;许可会不会加上被排除的地区;v2 的视觉交互能不能把「看到物体并回应」从演示变成指标。
怎么试
离线路径在 README 里写得很短。需要 Linux、Python 3.10+、FFmpeg、两张 CUDA GPU,以及两个独立的 Python 环境(qwen-asr 对 Transformers 版本有固定要求):
git clone https://github.com/inclusionAI/Duo.git
cd Duo
python -m venv .venv-model && source .venv-model/bin/activate
pip install -e '.[realization]'
deactivate
python -m venv .venv-speech && source .venv-speech/bin/activate
pip install -e '.[speech]'
deactivate
hf download inclusionAI/Duo-1.2-causal-base --local-dir weights
cp configs/inference.example.json configs/inference.json
.venv-model/bin/python run_demo.py --config configs/inference.json --port 4173
打开 http://127.0.0.1:4173/video/index.html,录一段或上传 MP4/WebM,等模型生成音视频回复。想要流式低延迟,README 指向 inference/vllm-omni-duo(推荐)和 inference/sglang-omni-duo 两个分支;论文的 330–650 ms 是那条路径的数字,不是离线 demo 的数字。