Manifold AI 的 R²SI 登顶 RoboDojo 智能体榜,内层就是它超过的 GPT-6 Astra
Manifold AI 的 R²SI 以 46.58 分登上 RoboDojo 智能体榜第一,内层即 GPT-6 Astra;主榜不含 Agent,权重未公开。
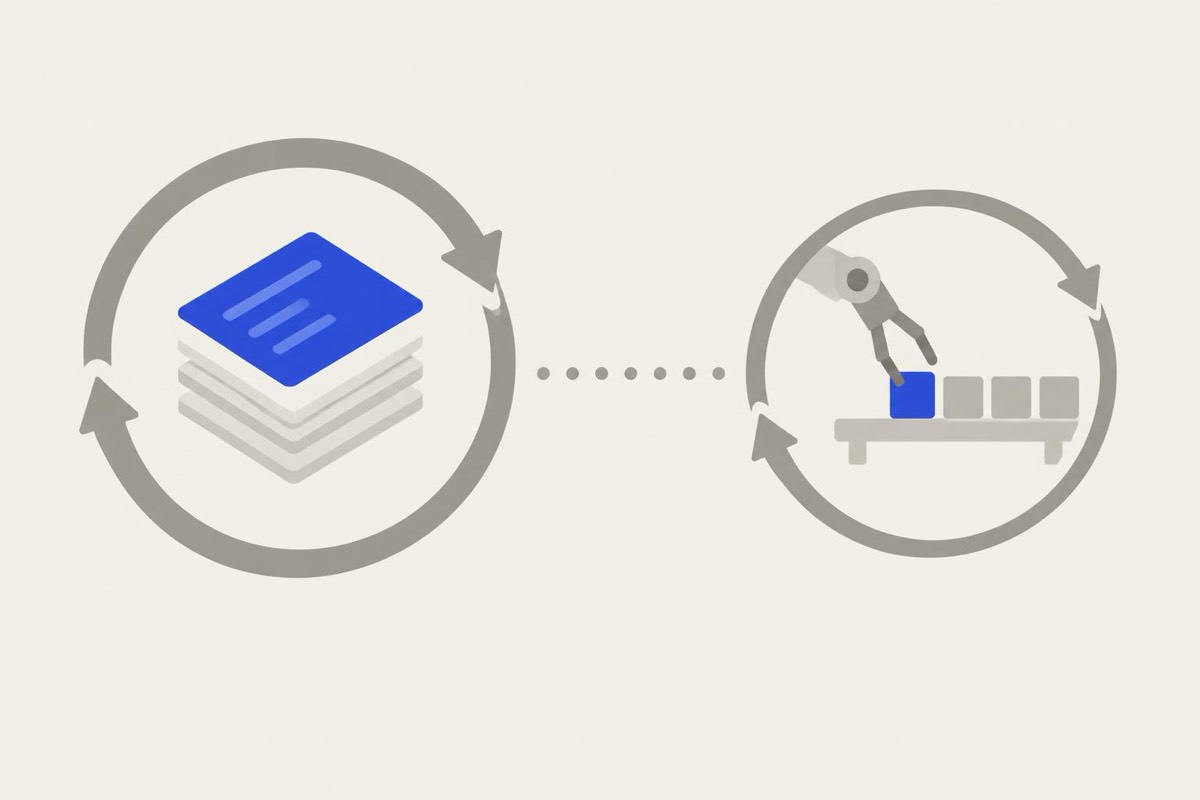
R²SI(Recursive Robot Self-Improvement,递归机器人自进化)是 Manifold AI(流形空间)的双层机器人智能体:内层 Robot Agent 执行,外层 Recursion Agent 复盘记录、改写技能、必要时再训练反应式模型。2026 年 10 月 17 日,RoboDojo 仿真榜把它以 46.58 分、39.35% 预算内成功率加进 agent 栏,排该栏第一。内层调用的 VLM 正是 GPT-6 Astra——榜单上那个 28.97 分、22.48% 的参考条目。
要点
- WorldScape R²SI 在 RoboDojo agent 栏拿到 46.58 分和 39.35% 成功率,比同一个 VLM 在参考 harness 下的 28.97 / 22.48% 高 17.61 分。
- 报告把 54 个任务变体分给两条路径:26 个走内层 Agent 的技能,25 个交给 Simate-beta,3 个交给 Manifold 自己的 WSP。
- 主表标题是「RoboDojo Sim Leaderboard (w/o Agent)」,agent 条目单列一栏;Manifold 的提交包自标
eligibility_status: "unverified",权重未公开。
背景
RoboDojo 是双臂操作基准:42 个任务分五组,另加 12 个随机布局变体,共 54 个。每任务有官方原生步数上限,如 align_blocks 200 步、swap_blocks 700 步,榜单按预算内的进度分和成功率排。运营方是非营利的 AI MMLab Club,隐藏布局做一致性检查,两端差距过大会被判无效。
这张榜入秋后换了几轮头名:9 月 16 日 GPT-6 Astra 以 28.97 / 22.48% 进榜,10 月 8 日 VPP2 到 39.26,10 月 14 日 EmbodiedEvo 到 45.08,10 月 17 日 R²SI 到 46.58。R²SI 在 agent 栏只领先 EmbodiedEvo 1.5 分,而后者进榜才三天。
GPT-6 Astra 那份成绩有另一篇论文可查:9 月 21 日的《An Unexpected Robot Policy》跑了 2,100 次试验,测出 22.48% 成功率——但这条榜单记录的贡献方也是 RoboDojo Team,算不上独立第三方复核。作者指出它的能力分布很偏——语义理解类任务好,精细控制与双臂协调差,这正是换 harness 可能补上的地方。
双层结构
内层 Robot Agent 只看头部与双腕 RGB、本体状态、任务描述和回合记忆,按任务加载 Skill 后决定下一步。调用反应式模型本身也是一项 Skill:模型执行一个动作块就交还控制权,Agent 依据新观测再决定下一步。
外层 Recursion Agent 跨轮次复盘记录,把失败原因写成一段 SKILL.md,交给测试门。判据是分数不降、每个验证回合都在步数上限内,通过才发布并记版本;对使用反应式模型的任务,外层还把记录整理成训练数据去更新模型。报告的 release 带 58 个任务 Skill(覆盖 24 个变体)、5 个 General Skill 和 6 个 MCP 工具包。
执行路径
报告 5.1 节写明:26 个变体由 Robot Agent 和它的技能执行,另外 28 个交给反应式模型——25 个给 Simate-beta,3 个给 Manifold 自己的 WSP。R²SI 比 Simate-beta 高 12.6 分,同时把近一半变体外包给了它。
这不算作弊,把任务分配给更合适的执行器本身就是 harness 的一部分,报告也把「选择执行路径」列为增益来源:put_bottles_into_dustbin 交给 Simate-beta 后从 35.3 升到 98.8,精细组从 12.65 提到 23.51。但它改变了 46.58 的含义——这是两种执行器加一套路由和技能库的组合成绩,不是「一个 VLM 加更好的提示词」的成绩。
WSP 是 Manifold 自己的世界动作模型,此前以 WorldScape Policy 2.0/2.5 发布,主打从一次示范做上下文学习。和杨立昆押注的 H-JEPA 世界模型路线相比,区别在用途:那边的世界模型支撑预测与规划,这里的 WSP 是被 Agent 调用的动作生成器。
改进机制
align_blocks 是报告里最细的例子:把薄尺推到与三个方块对齐再回原位,限 200 个原生步。起始技能走通用的「抓起并抬起」流程,8 个布局都没在预算内完成。外层连写四版——v1 张开夹爪推,8/8 完成但只有 2/8 在预算内,平均 215.1 步;v2 一次调用给出位姿与厘米级推,7/8;v3 撤回时先抬起再转腕,6/8;v4 在短推不动时降低接触高度,8/8 在预算内,平均 140.4 步。测试门拒了前三版,v4 自动发布,工具调用从 17.0 降到 12.3。
push_T 的数字要分开看。项目页和机器之心都给了 723 → 596 → 389 步(预算 600 步),项目页只写冻结后在 3 个随机布局上都成功,机器之心另给了 222、312、256 步。报告 PDF 里没有 push_T 这一组数字,正文案例是 align_blocks,所以那三个步数只能标「据机器之心」。
消融在报告表 5:换回参考 harness,25 个 xhigh 变体的 macro 分数从 56.3 降到 43.4;不做外层修订,align_blocks 从 8/8 掉到 0/8;去掉技能层,stack_blocks 平均步数从 215.5 涨到 370.5。成本一侧,xhigh 下中位回合 612 个原生步、380 万 token、15.6 分钟,97.4% 的 token 走前缀缓存。
榜单口径
同一个 46.58 有三种读法。主表标题的常量是「RoboDojo Sim Leaderboard (w/o Agent)」,agent 条目被过滤到另一张「RoboDojo Sim Agent Leaderboard」;混进主表时页面把它标灰、不给名次,并注明「Agent models are shown faded and unranked」。首页 Top 10 则按分数混排全部条目,R²SI 在最上面。
所以「总榜第一」只在首页混排和 agent 栏成立。去掉 agent 条目的主榜第一是 RobotEra 的 VPP2,39.26 / 32.26%。机器之心写的是「此次评测中,WorldScape R²SI 位列总榜第一」,这句需要按上面的口径加限定。
| 条目 | 类型 | 分数 | 成功率 |
|---|---|---|---|
| WorldScape-R²SI | agent-wam | 46.58 | 39.35% |
| EmbodiedEvo | agent | 45.08 | 38.95% |
| VPP2 | wam | 39.26 | 32.26% |
| PhysicalRSI | agent-vla | 36.27 | 31.38% |
| GPT-6 Astra | agent | 28.97 | 22.48% |
数据取自 RoboDojo 榜单 2026-10-17 的版本。拿 GROOT-N1.7 这类基线(2.85 分、1.31% 成功率)当对照说服力有限,真正有信息量的是同一个 VLM 在两种 harness 下的 17.61 分差。
RoboDojo 的协议还写了:没有评估用 checkpoint、实现、配置文件和复现说明的结果,「reported separately and are not considered verified leaderboard entries」。这条正好卡在 R²SI 现在的状态上。
各方说法
Manifold 自己的提交包把话说得很直。README 写「This is a draft integration, not a verified leaderboard release」,仍待完成的项目包括真实 checkpoint 调试、CUDA 运动规划、仿真器成功率、公开权重、eval-only 协议和技术报告链接。MANIFEST.json 里 official_single_entry_eligible 为 false;两个 WSP checkpoint 各约 25.27 GB,权重字节没有随包发布。上游 XPolicyLab 的 PR #162 从 10 月 11 日至今仍是 open,8 个 commit,0 条人工评论。
第三方对 R²SI 本身还没有复现或批评。Jay Chia 在 8 月 20 日的 Topic Queue 里统计了当时的 34 个策略:32 个成功率在个位数,前三名由实验室自己提交。他同时提醒榜单是刻意做难的,并把榜首模型权重零下载、许可证非商用单独拎出来。那组数字早于 10 月这批提交,更适合当方法学提醒,不是对 R²SI 的判断。
英文媒体这边,我用 Google News 搜了三组关键词(WorldScape R2SI、Manifold AI RoboDojo、R²SI robot),返回都是 0 条;中文只有机器之心一篇,搜狐和凤凰是同源转载。
编辑判断
对做具身智能的人,46.58 之外还有更实用的东西:R²SI 把「改进」放在可读写的文本层。技能是一段 SKILL.md,测试门是一组可复现的判据,版本可回滚,迁移成本远低于重训一个 VLA。想在自己的任务上试,先别急着搭外层 Agent——把失败原因写成检查项,给每次修改设一个不许降分的门,这两件事本身就能拿到一部分收益。
第二个可用结论是执行路径要显式选择。R²SI 有近一半变体交给 Simate-beta,说明「哪个任务用哪种执行器」值得单独调;一个强的反应式模型加一个会挑活的 Agent,比让一个模型包打天下更容易落进步数预算。
要打的折扣有三处。权重没公开、提交包自标 unverified、PR 还开着,所以能确认的是「分数被榜单收录」,不是「任何人按文档能复现」。xhigh 下每回合 15.6 分钟、380 万 token,离实时控制还有距离,97.4% 走缓存意味着真实账单高度依赖缓存命中。push_T 那三个随机布局的步数只有一个中文来源,报告里没有。
榜该怎么读,可以看一眼 Arena 的智能体榜:那张用真人会话和置信区间,这张用固定任务和官方步数上限,两者的「第一」不是同一种第一。