METR 四季度更新:任务时间跨度仍约 3.6 个月翻倍,判断类任务落后人类
METR 11 月 20 日的季度更新:任务时间跨度仍约 3.61 个月翻倍,可验证任务上最高约 27 小时,判断类任务仍落后人类专家。
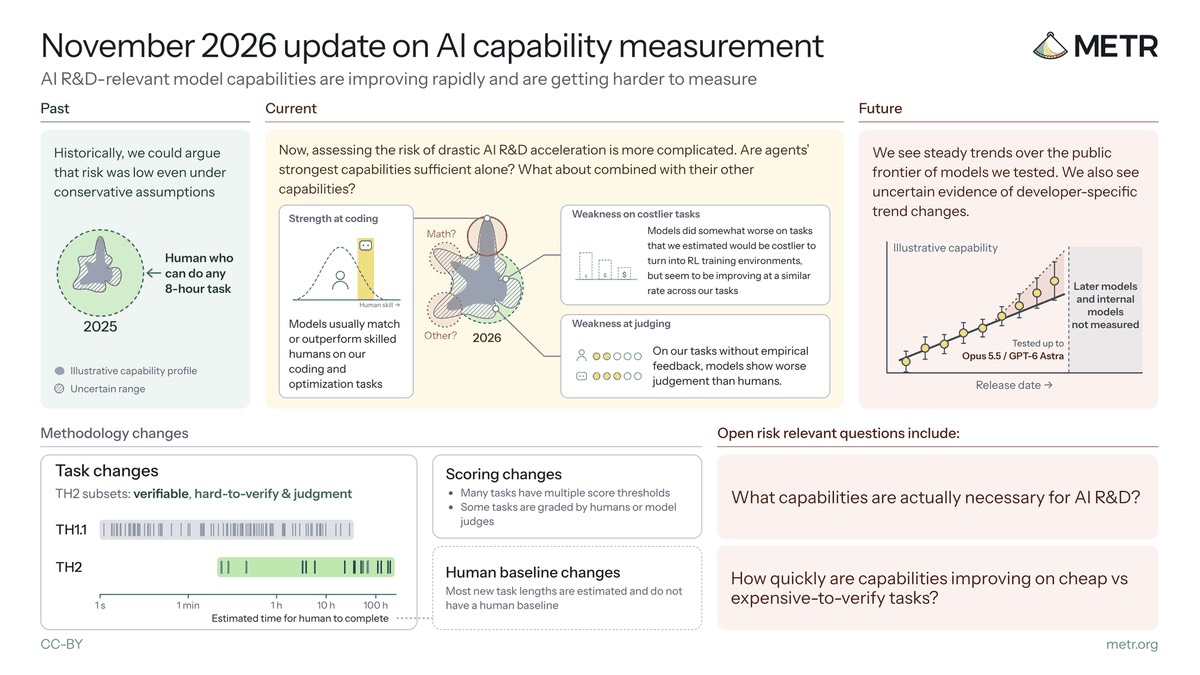
METR(Model Evaluation and Threat Research)是一家专做前沿模型独立评估的非营利机构。2026 年 11 月 20 日,它发布第四季度能力更新:把旧的 TH1.1 任务集和新建的 TH2 合并计算,模型的任务时间跨度(time horizon,指模型能以 50% 成功率独立完成的任务有多长,长度按人类专家要做多久来标)仍约每 3.61 个月翻一倍,95% 置信区间 2.08 到 4.94 个月。同一份报告里,METR 把「判断类」任务单列为主要结论之一:在没法快速验证对错的工作上,前沿模型还是不如人类专家。
要点
- 翻倍速度没有明显变化。 3.61 个月(95% CI 2.08–4.94),合 110 天,METR 称这与 TH1.1 此前 105 天的趋势「相近」。这是对合并任务集的新估计,不是对 2025 年那篇「约 7 个月」论文的修正。
- 可验证任务上最高约 27 小时。 在 TH2 的可验证子集上,当前公开前沿模型的时间跨度「最高约 27 小时」;只对这个子集拟合,翻倍时间反而缩到 1.65 个月(95% CI 0.79–3.99)。
- 判断类任务是短板。 36 项 TH2 任务里 5 项属于「难以验证与判断」类;给哲学论证打分、设计评估任务、评判别的模型造的任务,这三件事上公开模型的判断都偏离了人类专家给出的参照。
背景
2025 年 3 月,METR 提出用「人类做完要多久」给模型能力标刻度,在 50% 成功率口径下拟合出约 7 个月翻一倍。那套任务后来固定为 TH1.1:222 项,来自 SWAA、HCAST 和 RE-Bench,最长的约 30 小时。问题是这把尺子很快被做穿了——一年之内模型就把 TH1.1 做到饱和,到 2026 年,METR 想招一个在该任务上比模型更强的人类基线都很难。于是这次换了题:TH2,36 项任务、12 个任务族,8 个族可自动打分(优化、机器学习、解谜、游戏),4 个族属于难以验证与判断(概念推理、判断、难以验证的研究)。这也解释了为什么这份更新读起来不像「又涨了多少」,它更像一次换尺子:任务更难,同一模型在合并集上的时间跨度会比只看 TH1.1 时更低。
事实部分
METR 2026-11-20 更新里的关键数字:
| 指标 | 数值 |
|---|---|
| 合并 TH1.1 与 TH2 的 50% 时间跨度翻倍时间 | 3.61 个月,95% CI 2.08–4.94(110 天) |
| TH1.1 此前的翻倍趋势 | 105 天 |
| 仅 TH2 可验证子集的翻倍时间 | 1.65 个月,95% CI 0.79–3.99 |
| TH2 可验证子集上的 50% 时间跨度 | 最高约 27 小时 |
| 合并口径的 50% 时间跨度 | GPT-6 Astra 约 40 小时、Opus 5.5 约 39 小时(95% CI 分别 13–2645、12–1253) |
| 任务集最长的分数阈值 | 200 小时,按趋势外推约 2027 年 7 月达到 |
| 新增任务 | TH2:36 项,12 个任务族 |
| 测试模型 | 15 个,从 GPT-4o 到 Opus 5.5 与 GPT-6 Astra |
「27 小时」这个数要看清口径。METR 正文只说「最高约 27 小时」,没给置信区间,也没点名是哪个模型;同一批模型在合并口径上是 39 到 40 小时。两个数不冲突——TH2 的任务更长更难,同一模型在更难子集上的时间跨度自然更低。真正的警告在置信区间里:Opus 5.5 的 39 小时配的是 12 到 1253 小时,GPT-6 Astra 的 40 小时配的是 13 到 2645 小时。METR 在附录里解释过这种宽区间:当远端(长时间)的任务点很少时,逻辑拟合缺少信息去判断曲线该在哪里落下,点估计会被推长,区间也跟着撑开。名单里最新的 Anthropic 模型是 Opus 5.5,11 月 9 日发布的 Fable 5.2 还没进这轮测试。
这次还新增了一个指标:生命周期成本(Lifecycle Cost)。METR 的定义是「为一项任务搭出容器化环境,再把它跑一遍并打分 100 次」的估计成本,由一个 LLM 评审(Opus 5.5)读任务代码、README、说明和评分规则后估出,再用约 10 个跨领域任务校准到与 METR 自己的人估价大致相符。它想量的是「把一个任务做成可训练、可评估的环境有多贵」——人工评分、每次运行要占 GPU、串行时间长、token 消耗、行为监控、环境复杂度、与真实世界交互,都会推高这个数。METR 给出的换算关系是:任务长度不变时,生命周期成本翻一倍,大致相当于模型的时间跨度减半;按他们的数据,成本翻一倍会让模型达到 50% 成功率的时间推迟约 4.6 个月。在他们自己的任务集里,人类完成时间与生命周期成本的相关性 R² 为 0.82。
判断力缺口
METR 对「判断」的定义是:在缺少清晰、快速经验反馈时做出好选择的能力。四项判断类任务族一共 5 项任务,结果分三种形态。第一是打分任务 LMCA:模型要给哲学论证的批评打分,按与专家评分的吻合度计分;多数模型已经超过「专家花 5 分钟」的吻合水平,但所有公开模型仍低于「专家花 15 分钟」的水平。第二是造题任务 Making METR Tasks:让智能体设计一个 METR 会觉得有信息量的评估任务,结果是「没有一个任务好到值得收进这份报告」;模型偏爱造可自动打分的优化题,即使被要求做「成功取决于短期反馈很差的决策」的任务也还是这么选,有联网权限也没主动去搞清楚 METR 想要什么。第三是评审任务 Judge Run:让模型给别的模型造的任务打分,比自己弱的模型造的任务它评得准,对同等或更强的模型就明显偏高;与人类评分员最一致的评审者 Opus 5.5,给 GPT-6 Astra 的任务平均比人类高约 0.2(满分 1)。
METR 自己给了两条反向证据。其一,在程序化打分、长达数天到数周的机器学习任务上,模型能打赢他们招来的人类基线;P-Zero Research 的 TasteVal 也观察到类似结果。其二,模型在这些判断任务上「很可能没有被充分激发」,明显没用满给定的 token 预算和工具。所以这里的结论是局部的:差距集中在反馈慢、难以自动验证的那一类工作,不是「模型不会判断」。MIT Technology Review 补了一个变化的方向:Opus 5.5 在造题任务上已经到了 METR 所说的「勉强过线」,一年前所有模型都还在「明显不够格」。
各方说法
MIT Technology Review 给这张图的定性是「被广泛转发,也因指标复杂而被广泛误读」。它度量的是配对后的任务长度——人类要做多久、模型能否独立做完——不是通用能力分数;初版图里干脆没有难验证的任务,因为那类任务既难拿来做强化学习,也难评估。同一个数字在传播中还会变形:MIT TR 这次写的是「每四个月翻倍」,METR 2025 年的论文写的是约 7 个月;METR 在论文里写过,它有把握的只是「每年大约 1 到 4 次翻倍」这个范围,两个数字都落在其中。MIT TR 也提到,部分 AI 圈内人还在消化 METR 本月初那份大量删节的报告——它估计 AI 让 Anthropic 的研发提速约 1.9 倍,并由此引出「递归自我改进是否临近」的担忧;那份审计的细节本站写过。
外部评价集中在「能不能外推」。加州大学伯克利分校即将入职的计算机科学家 Sayash Kapoor 认为评估本身需要更有创造力,「把评估的空间往外推是值得欢迎的变化」;波士顿大学的 Najoung Kim 说,眼下的改善说明了当下,但「我还不太确定该怎么看待它的外推」。METR 技术员 Matt Putz 的回答更直接:难以验证或依赖判断的任务「本质上更难研究,尤其难量化」,他「不认为我们能建立像易定义任务那样干净、稳健的趋势」。
跨机构的对照也有一处。METR 指出,OpenAI 新公布的内部研究数据隐含约 3.8 个月的翻倍时间,与它的 3.6 个月接近;但 OpenAI 自己的措辞保守得多:1 月到 7 月,在有明确结果的各类任务上成功率普遍上升,而过去半年里,成功完成的 4 到 8 小时任务中有一半以上需要至少一次人工干预。一边说速度没变,一边说任务越复杂越需要人扶着走——两句话可以同时成立,只是描述的不是同一件事。
编辑判断
对做产品的人来说,这份更新最有用的信息不是 3.61 这个数,而是瓶颈挪了位置。能被自动打分的部分,模型的时间跨度已经是几十小时量级,继续在这里比分数意义不大;真正拉开差距的是那些没有快速反馈的环节——选哪个方向、砍掉哪个功能、判断一份输出值不值得信。这些恰好是 METR 实测出模型落后人类的地方,而不是凭印象的猜测。
这份报告的底座比数字看起来薄。36 项任务里只有 3 项拿到了真实的人类基线,其余 31 项的「分数—时间」点是研究者估的;METR 以 200 到 350 美元的时薪、总共约 9 万美元去招人,7 次基线尝试里,模型大多赢过了招来的人。27 小时这个数没有置信区间,合并口径的区间又宽到几乎不能用来做预测。这份报告也不该被读成「能力到顶」或「失效」:3.61 个月比 7 个月快,METR 的原话是能力仍在快速上升,变的是尺子和误差棒。
如果要从中拿走一样能用的东西,是生命周期成本这个换算:一项任务的生命周期成本翻倍,大致相当于模型的时间跨度减半。它给评估者一个可操作的预算语言——想让评估更接近真实研发,就得为人工评分、长串行时间、真实世界交互付钱,而这些成本过去从不出现在跑分表里。
接下来
三个观察点。第一,判断类任务只有 5 项,样本太小,METR 若扩大这块任务池,趋势能不能拟合出来才是关键——它自己说这类趋势大概不会像易定义任务那样干净。第二,OpenAI 的内部数据与 METR 的 3.6 个月互相印证,但两边的方法和口径都还没公开到可复现的程度,谁能先摊开数据,谁的说法就更站得住。第三,200 小时阈值按趋势外推是 2027 年 7 月,这个日期最该被反复检验:它建立在「翻倍速度不变」上,而 METR 对高成本任务的翻倍速度是否相同,明确说了「仍然不确定」。