中国 1.6T 开源模型 Nex-N2.5 登顶 BrowseComp,Agent 跑分超过 GLM-5.3 与 DeepSeek-V4
上海创智学院 2026 年 9 月 9 日开源 Nex-N2.5 系列,35B、397B、1.6T 三档权重全部为 Apache-2.0。官方对比表里,1.6T 的 Max 在 BrowseComp 以 92.6 分登顶,压过 Claude Opus 5 与 GPT-5.6 Sol;自动化与工具调用等 Agent 榜单上,Max 也高于 GLM-5.3 和 DeepSeek-V4-Pro。
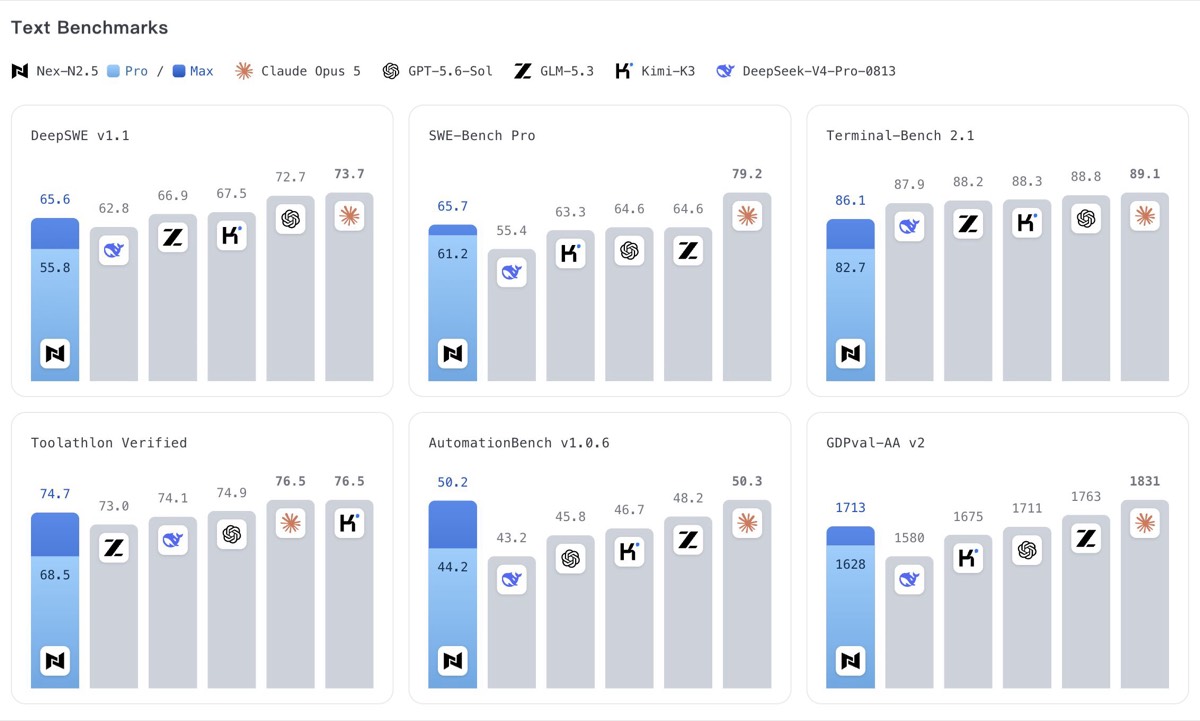
上海创智学院 2026 年 9 月 9 日宣布开源 Nex-N2.5 系列,含 35B 的 Mini、397B 的 Pro 和 1.6T 的 Max 三档,权重全部以 Apache-2.0 协议发布。Max 基于 DeepSeek-V4-Pro-Base 训练,官方称这是首次在万亿参数规模上完成完整后训练并开放权重;在官方对比表里,它以 BrowseComp 92.6 分成为全场最高分,超过 Kimi-K3(91.2)、Claude Opus 5(90.8)和 GPT-5.6 Sol(90.4)。
事实部分
- 三档规格:Mini 基于 Qwen3.5-35B-A3B、Pro 基于 Qwen3.5-397B-A17B,都是多模态 MoE,主打电脑操作、网页浏览与视觉反馈驱动的自我纠错;Max 基于 DeepSeek-V4-Pro-Base,是 1.6T 参数、激活 49B 的纯文本 MoE,面向复杂推理、编程与 Agent 任务。三档上下文窗口均为 256K。
- 背景:Nex-AGI 是上海创智学院联合上海奇绩智峰、模思智能、基流科技等机构与创业团队建设的能动性模型开源生态,上一代为 Nex-N2 系列。
- 许可与渠道:权重以 Apache-2.0 上传 Hugging Face 与 ModelScope,Mini、Pro 同时上架 OpenRouter 托管。
- 跑分:官方 README 与官网发布的对比表如下(2026 年 9 月 8 日更新;加粗为该项最佳,— 为无数据)。
| Benchmark | Mini | Pro | Max | Claude Opus 5 | GPT-5.6 Sol | Kimi-K3 | GLM-5.3 | DeepSeek-V4-Pro-0813 | Qwen3.8-Max |
|---|---|---|---|---|---|---|---|---|---|
| Terminal-Bench 2.1 | 73.4 | 82.7 | 86.1 | 89.1 | 88.8 | 88.3 | 88.2 | 87.9 | 86.6 |
| SWE-Bench Pro | 43.8 | 61.2 | 65.7 | 79.2 | 64.6 | 63.3 | 64.6 | 55.4 | 67.7 |
| DeepSWE v1.1 | 36.1 | 55.8 | 65.6 | 73.7 | 72.7 | 67.5 | 66.9 | 62.8 | 69.3 |
| AutomationBench v1.0.6 | 32.3 | 44.2 | 50.2 | 50.3 | 45.8 | 46.7 | 48.2 | 43.2 | 39.8 |
| Toolathlon Verified | 54.6 | 68.5 | 74.7 | 76.5 | 74.9 | 76.5 | 73.0 | 74.1 | 72.5 |
| GDPval-AA v2 | 1446 | 1628 | 1713 | 1831 | 1711 | 1675 | 1763 | 1580 | 1717 |
| Job Bench | 28.5 | 41.4 | 53.6 | 65.7 | 45.4 | 52.9 | 58.2 | 54.1 | 53.4 |
| BrowseComp | 83.4 | 89.7 | 92.6 | 90.8 | 90.4 | 91.2 | — | — | — |
以上为文本类榜单。多模态类:
| Benchmark | Mini | Pro | MiniMax-M3 | Claude Opus 5 | GPT-5.6 Sol | Kimi-K3 | GLM-5.3-Flash | DeepSeek-V4-Flash-Vision | Qwen3.8-Max |
|---|---|---|---|---|---|---|---|---|---|
| OSWorld-Verified | 71.2 | 82.2 | 75.2 | 83.4 | 83.2 | 84.8 | 62.3 | 76.7 | 86.1 |
| OSWorld-2 | 30.5 | 56.4 | 22.3 | 68.3 | 62.7 | 58.3 | — | — | 46.7 |
| WebTest | 48.6 | 52.8 | — | — | 54.0 | — | — | — | 52.3 |
| WebArena-Verified | 63.4 | 67.6 | — | — | 69.7 | 71.6 | — | 62.3 | 66.8 |
| OSWorld-G | 82.9 | 87.4 | — | 76.8 | 77.7 | 79.6 | 83.3 | 59.4 | 84.9 |
| Vision2Web | 52.9 | 68.2 | 59.0 | — | 79.8 | — | — | — | 75.1 |
| SWE-MM | 25.5 | 38.2 | — | 59.4 | 40.2 | 37.3 | 20.6 | 39.2 | 39.2 |
| OmniDoc | 89.7 | 92.2 | 91.6 | — | 92.9 | 91.1 | — | — | 92.1 |
- 关键对照:文本类里,Max 的 AutomationBench(50.2)与 Toolathlon(74.7)高于 GLM-5.3 和 DeepSeek-V4-Pro-0813;SWE-Bench Pro(65.7)、DeepSWE(65.6)与 GDPval(1713)超过 DeepSeek,但与 GLM 互有胜负;Terminal-Bench 2.1(86.1)和 Job Bench(53.6)落后两家。多模态类里,Pro 的 OSWorld-G 87.4 是全场最高。
- 部署门槛:官方提供内置定制 SGLang 的镜像
nexagi/sglang:v0.5.18-nex-patch——Mini 需 2×H100,Pro 需 8×H100,Max 需 2 个节点共 32×H200。推荐采样参数为 temperature 0.7、top_p 0.95、top_k 40;reasoning_effort支持不思考、自适应、强制思考三档。 - 评测口径:官方说明,有公开来源的对比分数取自各厂商报告(Kimi-K3、Qwen3.8-Max、GLM-5.3、HY4),其余为自测;电脑操作类榜单使用自研 NexCUA harness,该 harness 尚未开源。
- 演示案例:官方展示 Max 修复一块存在缺陷的 CRC16-CCITT 流式加速器 RTL,并跑通综合到 Sky130HD 布局布线全流程(报告 Fmax 约 386 MHz,Setup/Hold TNS 均为 0);Pro 则以 468 个以上动作打完《宝可梦 白金》第一枚道馆徽章,并在 Blender 里把概念图转成 58 个网格件的机甲模型。
编辑判断
在 agent 类任务上,这是中国开源模型第一次在硬核榜单上压过全部闭源前锋——至少在官方这张表里:BrowseComp 92.6 与 OSWorld-G 87.4 都是含闭源对手在内的全场最高分。但先看清口径:对比表以官方自测为主,部分竞品分数取自对方自己的报告,在第三方复现之前,这些数字只能算一面之词。
分方向看更接近实际:浏览器检索、电脑操作、自动化这些方向,Nex-N2.5 确实超过了 GLM-5.3 与 DeepSeek-V4-Pro-0813;回到传统编码任务就是互有胜负,SWE-Bench Pro 65.7 高于两家,Terminal-Bench 2.1 与 Job Bench 仍落后,离 Claude Opus 5 的 SWE-Bench Pro 79.2 还有明显距离。
门槛也摆在明面上:Max 是 32 张 H200 起步的东西,普通团队够不到。能上手的是 OpenRouter 上的 Mini 与 Pro,或自己用 2 张 H100 跑 Mini——拿它试试“开源基座能不能替代闭源 API 做电脑操作”,成本已经很低。
怎么试
- OpenRouter 直接调用
nex-agi/nex-n2.5-pro、nex-agi/nex-n2.5-mini - 权重下载:Hugging Face 与 ModelScope 搜
nex-agi/Nex-N2.5-Max、nex-agi/Nex-N2.5-Pro、nex-agi/Nex-N2.5-mini,均为 Apache-2.0 - 本地部署:官方 Docker 镜像
nexagi/sglang:v0.5.18-nex-patch,启动命令见仓库 README