Recursive 发布 Flint:40B MoE、Apache 2.0,AI 参与几乎整条建模链路
Recursive 10 月 21 日开源编程模型 Flint:40B 总参、2.5B 激活,Apache 2.0,模型卡自报 SWE-bench 74.2。
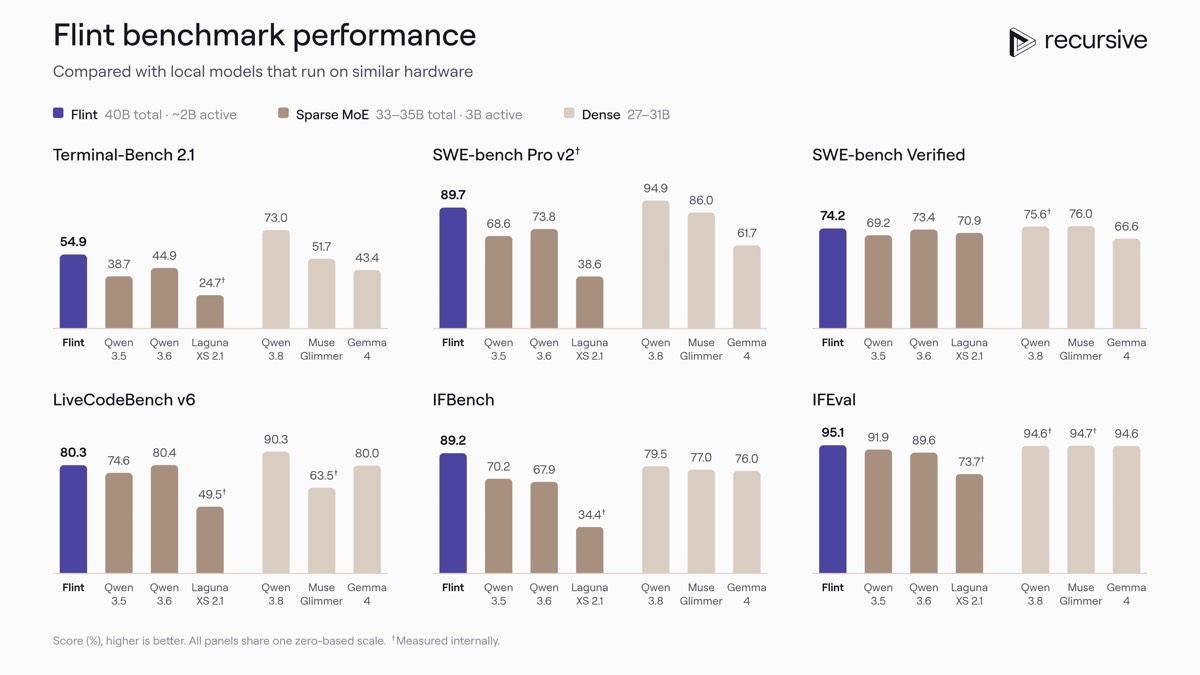
2026 年 10 月 21 日,Recursive 放出 Flint——一个面向编程智能体的混合专家(MoE)模型,39.8B 总参数(官方取整写作 40B)、每 token 约 2.5B 激活,权重以 Apache 2.0 挂在 Hugging Face,BF16 副本合计 79,570,574,912 字节(约 80GB)。公司说它由「一小队人和智能体」从零训练,用时不到四个月,自研的 Eureka Machine 参与了「几乎每一个环节」。这是 Recursive 的第一款模型,也是「用 AI 造 AI」这套主张第一次落到一份能下载、能自己跑的权重上。
要点
- 许可与体积:Apache 2.0,BF16 单副本约 80GB、要一张 B300 或 H200;同日上线的量化版有 NVFP4 GGUF 22.86GB、int4 GGUF 25.99GB、MLX int4 22.58GB,Ollama 的
flint标签 23GB、256K 上下文。 - 分数:SWE-bench Verified 74.2、Terminal-Bench 2.1 54.9、SWE-bench Pro v2 89.7,三个数都只写在模型卡和官方配图里;卡片脚注写明 † 表示 Recursive 自测、其余对照分数由各开发者提供。
- 口径冲突:发布贴称上下文「最高 512k」,建议留在 256k 以内;但
config.json的max_position_embeddings与模型卡都是 262,144,512k 没有任何实现说明。
背景
Recursive 由前 Salesforce 首席科学家 Richard Socher 带队,今年 5 月结束隐身,融资 6.5 亿美元、估值 46.5 亿美元。投资方名单两处略有出入:WIRED 写 Google Ventures、Greycroft、英伟达与 AMD Ventures,TechCrunch 用「包括」引出 GV(即 Google Ventures)、英伟达和 AMD Ventures,没有提 Greycroft,不构成矛盾。公司在 6 月 11 日发过 Eureka 的早期结果,主张用自动化的研究循环压缩模型开发;Flint 是这条主张第一次交出实物。
围绕递归自我改进的争论正在升温。WIRED 提到 9 月一名 Anthropic 研究员因灭绝风险辞职,国会多项提案试图禁止这类研究;本站 9 月 30 日记录过 Khanna 的《人类控制 AI 法案》,草案要求在监管机构批准前禁止递归式自我改进。Socher 对 WIRED 的回应是,造出 Flint 的这套系统不具备脱离人类控制的能力;Eureka 的长期目标仍是完整的递归自我改进,但仍由人监督,出问题时可叫停。
事实部分
Flint 的公开规格分两处:官方发布贴给结论,HF 模型卡和 config.json 给参数。下表按 10 月 21 日上线时的仓库内容整理。
| 项目 | 数值 | 出处 |
|---|---|---|
| 总参数 | 39.8B;BF16 权重合计 79,570,574,912 字节(约 80GB) | HF 模型卡、权重索引 |
| 激活参数 | 每 token 约 2.5B(含输出头),模型体约 2.2B | HF 模型卡脚注 |
| 层数 | 49:2 层稠密 + 47 层 MoE | HF 模型卡 |
| 专家 | 每层 256 个路由专家,每 token 选 6 个,另有 1 个常驻共享专家 | HF 模型卡 |
| 注意力 | 35 层滑窗(513 token)+ 14 层全注意力;32 个查询头、4 个 KV 头 | HF 模型卡 |
| 上下文 | 262,144(max_position_embeddings) | config.json |
| 词表 | 150,144;知识截止 2026 年 6 月 | HF 模型卡 |
| 许可证 | Apache 2.0 | HF 模型卡 |
| BF16 部署 | 单副本一张 B300 或 H200,配仓库里的 SGLang 套件 | HF 模型卡 |
跑分与口径
发布贴正文没有给出任何一个基准分数,只写「在 50B 以下总参数的 MoE 里领先」,并称能对标 25–40B 的稠密模型、速度是后者的五倍以上。74.2、54.9、89.7 这三个数出现在模型卡与官方配图里。评测设置写得比较细:Terminal-Bench 2.1 用 Terminus 2(XML),允许联网,但通过检索拿到的解算作失败;SWE-bench 两项用 mini-swe-agent、不联网;智能体任务超时上限 5 小时,至少 5 次取 pass@1 平均;采样参数 temperature 1.0、top-p 0.95、top-k 20。
| 基准 | Flint | 评测方式 |
|---|---|---|
| SWE-bench Verified | 74.2 | mini-swe-agent,不联网,至少 5 次平均 |
| SWE-bench Pro v2 | 89.7 | 同上 |
| Terminal-Bench 2.1 | 54.9 | Terminus 2(XML),允许联网,检索解算失败 |
| LiveCodeBench v6 | 80.3 | 单轮,5 次平均(官方配图) |
| IFBench | 89.2 | 单轮,5 次平均(官方配图) |
| IFEval | 95.1 | 单轮,5 次平均(官方配图) |
这些分数没有第三方复跑。模型卡的脚注原文是「† marks scores measured by Recursive; other comparison scores are developer-reported」。官方配图里 † 也落在部分对照模型上,比如 Qwen3.8 的 SWE-bench Verified 75.6†、Laguna XS 2.1 的 Terminal-Bench 2.1 24.7† 与 IFBench 34.4†、Muse Glimmer 的 LiveCodeBench v6 63.5†;没有 † 的对照分数则是各家开发者自报。表里混着两种来源,不能当作同一张考卷下的统一排名。
官方配图本身也划出了范围。发布贴的「领先」限定在「50B 以下总参数的 MoE」里,而同一张图把稠密模型单独列为一组(图注为 27–31B):稠密的 Qwen3.8 27B 在 Terminal-Bench 2.1、SWE-bench Pro v2、SWE-bench Verified 三项上分别是 73.0、94.9、75.6†,都高于 Flint 对应的 54.9、89.7、74.2;Muse Glimmer 的 SWE-bench Verified 是 76.0,也高于 Flint 的 74.2。TechCrunch 因此写道:按 Recursive 自己的六项平均,只有 Qwen3.8 27B 比 Flint 高。限定条件不是文字游戏,它决定了「领先」到底在和谁比。
上下文有一个对不上的地方。发布贴写「支持最高 512k token」,建议「留在 256k 以内」取得最好效果;但公开的 config.json 里 max_position_embeddings 是 262,144,模型卡也写 262,144,512k 没有任何实现说明。按现有权重,256K 才是能兑现的数字。
AI 参与了多少
「几乎每一个环节」是官方原话,全文没有任何百分比。可核对的是三件工程活:架构搜索,从 35B 总参、3B 激活的基线出发,让 Eureka 搜专家配置和宽度,定到 40B/2.5B;量化,把输出层 lm_head 压到 4 bit(官方说这与常见做法相反,因为 2.5B 激活里输出层占比大),再用自采样的 coreset 做离线蒸馏、以 16-bit 模型当老师,训练步数比常规量化感知训练少近一半;内核,为低比特投影、MoE、注意力和 prefill 写专用 kernel,在 M4、M5 上把整个 decode 前向融进一个 Metal megakernel。训练本身的信息很少:模型卡只说从零走完预训练、mid-training、SFT 和强化学习,没给 token 数、数据配比或算力规模。
速度实测
官方速度图给同一模型的不同硬件和推理路径各列了一组数,读的时候要连硬件和路径一起看。M4 Pro(图注 48 GiB)上,Flint 走 MLX 是短上下文 131.22 tok/s,128K 全程的归一化平均是 68.89;同机走 llama.cpp 只有 87.98 和 47.58。RTX Spark 上 NVFP4 版是 155.82 和 101.95。图注把「平均」定义为 128K 会话内的归一化 AUC,排除 prefill,短上下文指 1K 输入。
| 机器与路径 | 解码速度 | 来源 |
|---|---|---|
| M4 Pro 48 GiB,MLX | 131.22(短上下文)/ 68.89(128K 平均) | 官方速度图 |
| M4 Pro 48 GiB,llama.cpp | 87.98 / 47.58 | 官方速度图 |
| RTX Spark,NVFP4 | 155.82 / 101.95 | 官方速度图 |
| DGX Spark(GB10,128GB),NVFP4 GGUF + vLLM | 84.9–85.2(307 token 回复,含推理) | prestonlogan 的复现仓库 |
| M2 MacBook Air 16GB,路由专家从 SSD 流式加载 | 7.05–7.86(解码 256 token) | TurboFlint |
DGX Spark 与 RTX Spark 不是一台机器,前者是桌面盒子,后者是笔记本芯片,所以 85 tok/s 与 155 tok/s 不构成互相打脸;它说明的是「150+」有前提,换一台设备、换一条推理路径,数字会掉一半。
各方说法
WIRED 的 Will Knight 在 48GB 内存的 Mac 上做了几件事:命令行待办、一个抓取递归自我改进研究的爬虫、一个讲解 RSI 的静态站。他写道,这个尺寸的模型相比 Claude 或 Codex 常常又慢又容易出错,而 Flint「每次都答对」。这是定性手测,没有跑分,也没有同题对照。
TechCrunch 补了商业与竞品背景:它转述 Recursive 的测试,说 Flint 在 M4 Pro 上约 131 tok/s,对照的 Gemma 4、Nemotron 3.5 Lightning 等是 58–69 tok/s;按 Recursive 自己的六项平均,唯一更高的是阿里 Qwen3.8 27B。文章也点出,公司没说 Eureka 到底省了多少研究人员的时间。TechCrunch 还引述官方说法「低比特训练让模型缩小 71%、质量几乎无损」。体积这一半可以对上:两个仓库从 79.57GB 降到 22.86GB,减 71.3%;「几乎无损」则只有官方那句「NVFP4 与 16-bit 相差 0.7 分以内」撑着。
第三方工程侧有两份可读的记录。GitHub 上的 prestonlogan 把 NVFP4 GGUF 塞进单台 DGX Spark 的 vLLM,测到 84.9–85.2 tok/s、首 token 0.11 秒;他发现 Flint 的原生 kernel 在 sm_121(GB10)上全部失效或没有效果,Triton 的 NVFP4 GEMV 直接卡在 ptxas,只能退回 Marlin 和 FlashInfer;vLLM 的 Flint 支持仍是未合并的 PR #62938,他也标注了这一点。同一个仓库还记了一个更要紧的问题:提示约 37K token、挂 135 个工具时,Flint 经常漏掉必填参数(作者遇到的是 bash 的 description),温度设成 0 也漏,工具列表一小就正常。另一份是 TurboFlint,在 16GB 的 M2 MacBook Air 上把 1.3GB 共享核心常驻内存、21.3GB 路由专家从 SSD 流式读,解码只有 7 tok/s 量级,瓶颈是 SSD 的 2.3–2.5GB/s。
公开讨论目前还不多。Hugging Face 讨论区第 5 条(用户 Higen,10 月 22 日)标题是「与 Qwen3.6-35B-A3B 的五个实际任务对比」,正文只写「看起来仍落后 Qwen」,附了一条 YouTube 链接,没有数字,也没有官方回复。Hacker News 的发布贴到 10 月 22 日核对时是 21 分、2 条评论:一条希望下一代超过最新的 Qwen,另一条说从零训练能做到约 Qwen 3.8 27B 的质量、同时快这么多,已经不容易。榜单侧查了两处,都没拿到对照。Scale 的 SWE-Bench Pro 公开榜列了 25 条公开集成绩(榜首 Muse Spark 1.1 为 61.50),其中没有 Flint,89.7 也检索不到;tbench.ai 现在只挂 Terminal-Bench 4.0,打开 2.1 的榜址返回的也是 4.0 页面。89.7 和 54.9 目前没有可核对的第三方榜单。
编辑判断
对做本地或端侧编程智能体的团队,Flint 的吸引力在组合:40B 总量、2.5B 激活、Apache 2.0,官方点名支持 llama.cpp、Ollama、Unsloth、LM Studio、vLLM 和 SGLang,量化仓库同日给出 NVFP4、int4 GGUF 与 MLX int4 三种格式,23GB 的量化文件装得进 48GB 统一内存的 Mac。同尺寸模型里,同时给这个体量和这个许可证的不多,试错成本也低——一条 ollama run flint 就能开始。
对关心「AI 造 AI」的读者,这次能核对的只有工程痕迹:架构搜索、lm_head 的 4-bit 加蒸馏、专用 kernel 和 Metal megakernel。这些活确实通常由人做,但「几乎每个环节」没有比例、没有第三方审计,也没有训练日志。把发布稿当成递归自我改进的证据,是把主张当结论。
诚实的一面:三个主分数都是厂商自测,没有独立复跑;「笔记本上跑」用的是量化权重,原始 BF16 要数据中心卡;超大工具集下会漏参数;512k 与 config.json 矛盾。合理的用法是把它当一个 256K、可本地部署的编程模型来评估,先在自己的仓库任务上跑,再决定要不要替换现有工具。
怎么试
最快是 Ollama:ollama run flint,拉 23GB 的量化权重,256K 上下文。不想下载就用 OpenRouter 的 recursive/flint-v1.0:free(10 月 22 日核对时定价为 0)。要走官方路线,Hugging Face 仓库带 SGLang 服务套件(需要 B300 或 H200),另有面向 M4 Pro、M5 Pro/Max 的 rec 推理引擎;注意 BF16 仓库目前没放 Transformers 建模代码。想在 DGX Spark 上复现 85 tok/s,用 prestonlogan 的镜像,需要约 35GB 磁盘。同类机器的吞吐量级可以对照本站 10 月 20 日的 n8n DGX Spark 本地模型实测;想看「大模型上 Mac」的另一端,Meta 的 Muse Spark Open 是 816B、要 1TB 内存的参照。