StartLux-Decision v1.1 登顶社区版 Decision Index:69.12 分,173 个模型第一
StartLux-Decision v1.1 27B 登顶社区维护的 Decision Index:173 个模型第一,69.12 分,权重限非商用。
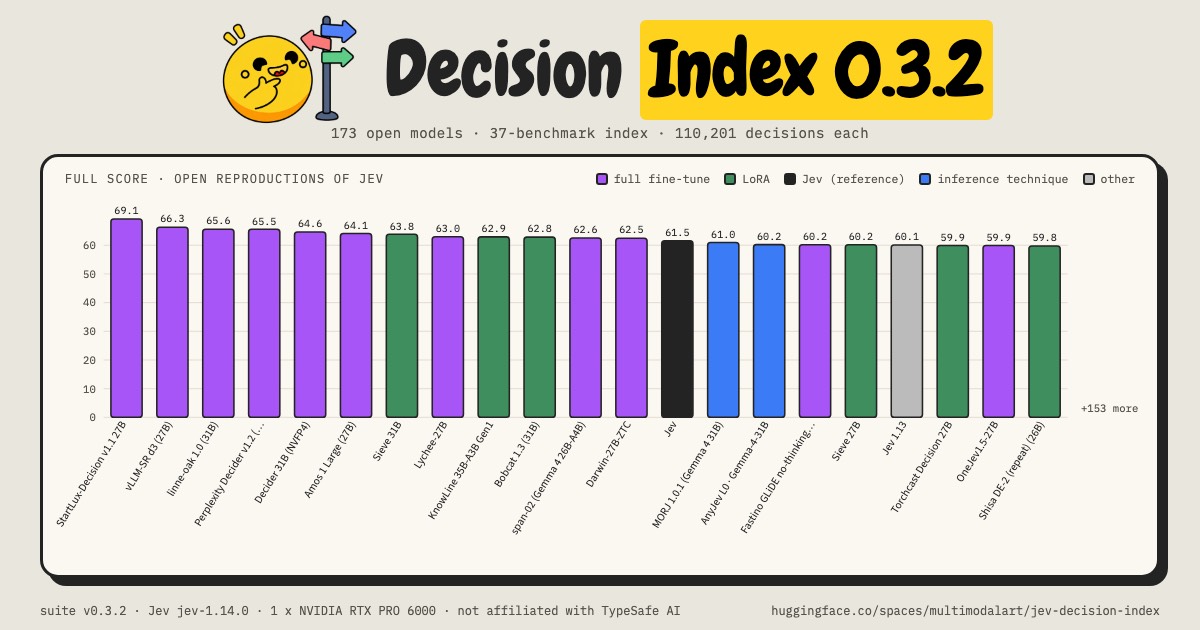
StartLux-Decision v1.1 27B 是一个 27B 参数、开放权重的决策模型:给它一段状态(文本、JSON,最多 8 张图)和若干带选项的问题,它在一次前向里返回每个选项的概率,不生成文字。10 月 16 日,Hugging Face 上一个社区维护的 Jev Decision Index Space 更新了 0.3.2 版数据,把它排在 173 个模型之首,Full score 69.12;第二名 vLLM-SR d3(27B)是 66.26,相差 2.86 分。
要点
- 三项分项全部第一:公开集 72.88、同技能私有测试 64.82、新领域私有测试 61.41,分别比各自第二名高 3.39、0.52、0.90 分。
- 69.12 是 173 行里唯一超过 69 的分数;Jev 1.14 作为参考行是 61.53,有 12 个模型排在它前面,Jev 1.13 是 60.11。
- 这份榜单挂在 Hugging Face 的 Space 上,README 写明「Unofficial and community-maintained; not affiliated with TypeSafe AI」;模型权重是 CC BY-NC 4.0,商用要找 StartLux Labs 单独授权。
背景
决策模型这条线是 Jev 在 9 月开的头:只做选择、不聊天,输出直接给程序读。两周内 OpenAI 和 Amazon 先后推出同类模型,亚马逊的 Strands Decider 2B 也在同一份榜上,得分 21.34,排第 135——它只有 2B,这个对比说明的是尺寸差距,不是路线差距。10 月 3 日我们写过决策模型成为独立品类,那篇讲的是品类形成与 TypeSafe 的估值,没有覆盖这张榜。
Jev Decision Index 走的是另一条路:一个维护者在 Hugging Face 上收公开复现,用同一套题跑所有模型。StartLux 在 10 月 14 日发布 v1.1,10 月 16 日被收进榜单,10 月 17 日 03:07Z 才在 README 的 release notes 里补上一句「ranks first of 174 entries」。
榜单怎么算
Jev Decision Index 0.3.2 的数据文件生成于 2026-10-16T16:39:08Z,Suite 里记着 42 个基准、37 个公开基准、110,201 条请求,其中 109,759 条计分。Full score 的公式是 0.20 × 公开 + 0.50 × 同技能私有 + 0.30 × 新领域私有,私有部分用未调优的通用模型映射回公开尺度。页头一处写「173 open reproductions」,另一处写「174 models」:多出的那行是 Jev 1.14 参考行,不在 173 条 models 数组里,两个数字都不算错。
| 指标 | StartLux v1.1 27B | vLLM-SR d3 (27B) | Jev 1.14 |
|---|---|---|---|
| Full score | 69.12(第 1) | 66.26(第 2) | 61.53(第 13) |
| 公开 | 72.88(第 1) | 65.45(第 5) | 60.70(第 20) |
| 同技能私有 | 64.82(第 1) | 62.83 | 59.28 |
| 新领域私有 | 61.41(第 1) | 60.51 | 55.60 |
私有部分由榜单方在单张 RTX PRO 6000 上、用作者提供的 serving 跑。StartLux 这一行与提交行的一致率是 99.85%(831 行),门槛 98.5%。榜单备注写「Submitted public 0.3 run adopted (kit rescore 72.88, equal to the claim)」:采用提交的公开集结果,复算值与提交值一致;模型卡自报的公开集成绩是 72.83。
173 行里,82 个是全量微调,37 个 LoRA,28 个 LoRA 加分类头,23 个是纯推理技巧,2 个属于「头部或适配器」一类,1 个托管 API。超过 Jev 1.14 那 61.53 分的有 12 个模型。
公开集也是开发集
这一行的折扣写在两处。论文 4.1 节自己写:「The public subset of DI also served as the development benchmark」,作者比较了第二阶段的数据配方、prompt 注意力变体和组成 Instant checkpoint 的种子平均,所以「these scores reflect model selection and are not independent test results」。模型卡的说法一致:72.83 是他们用公开 kit 自跑公开子集的结果,「not leaderboard submissions」。
榜单备注还多一句:公开 0.3 的分数影响了配方与种子平均的选择;按作者披露,训练数据覆盖 38 个索引基准中的 33 个,用的是官方训练集或同分布生成器。榜单当前 panel 是 37 个公开基准、42 个 Jev 基准,这里的「38」是作者口径,不是榜单项数。
拆开三项看,领先幅度并不均匀:公开集高第二名 3.39 分,新领域高 0.90 分,同技能私有只高 0.52 分,Perplexity Decider v1.2 的 64.30 就跟在后面。同技能测试考的是训练里见过的技能、没公开的题目,这一段差距最小,正好是「公开分进了开发流程」时预期会出现的样子。
各家怎么说
36氪同日也有一条快讯,抓取时被安全检测挡住,标题和正文都没读到,这里不引用它的表述。钛媒体同日的长文由「钛度号」作者 ITValue 供稿,文末注明了来源;它把事件写成「Huggingface 发榜」,这个说法要打折扣——榜单是 Space 维护者 multimodalart 在 commit b7e7ea6770 里直接提交的,时间 10 月 16 日 16:36Z,与 Hugging Face 官方无关。
同一篇长文给了两组对比,都需要注明口径。它说 27B AutoThink 的 73.37 比「Jev(hosted)57.96」高约 27%:57.96 是 Jev 1.13 的公开集分数,73.37 也是公开集分数,这是公开集对公开集;按 Full score,Jev 1.13 是 60.11,Jev 1.14 是 61.53。它还说起初代 27B 在 DI 0.2.1 拿 63.88、38 项里领先 31 项,但 Space 存档的 0.2.1 数据(生成于 9 月 28 日)里没有 StartLux 这一行,榜首是 Surogate Rune 26B-A4B v3 的 57.44,这个数字无法用榜单复核。
第三方榜单给的是另一幅图。Artificial Analysis 10 月 13 日另起了一个 Decision Index v1.0,Jev 1.13 以 58 分领跑决策模型,GLiDE 与 Microsoft-Decision-1 都是 54,那篇发布说明里没有 StartLux。Hacker News 上也没有这轮登顶的讨论,10 月 2 日那条「Decision Index 0.2.1」只有 4 分、0 条评论。Jev 创始人 Diogo Almeida 此前对量子位说过,公开 benchmark「极其容易被操纵」;TypeSafe 没有公开自家 benchmark,这个立场现在被别人的榜反过来检验。
许可与落地
StartLux-Decision v1.1 27B 的权重是 CC BY-NC 4.0:研究与非商业用途免费,商用需要 StartLux Labs 的单独授权;只有推理包是 Apache-2.0。这条写在模型卡 License 一节,排名和许可要分开看,开放权重在这里不等于可以直接商用。
按模型卡,BF16 在单张 H200、单请求下的中位延迟为:256 token 52 ms,1,024 token 98 ms,4,096 token 358 ms,8,192 token 737 ms。已知限制有两条:一次读取最多覆盖 26 个选项,更长的选项表要走分组;none_probability 是告警分,不是校准过的概率。
上手三步:git clone 仓库,pip install -e '.[vllm]' 装推理包,再用 startlux-decide serve --model <本地权重目录> --launch-vllm 起服务。请求打到 /v1/systemone,格式与 System One 兼容;think_mode 设成 auto 或 always 会返回 422,Instant 版本只做单次读取。
编辑判断
这条新闻对两类人有直接用处。一类是做路由、分诊、审核这类「从固定选项里选一个」的团队:69.12 的 Full score 里 80% 来自第三方拿不到的私有测试,这个结构和公开集分数相比更能说明泛化。另一类是正在比较决策模型的采购方:同一份榜上,Jev 1.14 的 61.53 已经被 12 个模型超过,价格和许可的分量会上升。
折扣也要一起带走。公开集参与了配方与种子的选择,同技能分项只领先 0.52 分,两项都指向「真实优势比 2.86 分小」。CC BY-NC 4.0 把商用挡在门外,想落地的团队要么谈授权,要么继续用 Apache-2.0 的推理包配别的权重。至于「Hugging Face 榜首」,准确说法是「Hugging Face 上一个社区维护的 Space 的榜首」,这两句话的可信度不一样。
还没有答案的是这份榜本身的稳定性:它由 Space 维护者按 PR 收条目,模型行随版本重排,10 月 16 日当天就改过一次模型名。今天的第 1 名,下周可能连对比基准都换了。