AudioScript:系统声音实时转双语字幕,全程离线
AudioScript 声稿监听系统声音或麦克风,sherpa-onnx 本地识别加 opus-mt 本地翻译,中英双语字幕悬浮在屏幕上,离线可用。
项目资料
GitHub Ecosystem- 许可证
- MIT
- 主语言
- Rust
- 星标
- 172
- 核查时间
- 2026-10-23
以上快照资料以核查当日为准,可能随版本或运营策略变化。
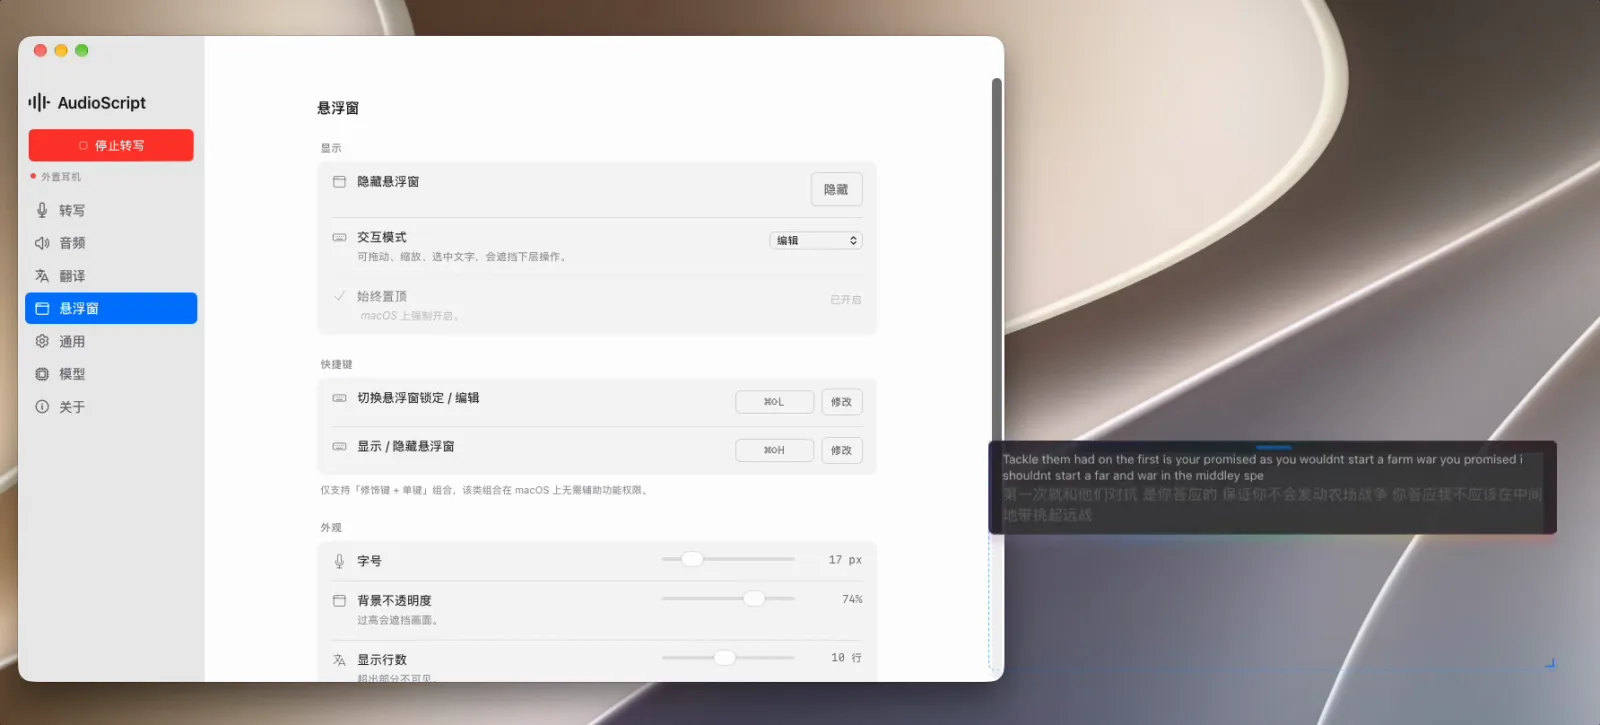
看没有字幕的英文视频、开没有同传的英文会,办法通常只有两条:把音频丢给云端转写服务,或者凑合听。AudioScript(中文名「声稿」)是 niyongsheng 开源的一个桌面应用,MIT 许可,Rust 加 Tauri 2 写成:它直接监听电脑的系统声音或麦克风,用本机模型实时转成文字再翻译,以「英文原文 + 中文译文」的双语字幕悬浮窗叠在屏幕上,语音和文本都不出机器。仓库创建于 2026-10-14,十天后就有 172 颗星,GitHubDaily 也推荐过它。截至 2026-10-23,最新版本是 v0.2.10。
核心功能
- 三种采集来源:系统声音、麦克风,或两者混合。会议场景选混合,对方的声音和你自己的发言都进转写;官网写明 macOS 走 Core Audio Process Tap、Windows 走 WASAPI loopback,不需要装 BlackHole 之类的虚拟声卡。
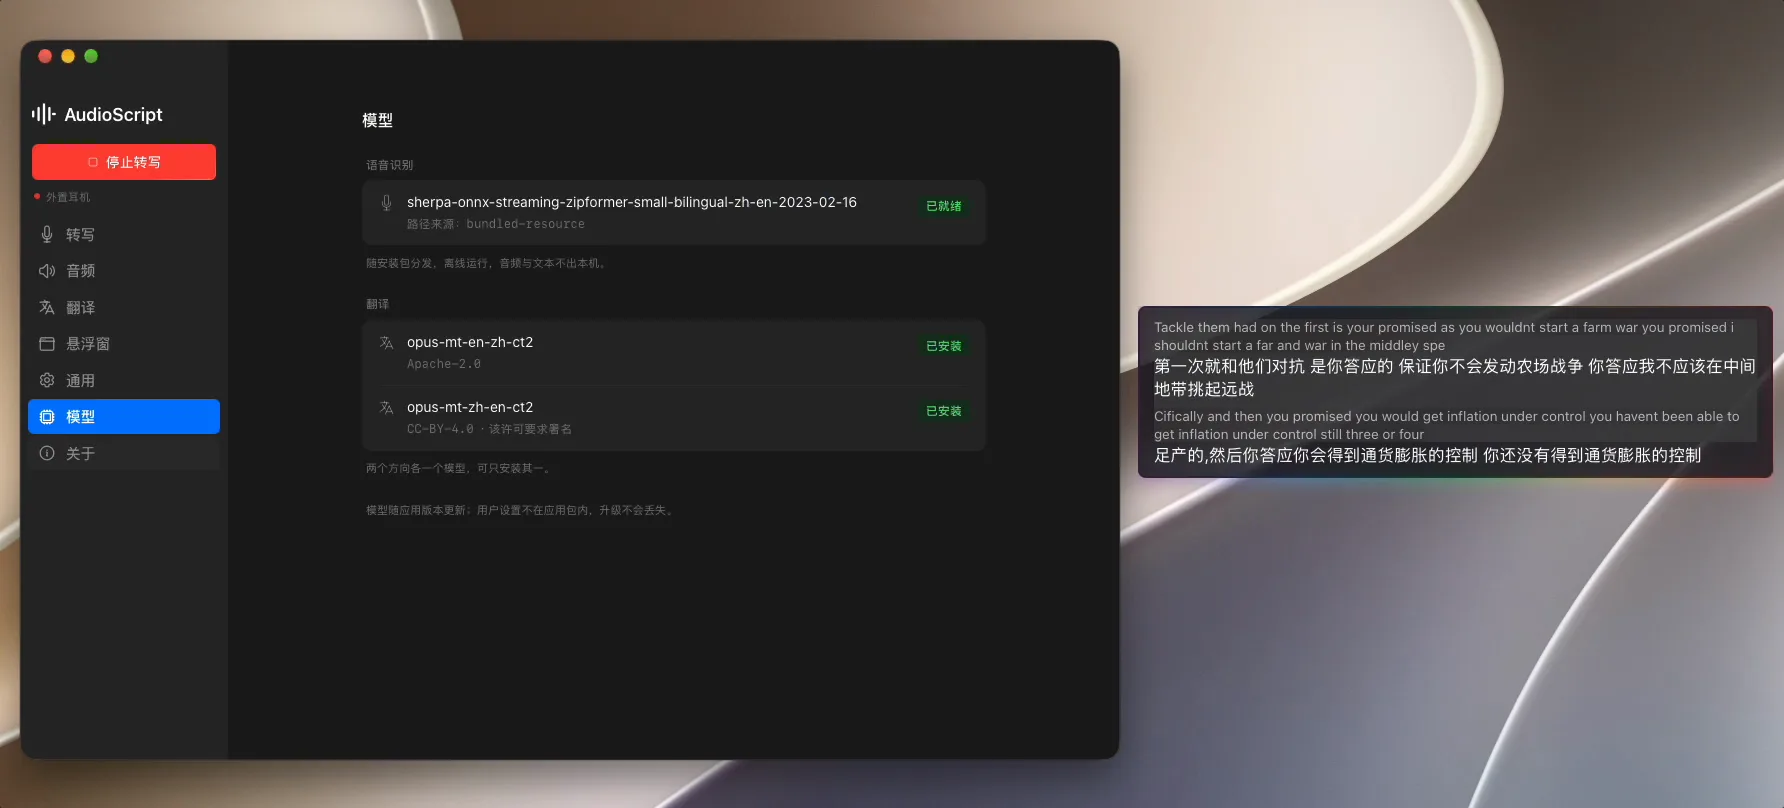
- 识别翻译全在本机:流式识别用 sherpa-onnx(应用自带的模型是 zipformer 小型中英双语版),翻译用 CTranslate2 跑 opus-mt,官网给出的单句翻译耗时是 70–77 毫秒(M 系列芯片)。运行时不需要网络。
- 中英双向、手动切向:识别和翻译固定在 en ↔ zh 这一对上,方向自己在应用里选,没有自动语言检测。两个方向的翻译模型各约一份,装哪个用哪个。
- 悬浮窗可调:字号、背景不透明度、显示行数都能调,锁定时可穿透点击,不挡下面的视频;应用常驻托盘,关窗不退出,还能开机自启。
- 字幕可导出:转写结果能存成带时间戳的 Markdown,看完一场会或一期播客,文字稿直接拿走。
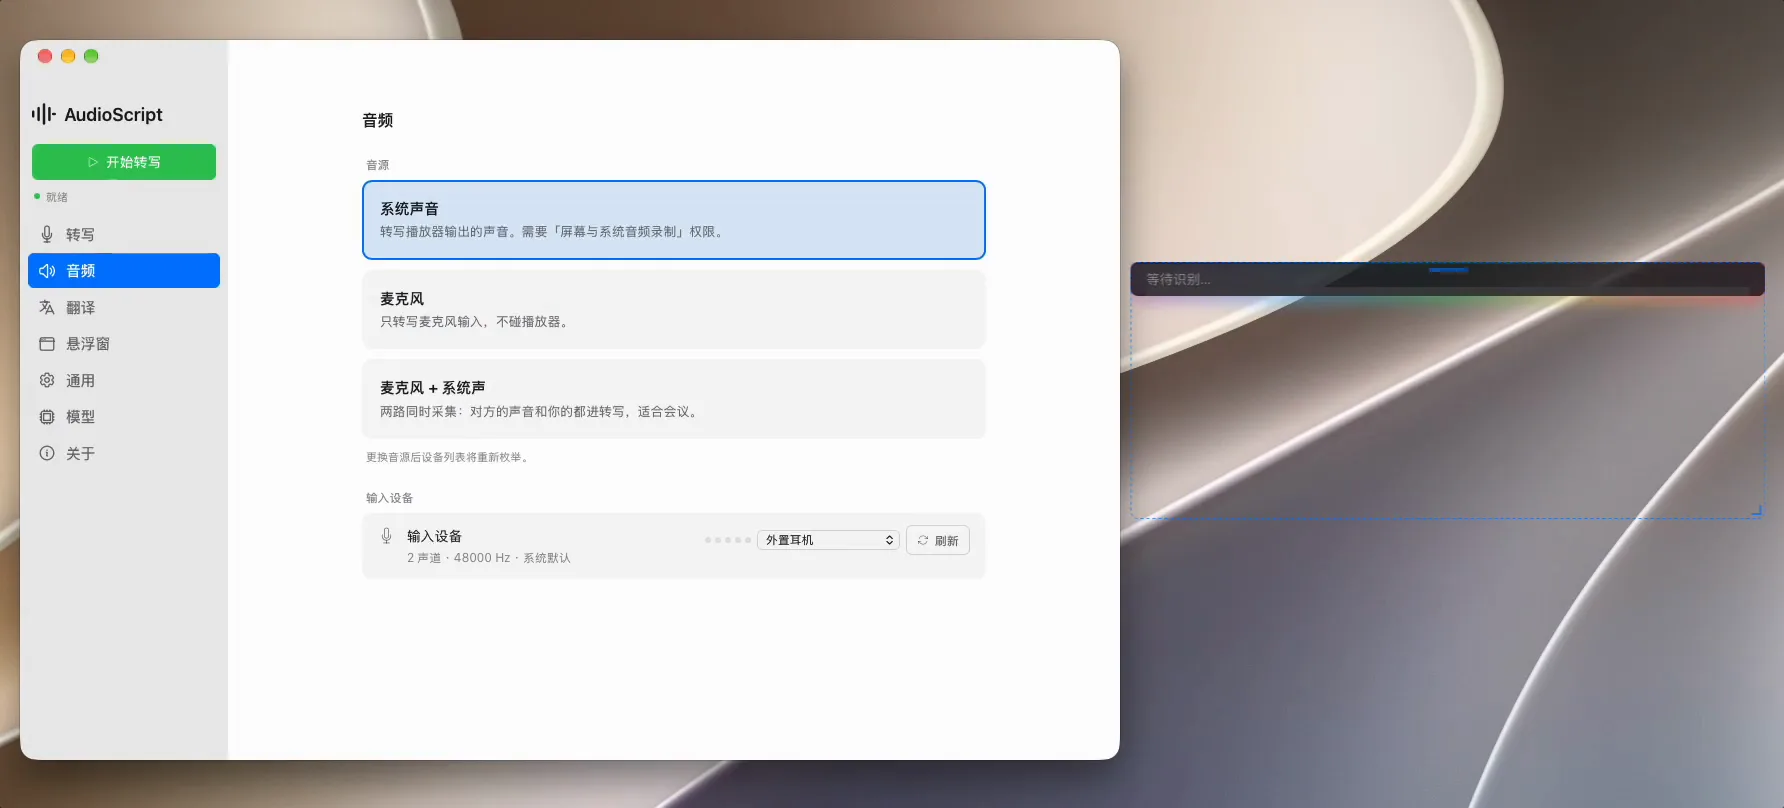
典型使用场景
- 看生肉视频:没有内嵌字幕的英文视频和直播,字幕悬浮在画面上,原文对照译文,不用暂停去查词。
- 开线上会议:选「麦克风 + 系统声」混合采集,双方发言各自转写翻译,会议软件不开字幕也能跟。
- 听英文播客:挂着字幕窗边做事边听,漏掉的句子回头看一眼;要引用哪段,事后从导出的 Markdown 里找原文。
快速上手
不用自己构建:GitHub Releases 里直接下安装包——macOS 是 14.2+ 的 Apple Silicon .dmg(官网注明暂无 Intel 版),Windows 10+ 有 .exe 和 .msi,Linux 提供 Ubuntu 24 的 .deb 和 AppImage。装好后给 macOS 授予「屏幕与系统音频录制」权限,选好采集来源点「开始转写」,右下角就会出现悬浮字幕窗。想从源码构建的话,README 的流程是:
pnpm install          # 依赖 + ASR 模型(约 58 MB)
pnpm fetch:mt         # 拉取翻译模型
pnpm tauri dev        # 开发模式
pnpm tauri build      # 打包
小结
AudioScript 适合需要中英双语实时字幕、又不想把语音交给云端的人:生肉影视、国际会议、播客都覆盖。它不适合跨语言场景——语言对固定在英语和中文之间,日语、欧语内容不在能力范围内,也没有自动语种检测。
更准确的预期是:它对标的是讯飞同传那类云服务,换来的是免费和隐私,代价是识别精度。悬浮字幕里出现的那句英文「Tackle them had on the first…」就是演示视频里的真实输出——专有名词、口语和快语速下,small 级别的 zipformer 模型会转错词,翻译也跟着歪;要更准得换更大模型,而它目前只内置这一款。另外 Linux 是二线支持,GNOME Wayland 下悬浮窗置顶不可用;两个方向的 opus-mt 模型里 zh→en 一份是 CC-BY-4.0,署名要求在模型页有标注。仓库创建于 2026-10-14,未归档,最近一次提交在 2026-10-23,迭代很快但还很年轻。
音频转文字之后还想让本机模型把内容整理成结构化笔记的话,可以接着看 AudioNotes;同样是本地语音管线、面向 Apple Silicon 的完整同传系统,之前写过 VoxWeft。我们核对了 README、官网、Releases 元数据和仓库提交记录,没有实际安装运行。