auto-ontology:NVIDIA 开源企业语义层,给 Agent 一个不敢算错数的底座
NVIDIA 开源 Python 框架:从元数据生成本体与知识图谱,Agent 经 MCP 拿可信业务语义,NL 转 SQL 带出处,Apache-2.0。
项目资料
GitHub Ecosystem- 许可证
- Apache-2.0
- 主语言
- Python
- 星标
- 4,789
- 核查时间
- 2026-11-04
以上快照资料以核查当日为准,可能随版本或运营策略变化。
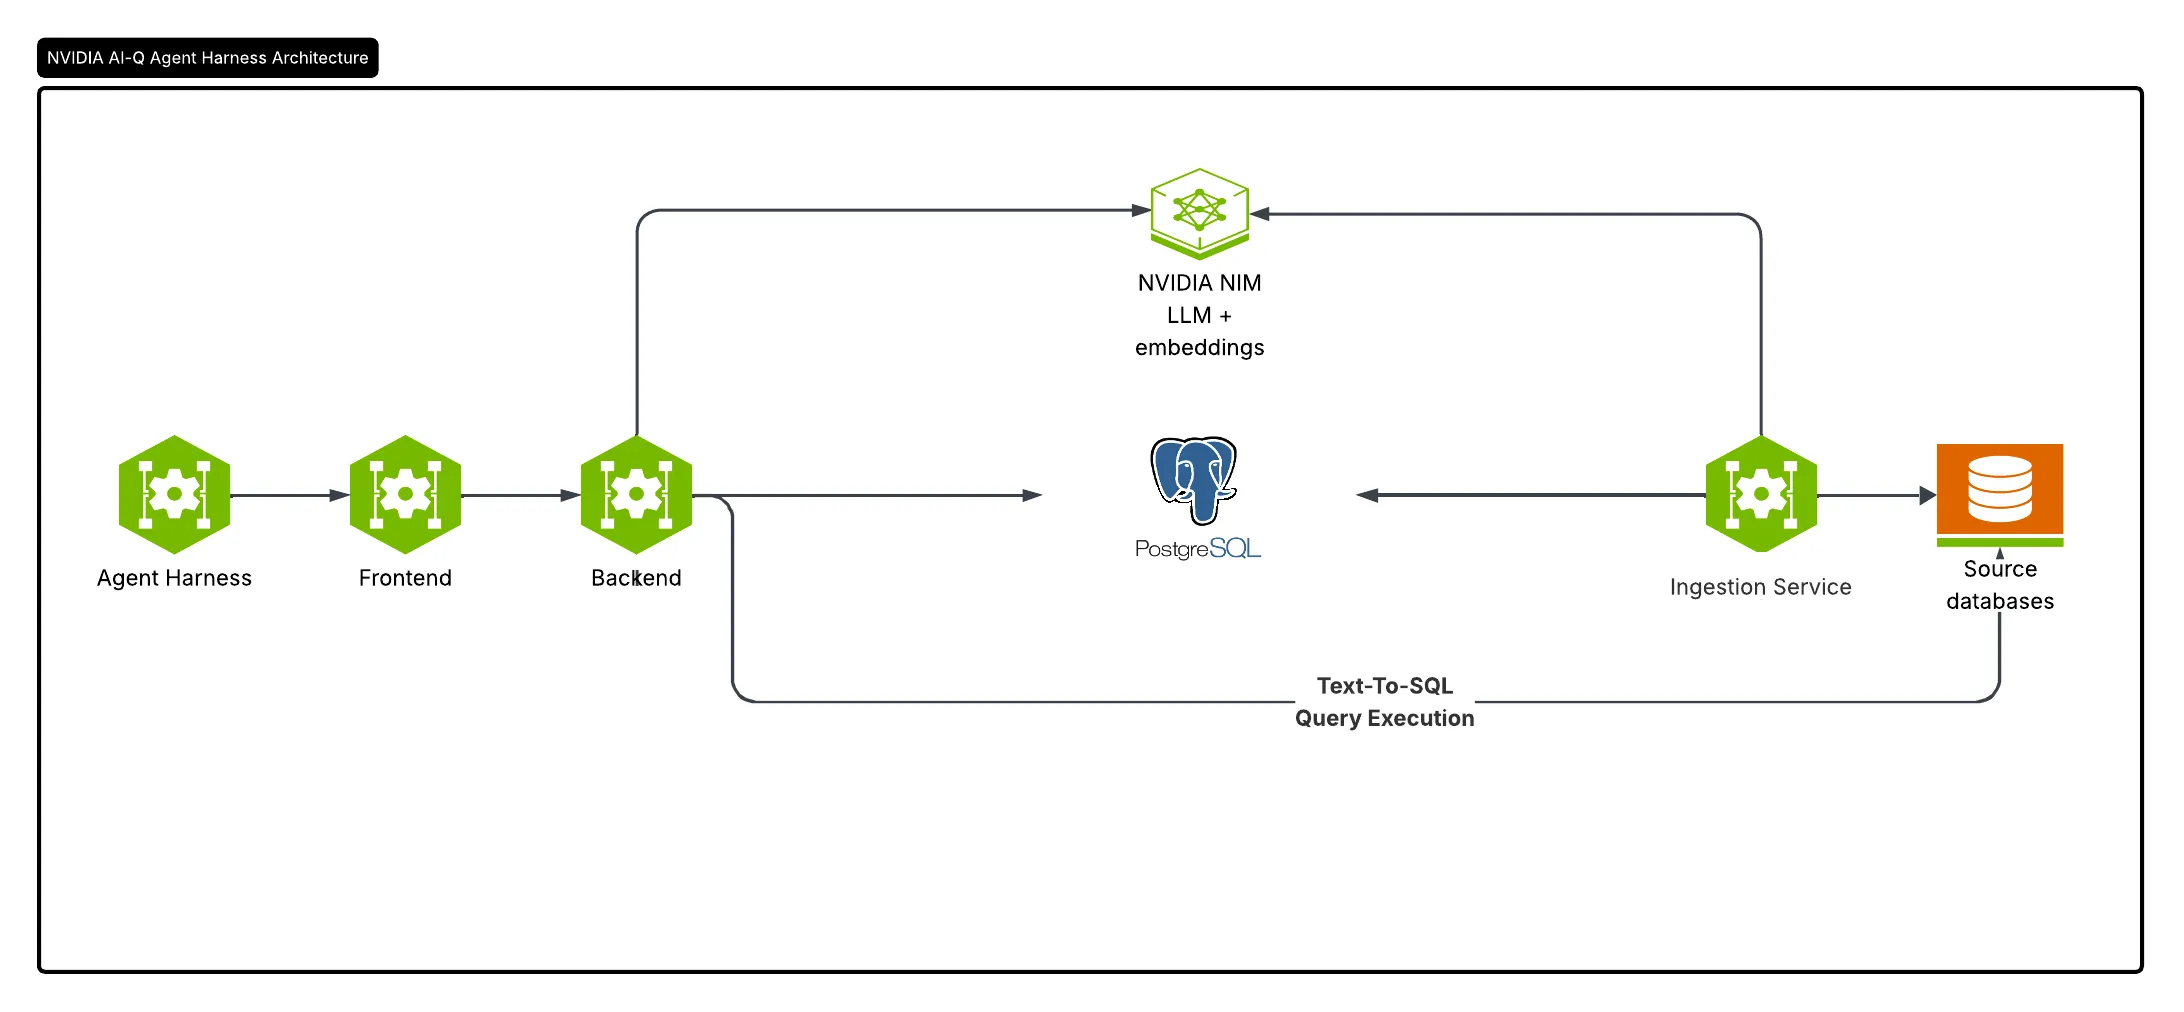
Agent 能查文档、能查数据库,但企业分析场景卡在可靠上:营收指标回答得再快,数字错了就是零分。NVIDIA 开源的 auto-ontology(Apache-2.0,Python,截至 2026-11-04 有 4,789 星,公众号文章称其登顶 GitHub Trending)给 Agent 铺的就是那层「不敢算错」的底座:从企业元数据生成本体(ontology),跨系统调和指标与实体的定义,构建 AI 就绪的知识图谱,再通过 MCP、CLI、API 把这层可信语义暴露给任意 Agent harness——「数据在哪、是什么、能不能用、怎么用、从哪来」五问全部有据可查。
核心功能
- Discover:从元数据自动生成企业本体,可接入既有本体与语义模型,产出 AI 就绪的知识图谱。
- Ground:给 Agent 提供可信的业务语义——指标、实体、关系的企业级定义,跨系统不一致的定义自动调和。
- Validate:Agent 生成的查询对着「认证过的定义与血缘」校验,每个答案附带出处(provenance)。
- NL 查询即服务:自然语言问题转 SQL 并在已连接的数据库上执行,由 NVIDIA NIM 驱动。
- 工程完整度:Postgres 存储语义目录、Better Auth 做认证与 RBAC、自带聊天/分析/数据目录 Web UI、Helm 图或 Docker Compose 两种部署。
典型使用场景
- 企业数据分析 Agent:让 Agent 直接回答「上季度华东区净留存多少」这类指标问题,且每个数字带血缘出处。
- 跨系统口径调和:三个系统里「活跃用户」三种定义,本体层统一后才谈得上自动化。
- 给自建 Agent 装语义层:已有语义模型(如 dbt 指标层)的企业可把 auto-ontology 当作补全与暴露层。
快速上手
git clone https://github.com/NVIDIA/auto-ontology.git
本地可用 Docker Compose 起整套栈,Kubernetes 用 Helm chart;文本转 SQL 的效果基准(BIRD)配套了独立的 ontology-sql-eval 仓库可自行复测。接线方式有三条——MCP 给 Claude Code 这类 Agent、CLI 给脚本编排、API 给自建平台,语义层装好后三边同时生效,不用各接一遍。
小结
auto-ontology 适合有正经数据仓库、要让 Agent 接触业务指标的企业;个人小项目或纯文档问答场景用不上它——它的价值全在「企业元数据」这四个字上。要点与边界:Apache-2.0、Python;NL 转 SQL 由 NVIDIA NIM 驱动(意味着最好已经在 NIM 生态里);与本体相关的仓库明确声明不接受外部贡献,定制要走 fork。它对准的痛点与本站写过的 agent-autoloop 是同一条链的两端——autoloop 解决「Agent 怎么持续干活」,auto-ontology 解决「Agent 干活时依据什么」:没有可信语义层,跑得再勤也只是更快地算错。