Exercises Dataset:1,324 个健身动作的结构化数据集
Exercises Dataset 是健身动作数据集,含 1,324 个动作的 JSON 记录和 10 种语言说明,适合做健身 App;图片和动图另有条款。
项目资料
GitHub Ecosystem- 主语言
- HTML
- 星标
- 23,111
- 核查时间
- 2026-10-21
以上快照资料以核查当日为准,可能随版本或运营策略变化。
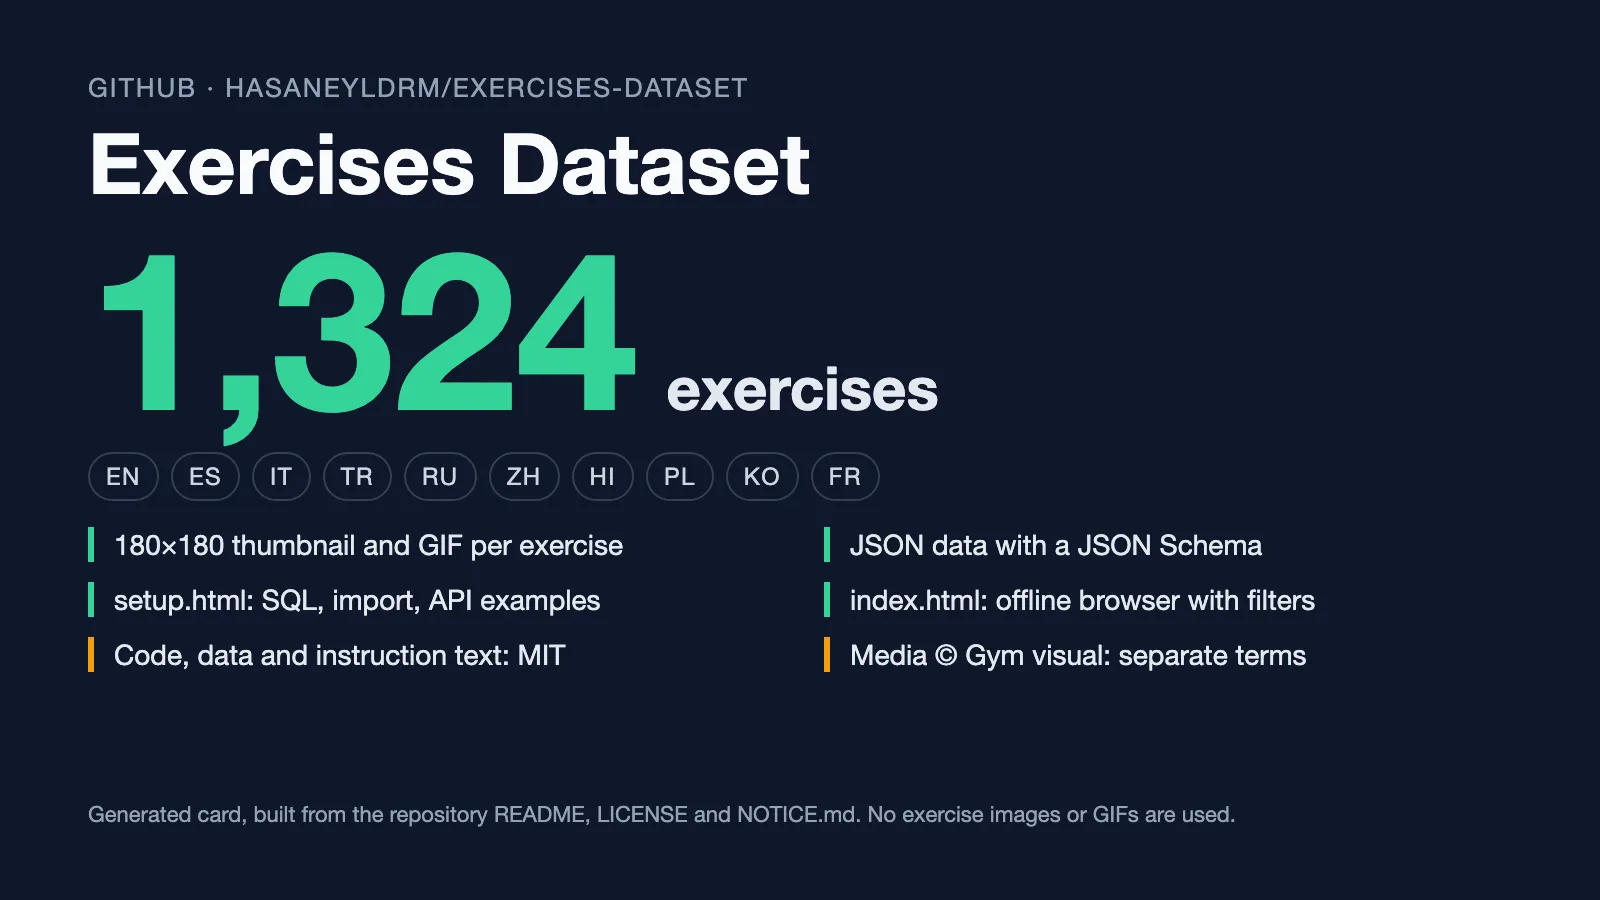
做训练记录类 App 时,动作库往往要花不少时间:每个动作的名称、器械、目标肌肉和说明都得一条条录入。Exercises Dataset(GitHub 仓库 hasaneyldrm/exercises-dataset)是一份健身动作数据集,把 1,324 个动作放在一个 JSON 数组里,每个动作都带 10 种语言的说明。它在说明文字的存法上有个细节:每种语言既有一整段字符串,也有一个逐步的数组,界面整段显示还是分步显示都能直接取用。微信公众号「GitHub科技」在 2026 年 10 月 21 日推荐过它,我们读了仓库的 README、LICENSE 和数据文件,对照其中的数字和说法。
核心功能
Exercises Dataset 的功能分五块,按读者最可能先问的顺序排列。
- 数据结构由 Schema 约束:
data/exercises.json是一个含 1,324 个对象的 JSON 数组,data/exercises.schema.json用 JSON Schema(草案 2020-12)描述每个字段。我们检查了全部记录,每条都正好有 15 个字段,没有多出的键。数据里没有组数、次数和重量,要做训练计划得自己补。 - 10 种语言的说明:英语、西班牙语、意大利语、土耳其语、俄语、中文、印地语、波兰语、韩语和法语。每个动作在每种语言下都有一个字符串(
instructions)和一个步骤数组(instruction_steps),英文说明从 4 步到 11 步不等。非英语的文本没有一条与英文原文相同。 - 器械、部位和肌群:
body_part分 10 类,upper arms(292 个)和upper legs(227 个)最多。equipment有 28 种取值,body weight(325 条)和dumbbell(294 条)居首。target有 19 种,muscle_group有 29 种。 - 每个动作一张缩略图和一段动图:
images/和videos/各有 1,324 个文件,全部是 180×180。GIF 最少 12 帧、最多 54 帧,每个都是多帧动画。NOTICE.md 写明这些图片和动图归 Gym visual 所有,本文一张都没有用。 - setup.html 和 index.html:README 说,
setup.html提供 SQL Server、PostgreSQL、MySQL 和 SQLite 的建表语句,能在浏览器里生成含 1,324 条INSERT的 SQL 文件,还有七种调用方式的接口示例,以及一段可以交给 ChatGPT、Claude 或 Gemini 的提示词。index.html是一个 16 MB 的单页,不需要服务器,能搜索,也能按类别、器械和目标肌肉筛选。我们检查了两个文件里的关键字符串,index.html没有读取data/exercises.json,但两个页面都没有在浏览器里实际运行。
授权范围
Exercises Dataset 的授权分两套,复用前要分开看。
| 内容 | 位置 | 授权 |
|---|---|---|
| 代码、工具、数据结构、说明文字和译文 | LICENSE 中的 MIT 部分 | MIT |
| 缩略图(1,324 张)和动图(1,324 个) | images/、videos/,见 NOTICE.md | © Gym visual,须按其条款使用 |
LICENSE 末尾的 MEDIA EXCEPTION 写明,克隆仓库并不等于获得媒体的使用权。每条记录的 attribution 字段都写着「© Gym visual — https://gymvisual.com/」,复用时要保留。想用图片或动图,就得向 Gym visual 取得自己的授权,或者遵守它的条款。GitHub 的许可证识别结果是 NOASSERTION(名称为 Other),并没有识别为 MIT。我们之前的 openGym 条目也提到,动作图片和动画的版权有争议。
典型使用场景
Exercises Dataset 主要服务三类人。
- 做训练记录 App 的独立开发者:直接读取
data/exercises.json,用equipment做筛选,比如只显示body weight的动作,给在家训练的用户用。过滤前要先归并器械写法,原因见「小结」。 - 要快速搭出动作接口的后端工程师:先用
setup.html生成建表和导入的 SQL,再把页面里的提示词交给大模型生成接口代码。生成的代码要自己测试,这段提示词我们没有运行过。 - 做中文界面的团队:直接取
instructions.zh或instruction_steps.zh,不必为 1,324 个动作逐条撰写说明。README 没有说明译文是怎么来的,也没有说是否经过人工审校,上线前最好抽样核对。
快速上手
Exercises Dataset 的 README 没有给出安装步骤,下面的克隆命令是 Git 的标准写法。克隆会把约 129 MB 的动图一起下载;如果只需要数据,单独下载 data/exercises.json(约 17 MB)就够了。
git clone https://github.com/hasaneyldrm/exercises-dataset.git
cd exercises-dataset
第一次运行可以用 README 里的这段 Python,它读取数据文件并打印动作数量:
import json

with open("data/exercises.json", "r", encoding="utf-8") as f:
    exercises = json.load(f)

print(f"Total exercises loaded: {len(exercises)}")
运行后会输出 Total exercises loaded: 1324。想浏览动作的话,用任意浏览器打开 index.html 即可。
小结
Exercises Dataset 适合需要结构化动作库、又想自己搭后端或 App 的独立开发者和小团队,尤其是要做多语言界面的人。它不适合想要现成训练计划、组数次数、重量或教练建议的人:数据里没有这些字段,README 也写明是为教育和研究用途准备的。
授权和语言:代码和数据是 MIT,图片和动图另有条款(见上文「授权范围」)。仓库简介写的是 6 种语言,README、Schema 和数据文件都是 10 种,本文以数据为准。
还有几处要留意。器械字段没有归一化,band 和 resistance band 是两个值,需要按自己的业务合并。created_at 的 1,324 个时间戳都落在 2026 年 3 月 18 日 12:31:32 这一秒内,它标记的是生成这批数据的时间,并不能说明每个动作何时核对过。README 说这套数据是 LogPress 应用的数据层,我们没有查看 LogPress 本身。
仓库 2026 年 3 月 18 日创建,最近一次推送是 7 月 16 日,没有归档。截至 2026 年 10 月 21 日,它有 23,111 颗星、2,946 个 fork。这篇文章读了 README、LICENSE、NOTICE、数据文件和两个 HTML 文件的关键字符串,没有在浏览器里运行页面,也没有运行 SQL 或接口代码。