Laya:一次前向传播就出结构化决策的引擎
Laya 是非自回归决策引擎,文本输入一次前向传播即返回带概率的选择、评分与判断,T4 上约 33 毫秒,支持 100 多种语言。
项目资料
GitHub Ecosystem- 许可证
- Apache-2.0
- 主语言
- Python
- 星标
- 34,467
- 核查时间
- 2026-10-27
以上快照资料以核查当日为准,可能随版本或运营策略变化。
客服工单自动分诊、钓鱼邮件判定、Agent 路由,这些任务的共同点是要一个确定的答案,而不是一段要再解析的生成文本。Laya 是一个非自回归「系统 1」决策引擎:把文本连同类型化的问题(选择题、评分、是/否)一起喂进去,一次前向传播直接返回带校准概率的结构化结果,不经过文本生成。README 在 T4 GPU 上实测单个问题约 33 毫秒、批量摊薄到每题 7.2 毫秒,模型覆盖 100 多种语言;截至 2026-10-27,仓库约 34,500 Star,Apache-2.0 协议。它不写代码、不写邮件,只做「给定文本,回答类型化问题」这一件事,并把这件事的延迟压到了生成式模型的三分之一以下。
核心功能
- 类型化决策原语:choice(带标准的多选一)、score(有序评分)、noul(校准的 P(true) 是/否判断)三种,一次调用可以同时问多个问题,返回结构与选项顺序无关。
- 单次前向传播出结果:模型是 ModernBERT-large(4.21 亿参数)与 mmBERT-base(3.22 亿参数)量级的编码器,不做自回归解码,T4 上单问 33 毫秒、批处理 7.2 毫秒/题(README 数据,2026-10 查证)。
- 100+ 语言路由:内置 Router 检测语言和文字系统,把请求分发给对应 checkpoint;48/51 种语言可用性超过随机基线三倍(README 语言表)。
- 置信度门控与弃权:可以设阈值让模型在没把握时显式弃权而不是硬答,v0.4.16 起弃权语义在 Python、Rust、.NET 三端一致。
- 全栈集成面:HTTP 服务(
laya[serve])、MCP server、LangChain/LlamaIndex/CrewAI 选择器、ONNX 与 TileLang GPU 快速路径,TypeScript SDK(npm 包 laya-ts)单独发版。 - 微调工作流:用 RLCD(对照严格正当评分规则的强化学习)微调,官方示例把 typed-decisions 基准准确率从基座 checkpoint 的 0.362 提到 0.766。
典型使用场景
- 客服工单分诊:一封工单文本进来,同时返回「派给哪个部门、紧急程度几分、是否有流失风险」三个答案加概率,高置信自动派单、低置信转人工。
- Agent 路由前置:在多 Agent 系统里先让 Laya 判断意图类别和优先级,再决定交给哪条管线,比让大模型生成再解析省一个数量级的延迟。
- 内容风控初筛:钓鱼邮件、垃圾内容、审核信号的批量打分,数据可以完全留在内网自托管。
快速上手
python -m pip install laya
from laya import Router

router = Router()  # 首次使用会下载 checkpoint
result = router.predict(
    "用户投诉三月被重复扣款,要求今天退款否则取消订阅。",
    {"department": {"type": "choice",
                    "criteria": {"billing": "账单、付款、退款",
                                 "technical": "故障、报错"}}},
)
print(result["answers"]["department"]["choice"])  # billing
输出是 Python 字典:答案、概率和路由到的模型都在里面。想先在浏览器里试,Hugging Face 上有 laya-demo Space。
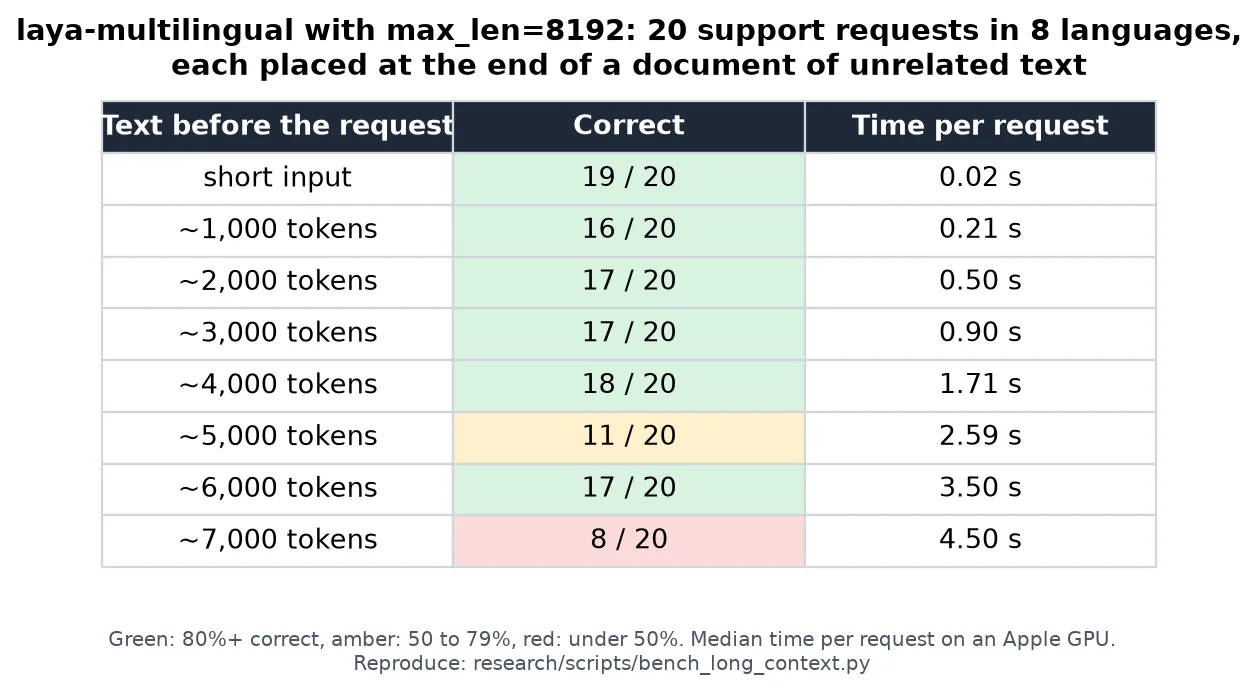
小结
Laya 适合把「分类、打分、判断」从大模型生成管线里拆出来的团队:毫秒级延迟、结构化输出、能弃权、能自托管,尤其契合工单分诊和 Agent 路由这类高频小决策。局限也要说清:它只回答训练分布里的类型化问题,开放式理解和写作仍然要回到生成式模型;长文档能力有边界,官方基准显示前置文本超过约 5,000 token 后正确率开始明显波动;刷高基准的微调需要自己构造标注数据。协议 Apache-2.0,主语言 Python,另有 Rust 与 .NET 移植。给多 Agent 系统补路由判断的,还可以看 everything-claude-code 里的编排实践,或 agentplay 把多个编码 Agent 的会话可视化之后再决定路由策略。