Needle:8-29 MB 的端侧自动化模型
Cactus Compute 开源的端侧自动化模型:8-29 MB 一个二进制,在手机到单片机上做工具调用、结构化抽取与语音识别,Apache-2.0 协议。
项目资料
GitHub Ecosystem- 许可证
- Apache-2.0
- 主语言
- Python
- 星标
- 14,245
- 核查时间
- 2026-10-23
以上快照资料以核查当日为准,可能随版本或运营策略变化。
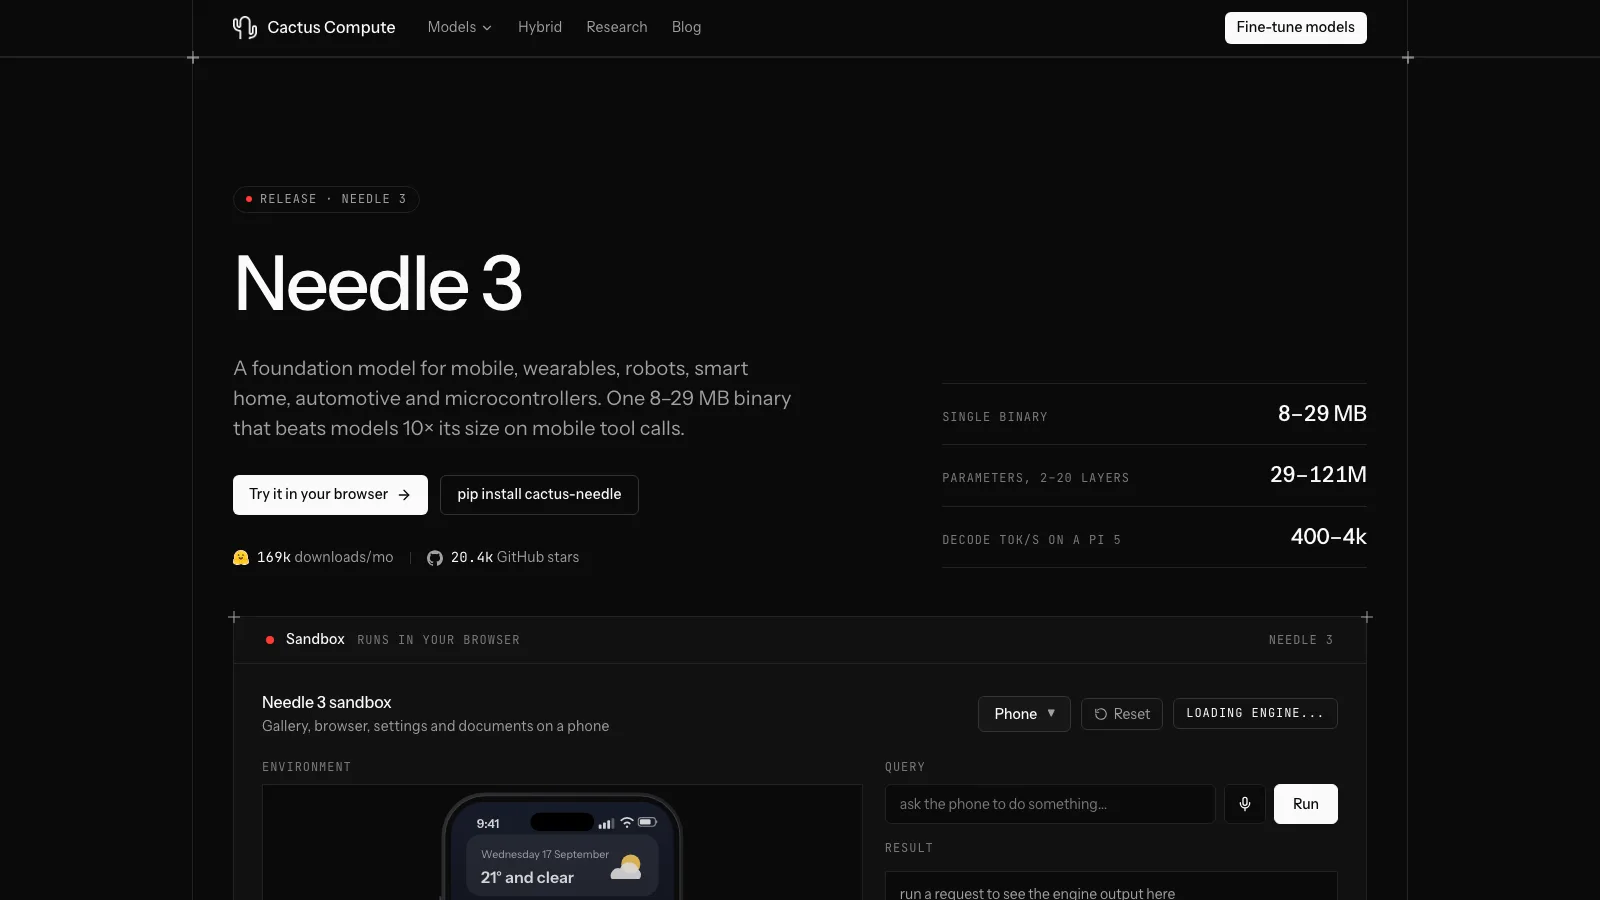
给手机、手表甚至单片机加一点 AI 能力,常规做法是接云端 API,延迟、隐私和按调用计费三样都得背。Needle 是 Cactus Compute 开源的端侧自动化基础模型:整个模型是一个 8-29 MB 的二进制,工具调用、结构化抽取、文本向量和语音识别全部在设备上完成,截至 2026-10-24 在 GitHub 有 14,245 颗星,Apache-2.0 协议。它最有意思的设计是把参数做成 2 到 20 层的阶梯,训练时就保证每一档深度都是可部署的模型,小设备裁到几层照样跑,微调到导出的链路也是现成的。
核心功能
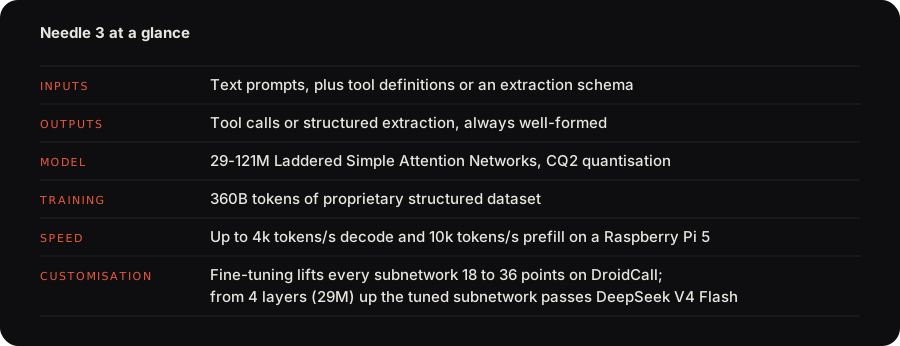
- 工具调用:把函数签名交给它,Needle 负责挑函数、填参数;用户要两件事就按顺序给两个调用,请求没有工具能接就返回空列表,不硬猜。每次响应带一个校准过的置信度分数,可以按分数决定直接执行、转人工确认还是拒绝。
- 结构化抽取:声明一个 schema,把脏文本丢进去,拿回类型化字段,发票、预约、表单都行。解码语法在字节级约束每个 token,输出保证能解析;换成一个枚举 schema,同一套机制就变成分类。
- Whistle 语音识别:16.9 MB 一个文件,纯 CPU,覆盖英、德、法、西、意、荷、波 7 种语言。它和 Needle 共用
.cact容器与 C++ 引擎,音频进、工具调用出是一次调用的事,不用拼两个运行时。 - 文本向量:同一个模型能给句子返回向量,搜索、匹配、路由都在本地做。
- 13 类平台一个引擎:官方设备指南列了 13 个平台文件夹,每个引擎不到 1 MB,覆盖 macOS、Windows、五档 Linux(x86-64、ARM64、ARMv7、RISC-V、MIPS)、Android、iOS、watchOS/tvOS、浏览器(wasm)和 WASI 主机;权重统一是 Hugging Face 上的
needle3.cact(约 35 MB 下载)。 - 按档微调:本地
needle finetune训 LoRA(4-bit),或把 key 交给官方平台做 2-bit 全参数训练。README 说在 DroidCall 上微调能把每档子网提高 18-36 分,4 层以上的调优子网从 29M 参数起就能超过 DeepSeek V4 Flash。
典型使用场景
- 智能家居与可穿戴:一句话开关灯、设定时,语音和工具调用在本地闭环,不联网也没有按次费用。
- App 内的离线抽取:票据、通知、表单转结构化字段,飞行模式照常工作。
- 机器人、车载与 MCU:内存按 MB 算、又要求输出确定的场合,选小档位加微调。
- 操作完整桌面是另一条路线:那类任务可以看 Agent-S,它靠截图和点击驱动;Needle 管的是设备自身功能的调用。
快速上手
Python 3.9+,README 的安装就一行:
pip install cactus-needle
第一个例子十几行就能跑通一次工具调用:
import needle

@needle.tool
def get_weather(city: str):
    "Get the current weather for a city."
    return {"city": city, "temp_c": 27, "sky": "clear"}

agent = needle.Needle(tools=[get_weather])
print(agent.run("what's it like in Lagos right now?")["results"])
# [{'city': 'Lagos', 'temp_c': 27, 'sky': 'clear'}]
引擎和权重在首次运行时自动从 Hugging Face 下载并缓存;不想装任何东西,直接开 cactuscompute.com/needle 的浏览器沙盒。浏览器和 Node 里还有社区维护的 cactus-needle npm 包,走 WebAssembly。
性能数据
以下数字来自项目自测(README 的基准图):Needle 3 用出厂 2-bit 二进制并开置信度门,基线以 f16 在 vLLM 下测,DeepSeek V4 Flash 走云端 API。
| 模型 | 规模 | Mobile Actions 准确率 |
|---|---|---|
| DeepSeek V4 Flash | 云端 | 88.4% |
| Needle3-20L-121M | 121M | 86.0% |
| LFM2.5 1.2B | 1.2B | 82.4% |
| Needle3-16L-98M | 98M | 80.7% |
| Qwen3.5 0.8B | 800M | 76.0% |
Mobile Actions 测的是精确匹配的工具调用(961 行测试集),README 里「赢过 10 倍大的模型」指的就是这一项:121M 的 Needle 3 高过 10 倍大的 LFM2.5 1.2B。代价在同一张图里:52M 档 36.8%,29M 档 11.7%,小档位要靠微调补。语音这边,官方自测 Whistle 16.9 MB,比 Whisper base 小 8.6 倍、10 秒音频的首 token 快 6.6 倍(Apple M4 Pro);在 LibriSpeech 两个测试集、SPGISpeech、Earnings-22 和 FLEURS 平均上领先,在 TED-LIUM、AMI 和 MLS 平均上落后于 Whisper base。
小结
Needle 适合给硬件和 App 做端侧自动化、付不起云端延迟和按调用计费的团队;想给设备加本地语音入口的开发者也省事,Whistle 和 Needle 共用一个运行时。它不适合当通用聊天模型用,README 开头写明聊天能力是被换出去的部分。
代价和坑也在明面上。2-bit 量化和阶梯裁剪有取舍:抽取类任务官方的说法是「追平 2-3 倍大的模型」,SNIPS 两项上与云端的差距比工具调用大得多。预编译引擎默认开遥测,要设 NEEDLE_TELEMETRY=0 和 DO_NOT_TRACK=1 才关掉,嵌入式产品记得处理。所有基准是官方自测,我们无法独立复跑。仓库创建于 2026-02-24,最近一次推送是 2026-10-19,未归档;Hugging Face 上 needle3 权重库近 30 天下载约 11.2 万次(2026-10-24 查询)。我们核对了 README、llms.txt 与仓库元数据,没有安装运行。纯本地的语音合成是另一块拼图,可以看 VoxCPM。