NiubiGEO:开源的 AI 品牌可见性监测
开源自托管审计各模型怎么描述你的产品、不点名时推荐谁;每条结论能点回原始回答和引用来源,BYOK 只付 API 费,Apache-2.0。
项目资料
GitHub Ecosystem- 许可证
- Apache-2.0
- 主语言
- TypeScript
- 星标
- 4,858
- 核查时间
- 2026-10-02
以上快照资料以核查当日为准,可能随版本或运营策略变化。
用户开始跳过搜索引擎直接问 AI「XX 类工具哪家好」,你的产品在不在回答里,多数团队并不知道。商业监测平台给一个综合分,Profound 入门档 99 美元一个月还只测 ChatGPT(2026-09 官方定价页),分数怎么算的看不到。NiubiGEO 走反方向:Apache-2.0 开源、自托管,把各模型的原始回答、引用来源、连失败记录都留给你,每条结论能点回原文核对。仓库 2026-09-03 建立,一个月收获 4,858 星(截至 2026-10-02),TypeScript 写成,v0.2.1 发布于 2026-09-28。
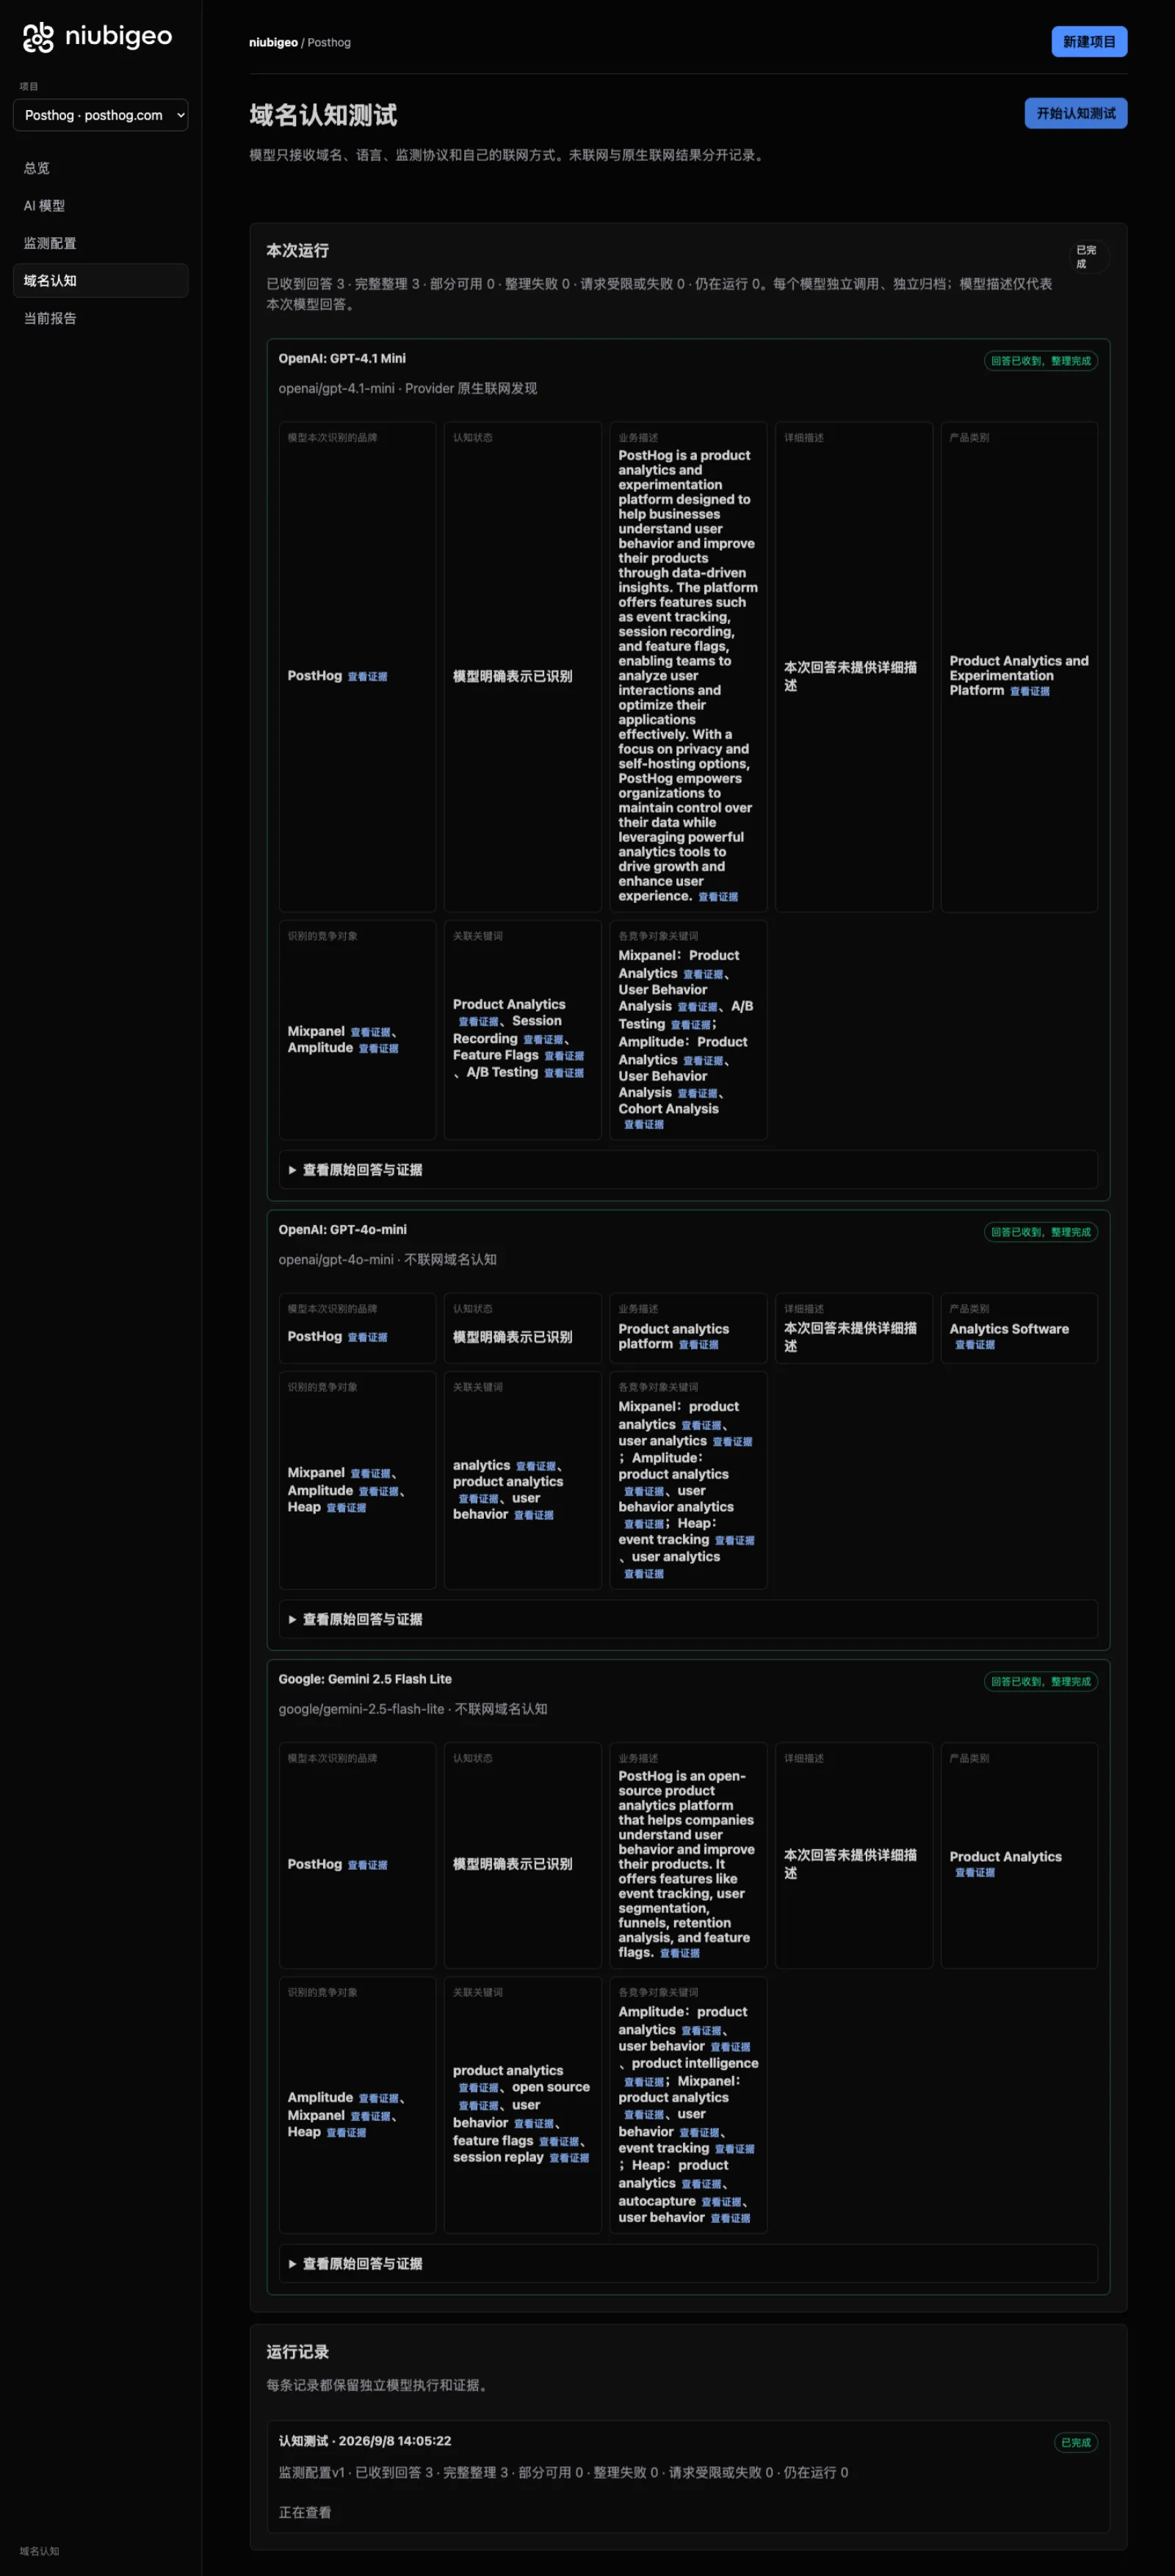
核心功能
- 域名测试:输入域名建项目,每个模型独立回答四个问题——它怎么描述你、认为你做什么、把哪些产品列为竞品、给你关联了哪些关键词。不同模型说法打架时,差异本身就是调查线索。
- 关键词测试:不点你的品牌名,只丢一个中性需求词(比如拿 “prototyping” 去问 Figma 的案例),看回答里冒出来的是谁。「被提到」和「被推荐」在这里拆成两个信号,多数监测工具把这两件事混成一个分数。
- 证据链:每次运行保留原始回答、Provider 返回的引用和失败记录,证据文件带 SHA-256 哈希,事后能核对有没有被改过;报告里每条结论都链回对应的回答原文。
- 混连模型:OpenRouter、直连 API 和自定义 OpenAI 兼容端点可以混进同一次测试,16 个平台快捷入口按平台预填端点,每个模型单独控制要不要联网搜索;结果按端点、模型、搜索条件分开保存,同名模型也不会串。
- 持续观测:监控 worker 按计划重测,积累可比的时间序列;官方预告 10 月底的 v0.3 会加竞品检测和持续关键词监控两块仪表盘。仓库 examples 里还有 Notion、Figma、PostHog 等 20 个真实案例,不装任何东西就能翻。
典型使用场景
- 开源作者和独立开发者:发布之后想知道 AI 到底推不推荐你,先翻 20 个案例找同类参照,再花几美元 API 费测自己的域名。
- 产品和营销团队:投内容、做 GEO 优化前后各测一轮,靠原始回答而不是一个分数判断哪里变了、哪个模型误会了你的定位。
- 竞品研究:看竞品在关键词测试里被怎么推荐、它的回答引用了哪些来源,找自己内容布局的缺口。
快速上手
需要 Node 22.13 以上和自己的 OpenRouter API Key,模型和搜索的调用费自付:
git clone --branch v0.2.1 --depth 1 https://github.com/Albert-Weasker/niubigeo.git
cd niubigeo
npm ci
cp .env.example .env
# 编辑 .env,填入 OPENROUTER_API_KEY
npm run server
打开 http://localhost:8787 创建第一个项目。不想配 Node 环境可以用官方 Docker 镜像;界面有英文、简体中文和巴西葡语三语。
小结
适合想亲手核对 AI 怎么描述产品的开发者和小团队;要消费级 ChatGPT 网页结果、要现成营销工作流的团队不是它的用户——README 自己列了 Profound、Peec AI、Otterly 等商业平台对比表,建议这类需求直接看商业方案。三个预期要摆正:它测的是 Provider API,官方明确声明不等于 ChatGPT、Gemini 消费级界面的结果;几分钟的几次测试构不成趋势结论;单进程加文件存储,官方 limitations 文档列出 14 条已知缺口(重试结果可能混用、无跨进程锁、预算闸门不完整),拿去二次开发做多人服务要先补这些。背景也值得知道:背后公司 NiubiStar 卖人民币计价的服务(99 元诊断报告、真人测试、文章投放),开源工具是它的门面,但代码本身 Apache-2.0,商用二开没有许可障碍。要管传统 SEO 那一摊的,可以看我们之前收录的 open-seo,关键词排名、外链是它的主场,AI 可见度只是其中一个模块。