OpenSRE:开源的 AI SRE 智能体框架
OpenSRE 是 Apache-2.0 许可的 AI SRE 智能体框架(public alpha),SRE 团队用它连接监控、云和事件工具,先取证再给结论。
项目资料
GitHub Ecosystem- 许可证
- Apache-2.0
- 主语言
- Python
- 星标
- 12,306
- 核查时间
- 2026-10-21
以上快照资料以核查当日为准,可能随版本或运营策略变化。
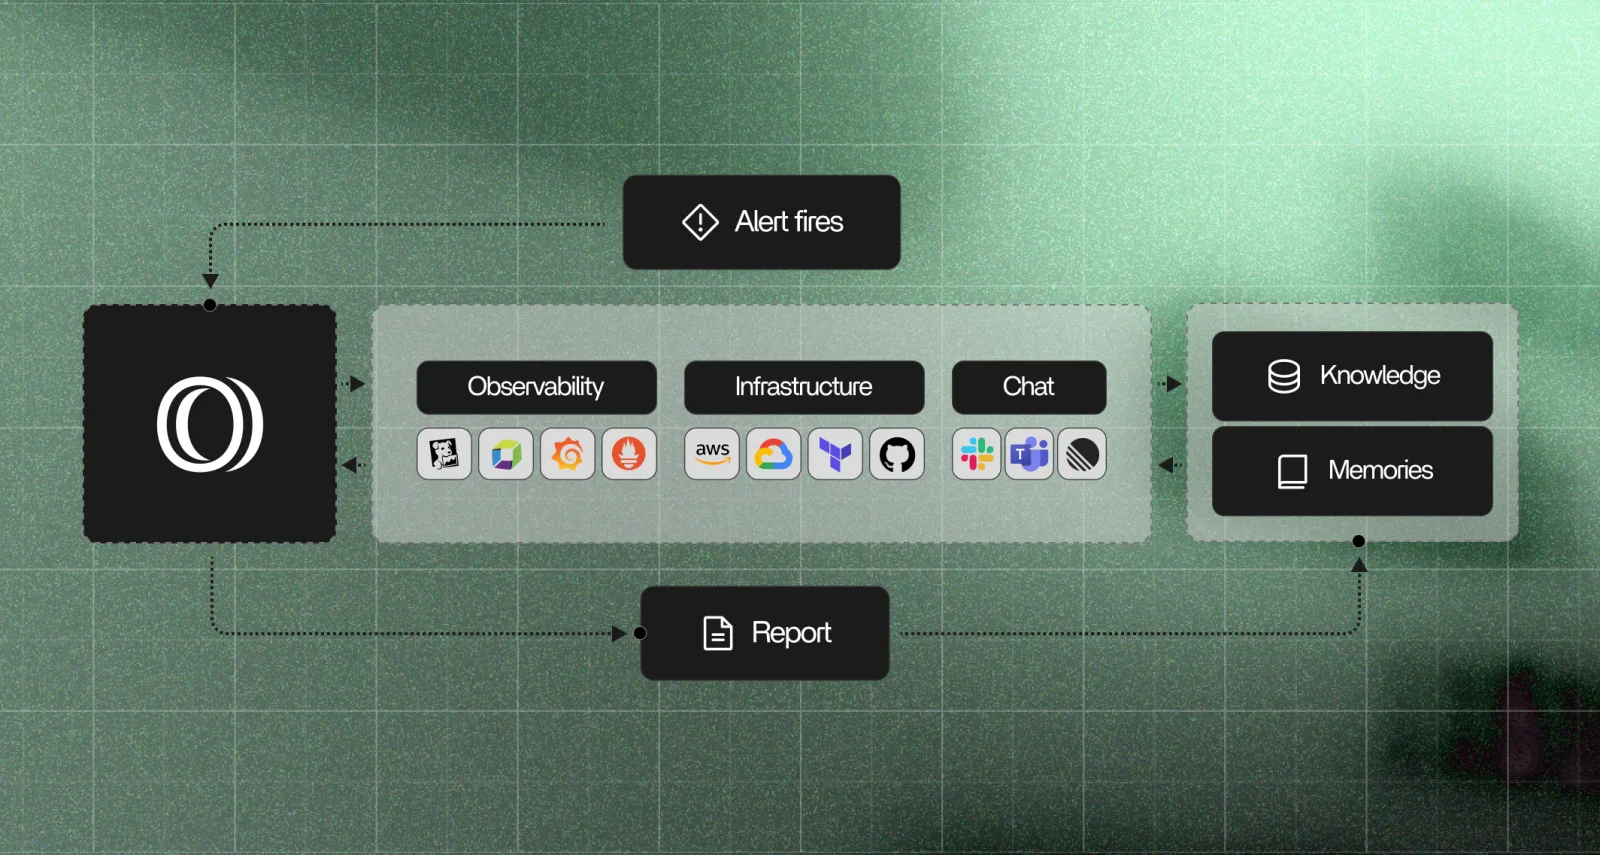
凌晨的告警响了,你要同时翻日志、看指标、对最近的部署记录,还要在 Slack 线程里找以前的处理结论。OpenSRE 是一个开源框架,用来搭建 AI SRE 智能体,让智能体先把证据收齐,再回答生产环境里的问题。仓库是 Tracer-Cloud/opensre,README 写明它可以连接 60 多个你已经在用的工具,并部署在自己的基础设施上。截至 2026-10-21,仓库有 12,306 颗星,许可证为 Apache-2.0,项目自己标注为 public alpha。
核心功能
- 先收证据,再下结论:流程是先抓取相关上下文,包括关联的日志、指标、链路追踪和最近的部署,然后在工具调用循环里验证假设。README 把这一点称为 Evidence-backed root cause,意思是每个结论都链接到它依据的数据。
- 连接 60 多个工具:README 的集成表分成可观测性(Grafana、Datadog、Sentry、CloudWatch 等)、基础设施(Kubernetes、AWS、Azure、ArgoCD)、数据库、数据平台(Airflow、Kafka、Temporal 等)、事件管理(PagerDuty、Jira、ServiceNow 等)和沟通(Slack、Discord、Telegram 等)。Linear、Notion、Teams 和 Confluence 列在路线图里。
- 读取你写好的 runbook:README 说,OpenSRE 会读取你的 runbook 并自动套用,团队已经写下的排障步骤不用再口头重讲一遍。
- 发给外部模型前脱敏:Pod、集群和账号 ID 这类标识符,可以在调用外部 LLM 之前替换掉,输出时再还原。README 在流程里把这一步标为可选(optional),所以上线前要确认它已经开启。
- 三种入口:交互式 shell 适合边看边问;
opensre ask "……"适合在终端、脚本或 CI 任务里做一次非交互调用;Python 的start_embedded_session可以把它嵌进已有服务。README 说明这一种要在源码检出的环境里使用。 - 会话成本和历史:
/cost显示每个会话的 token 用量,/sessions和/resume可以接着之前的会话继续。
典型使用场景
- 值班的 SRE:告警刚触发,想先确认 checkout-api 的日志、指标和最近的部署是否对得上,再决定要不要动手。README 自己举的问题就是
why is checkout-api slow?。 - 平台团队:把反复出现的排障步骤写成 runbook,让智能体每次都按同一顺序检查,减少人工重复讲解。
- 后端团队的自动化任务:用
opensre ask在脚本或 CI 里做单次调用。这类调用会遇到工具审批,配置方式见下面的“小结”。
快速上手
macOS 和 Linux 上,README 给出的安装和启动命令是:
curl -fsSL https://install.opensre.com | bash -s -- -gh
opensre
第一次启动会进入登录或创建账号的界面,README 说首次启动会激活托管模型。下图就是这个界面,提示说明交互式 shell 需要有效账号。
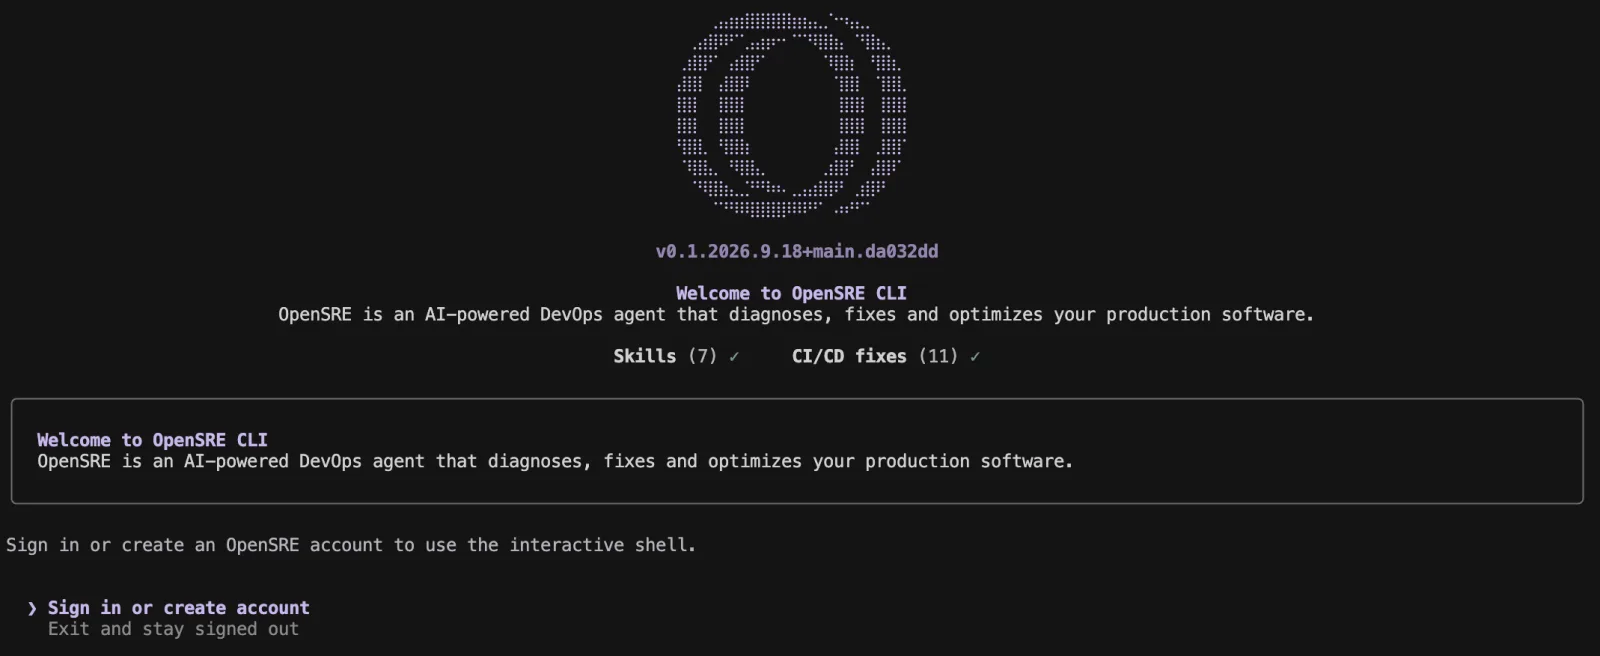
README 没有解释 -gh 参数,我们也没有读安装脚本。安装器从 main 拉取最新构建,命令里没有指定版本,所以两次安装拿到的构建可能不同。接入工具可以运行 opensre integrations setup。
小结
适合已经在用 Grafana、Datadog、Kubernetes、PagerDuty 这类工具,想让智能体先做排查和汇总,并且能承担模型调用费用的 SRE 或平台团队。如果团队还没有可观测平台,可以先看 Netdata 这类自带采集的监控,OpenSRE 要接的是你已经在用的工具。不适合想要开箱即用、不愿意自己配置工具和审批的人,也不适合无法接受 public alpha 变动的生产环境。仓库使用 Apache-2.0 许可证,主要语言是 Python,最近一次推送是 2026-10-21。
这个项目有五处需要留意。第一,项目自己标注为 public alpha,README 写明 API 和集成可能继续变化。第二,交互式 shell 需要有效账号,而且 README 没有说明首次启动激活的托管模型会收到哪些数据,接入生产数据前要自己确认。第三是工具审批。headless 模式的文档写明,会改变状态、调用外部服务或没有声明副作用的工具需要审批,没有授权时默认拒绝。--allowed-tool 可以逐个授权;--dangerously-bypass-approvals 会放行所有需要审批的工具,文档说它只能用在受控的环境里,并且不绕过操作系统权限和沙箱。文档没有写每个集成需要哪些权限,接入生产系统前要逐个查清楚。第四,遥测默认开启,产品分析和 Sentry 错误上报都是 opt-out,export OPENSRE_NO_TELEMETRY=1 可以关闭。第五,README 顶部的徽章显示项目由 Greptile 赞助。
我们只读了 README、headless 文档、LICENSE 和仓库元数据,没有安装运行,也没有验证任何集成。