OXR:1.3B 参数的文档解析模型,三榜第一
SoMark 开源的 OXR 用 1.3B 参数把 PDF 和图片转成带坐标的 Markdown/JSON,官方称三榜第一,在线 Demo 免注册可直接试。
项目资料
GitHub Ecosystem- 许可证
- Apache-2.0
- 主语言
- Python
- 星标
- 2,801
- 核查时间
- 2026-11-01
以上快照资料以核查当日为准,可能随版本或运营策略变化。
给 Agent 喂文档,难的不是读文字,是把公式、表格、阅读顺序这些结构不弄丢。OXR(Optical Everything Recognition)是 SoMark 团队开源的文档解析模型:输入 PDF 或文档图片,输出带版面坐标的 Markdown 或 JSON,覆盖文字、表格、公式、代码块、化学结构式等 13 类元素。官方称它在 olmOCR-Bench、OmniDocBench、DocParsingBench 三个榜单上都是第一,表格解析领先幅度最大。仓库 2026 年 10 月 5 日建库,截至 11 月 1 日有 2,801 颗星;模型 OXR-1.0 挂在 Hugging Face(约 3,500 次下载),Apache-2.0 基础上附加商用条款(见下文)。
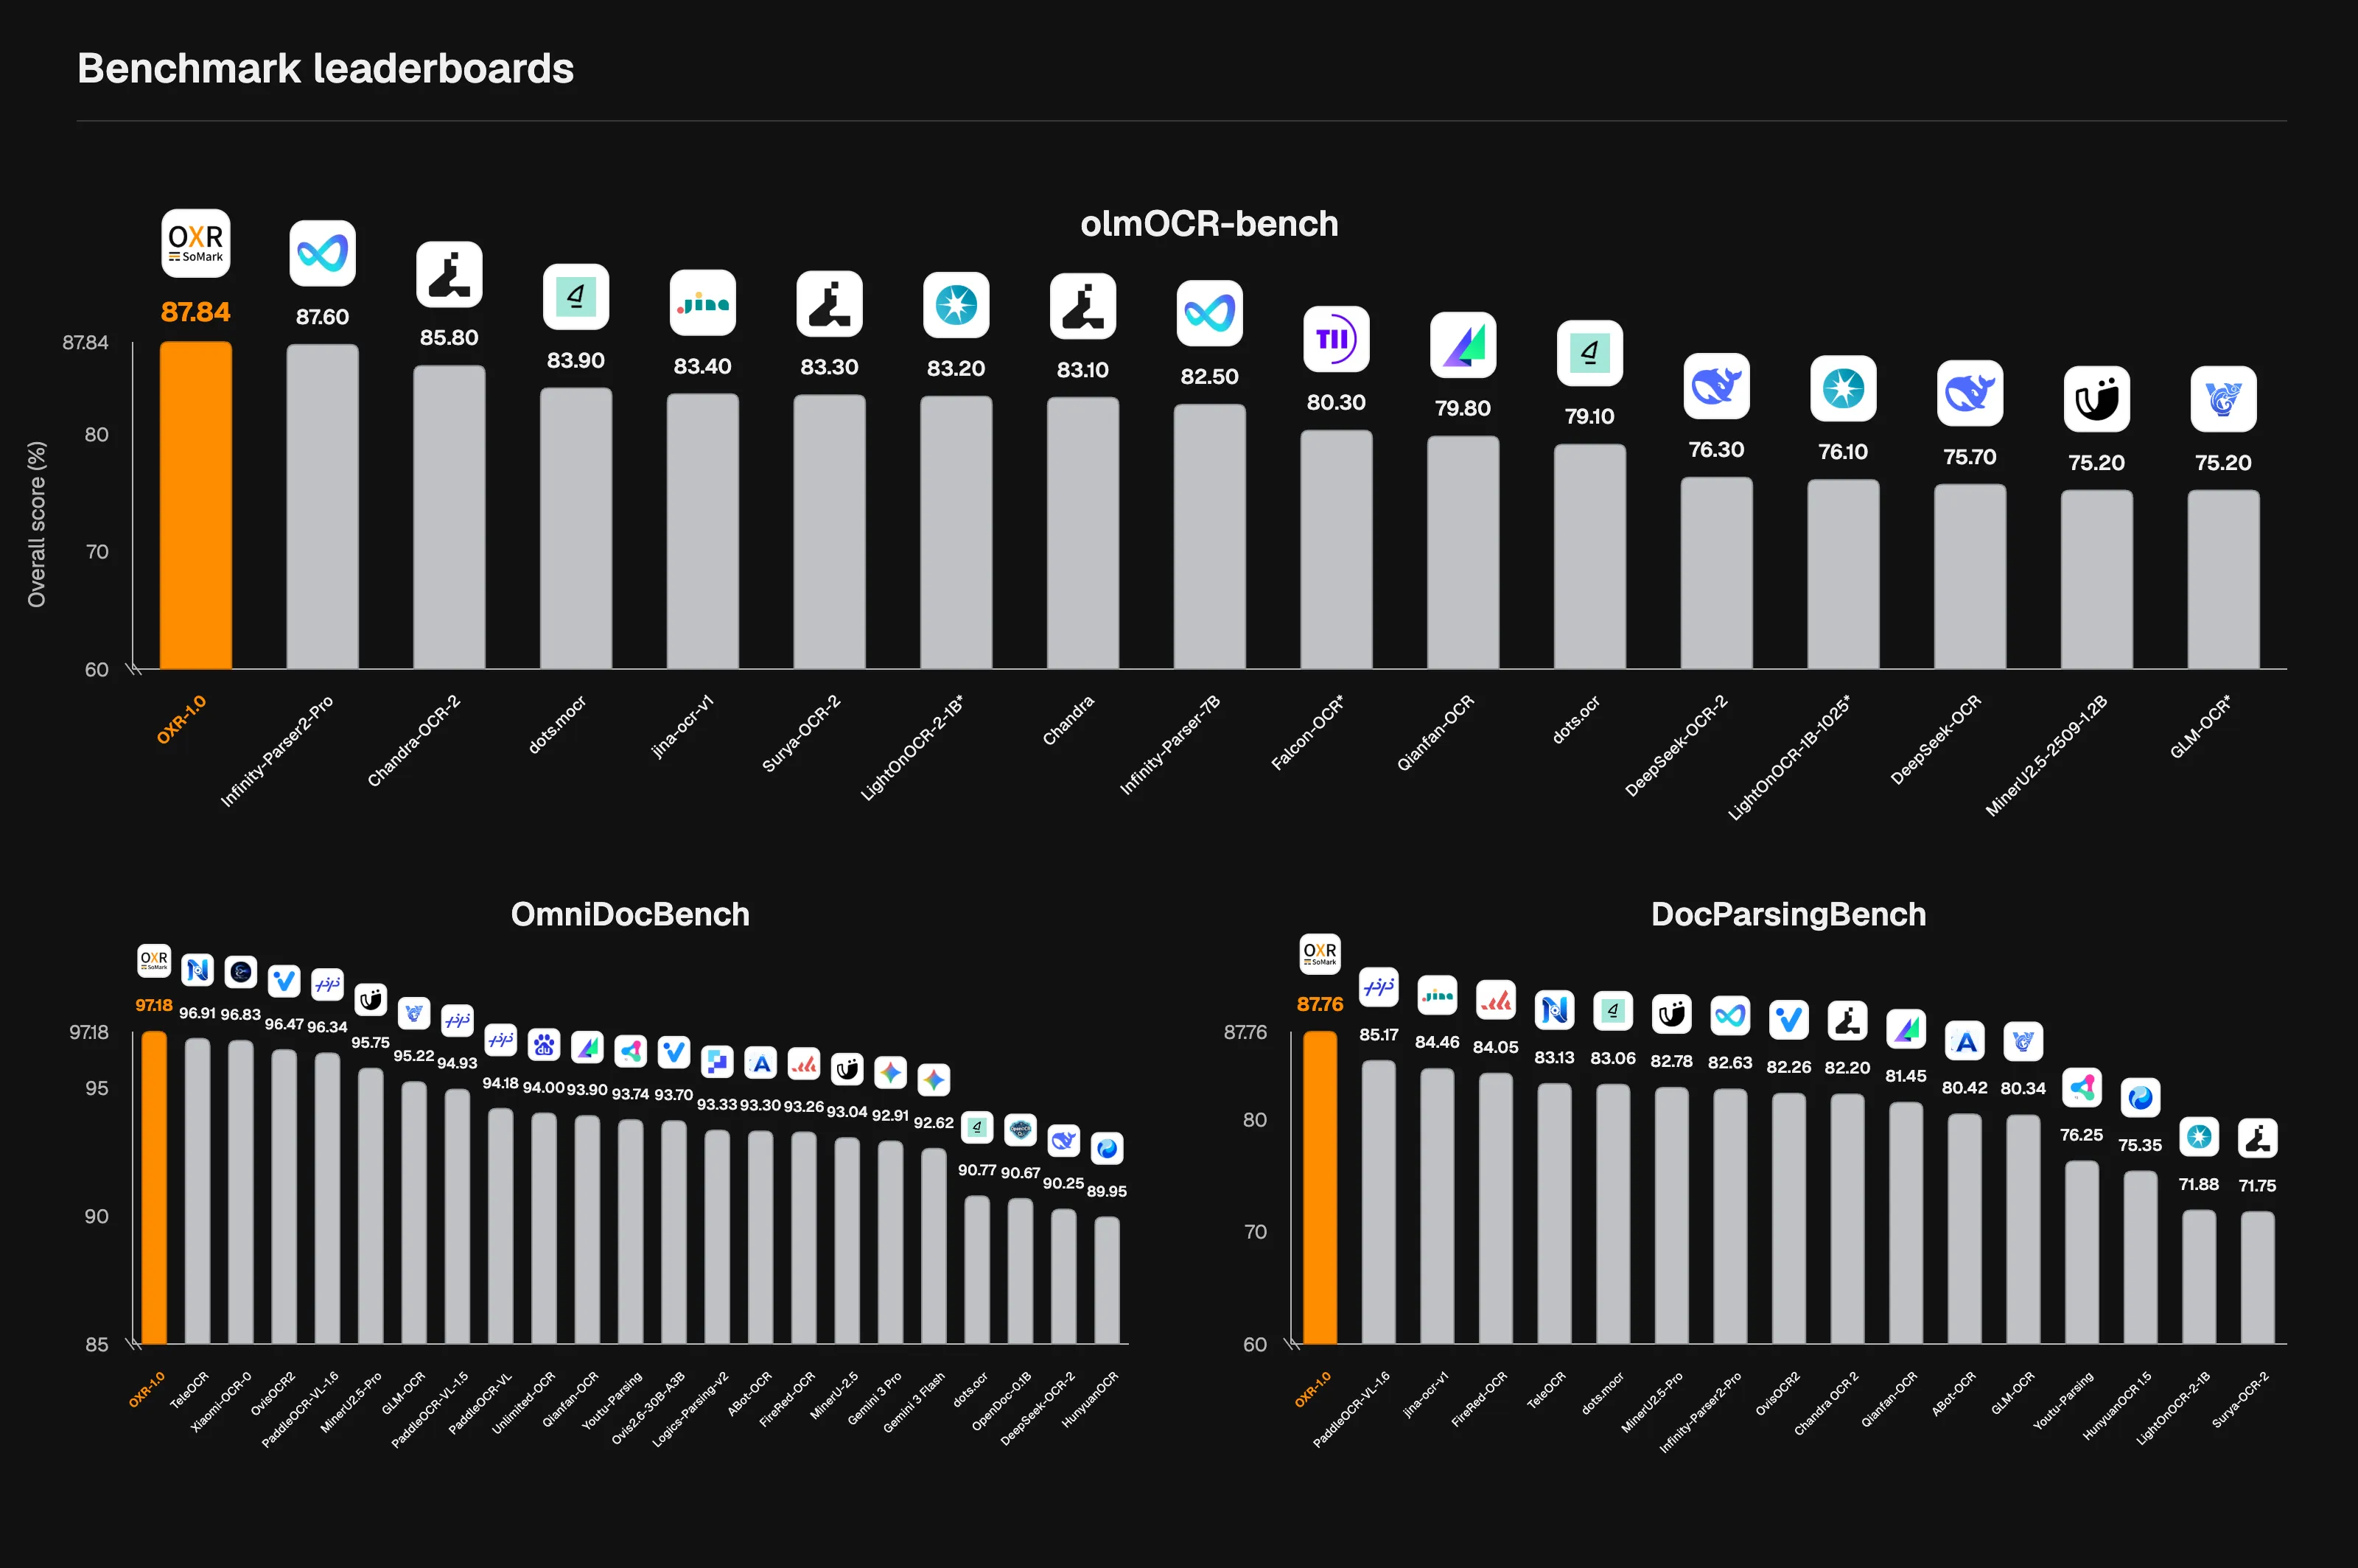
性能数据
要紧的是分清口径:这些成绩来自团队公布的评测图(上图),OXR 在其中排第一,但参测模型名单由官方选定,第三方尚未独立复测;论文标注 arXiv「Coming Soon」,暂无同行评审。三个榜单侧重不同——OmniDocBench 覆盖多种版式和阅读顺序,olmOCR-Bench 按具体检查项验证关键内容是否保留,DocParsingBench 看解析质量。速度方面官方称在 RTX PRO 6000 上是开源模型里最快的。
核心功能
OXR 从零预训练,后训练阶段用了递归自我改进(RSI)循环——官方称这在文档解析领域是首次。系统拆成两个模型:版面分析模型加识别模型,阅读顺序并进识别阶段由同一模型处理,官方称这个设计同时提了速度和精度。版面分析模块做成可插拔的,可以换自己的版面模型。1.3B 参数意味着单卡能跑,不必按 7B 级模型的显存预算来规划。
典型使用场景
- 把论文、合同、报告批量喂给 RAG 知识库的团队:公式转 LaTeX、表格转 HTML、每个块带坐标可回溯原页。
- 需要自托管、不能把敏感文档送外部 API 的场景:1.3B 参数单卡可跑,权重在 Hugging Face。
- 想替换解析后端的应用:版面分析模块可插拔,能换成自己的版面模型。
试效果不用装环境:在线 Demo 在 free-oxr.somark.ai,免注册;Free API 也无需 key,但官方明确不建议用于生产——不保证稳定性,请求排队。生产化就从 Hugging Face 拉 SoMarkAI/OXR-1.0 权重自己跑。
快速上手
pip install somark
权重从 Hugging Face 拉 SoMarkAI/OXR-1.0(官方仓库 pip install somark 起步,推理可用 vLLM,需装 README 提供的 out-of-tree 插件)。不装环境就先开 free-oxr.somark.ai 的在线 Demo,免注册上传 PDF 直接看解析结果。Free API 无需 key,但官方不建议生产使用——请求排队、无稳定性承诺。
许可证要注意
OXR 的 LICENSE 是 Apache-2.0 加附加条款,逐条读过原文:总融资或年营收超过 200 万美元的公司商用需另购商业授权;对外提供在线服务须标注「非 SoMark 官方」;不得用 OXR 经营与 SoMark 竞争的托管解析 API。个人使用、研究和未过门槛的小公司不受影响,但创业公司引入前要把这三条过一遍。
小结
OXR 适合需要把文档批量转成 Agent 可用数据的团队:公式和表格保留完整、带坐标可回溯,1.3B 的体量自托管门槛不高。判断留给你:榜单成绩目前只有官方口径,等 arXiv 论文或第三方复测出来再定不迟;商用授权的三条附加条款是引入前的必读项。GitHub 数据核验于 2026 年 11 月 1 日。