StreamEval:给实时交互视频生成做一套统一评测
StreamEval 是 Apache-2.0 的流式视频生成评测基准,五类任务、300 个用例、15 到 300 秒会话,题目与代码全部公开。
项目资料
GitHub Ecosystem- 许可证
- Apache-2.0
- 主语言
- Python
- 星标
- 125
- 核查时间
- 2026-10-23
以上快照资料以核查当日为准,可能随版本或运营策略变化。
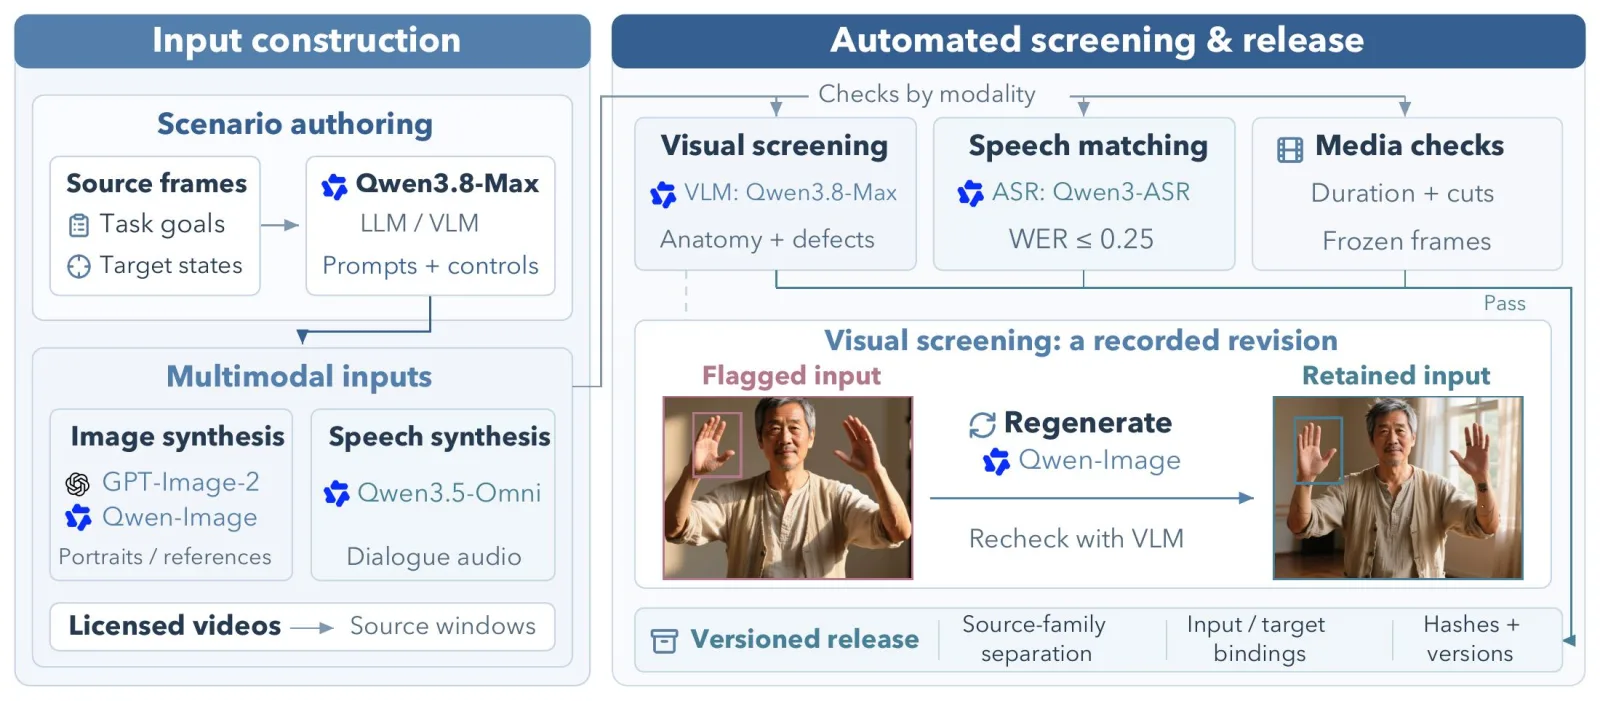
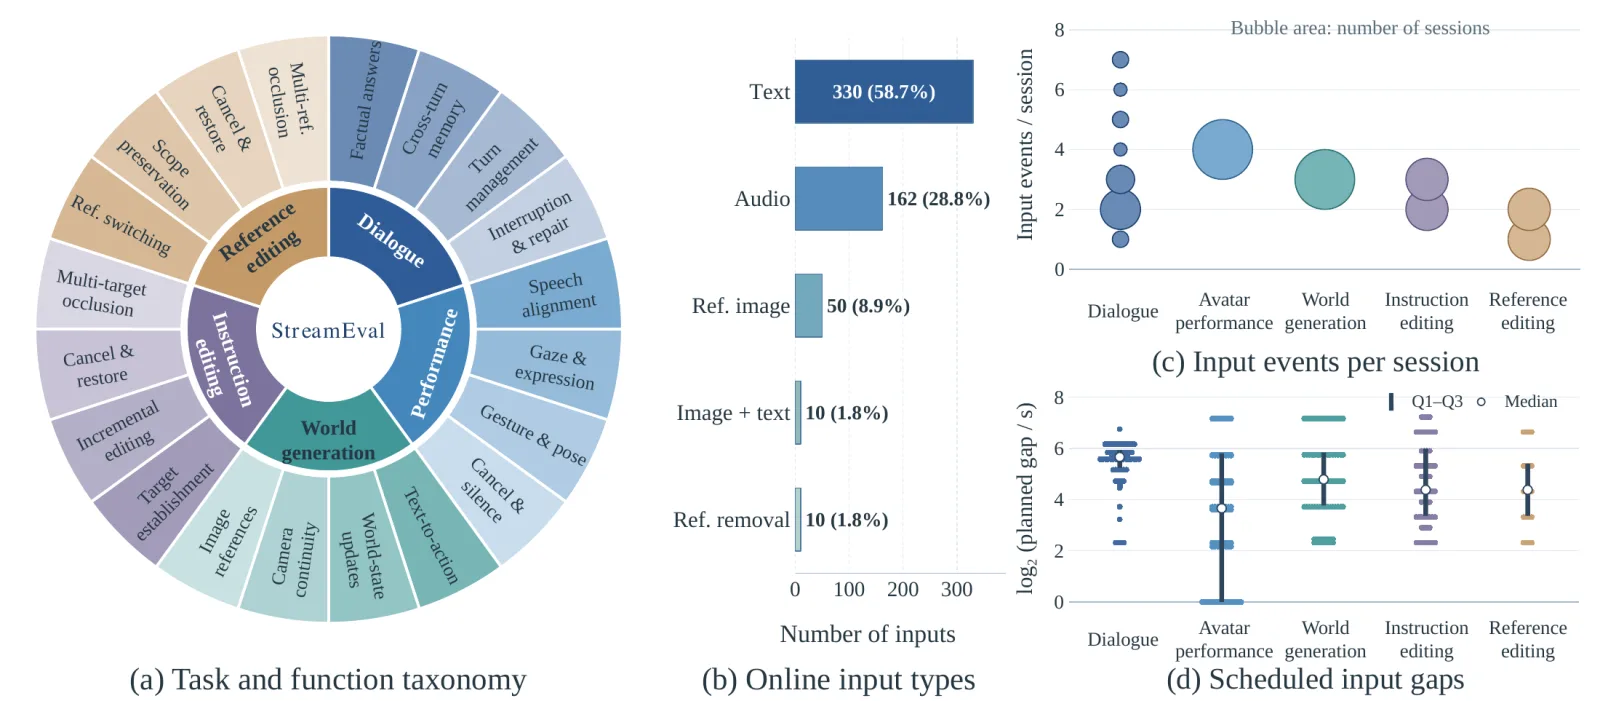
实时交互视频模型越来越多,但评测大多还是拿一段生成好的视频来看画质,看不出模型能不能连续几分钟接住新指令。StreamEval 是为此做的一套评测基准:五类任务、300 个测试用例、单场测试 15 到 300 秒,题目、代码、输入素材和评分规则全部公开。仓库是 Apache-2.0 许可的 Python 项目,2026 年 10 月 15 日创建,论文编号 arXiv:2610.28402。
核心功能
- 五类任务,各 60 个用例:数字人对话、数字人表演、世界生成、指令编辑、参考编辑。论文比较了 19 个已有基准,README 的说法是它们各自只覆盖其中一到两类,StreamEval 把它们放进同一套框架。
- 输入按时间送达:不是一次性把提示词给完,语音、文字指令、参考图和视频帧会按时间轴逐条送到模型手里,考察它能不能边接新要求边保持前后一致。
- 四维度十项指标:任务执行、状态一致性、视觉保真度、声画协调,每项 0 到 100 分。每类任务只算自己适用的指标,各自给一个 Overall,五类任务不会合并成一个总榜。
- 可复现的公开流程:所有题目、测试代码、每道题的输入素材、指令时间轴、预期结果和评分规则都开源,任何人都能用同一套材料复现。
- 官方榜单按月更新:README 说 StreamEval Team 会长期维护,每月加入新模型和已有模型的新版本。
性能数据
以下数字摘自公众号文章对论文与官方榜单的转述,我们未逐项核对榜单原始页面。文章称论文评测了 37 个模型、47 个模型任务配置,并给出一组观察:画面质量和人物一致性分数普遍较高,持续执行指令的分数明显偏低。数字人表演的 Following 最高 36.90,世界生成的 Following 最高 25.93,参考编辑的 Edit Success 最高 15.00。文章列出的分类第一包括:数字人对话与表演为 Vidu S2-Avatar(93.98、81.71),世界生成为 MemFlow(33.36),指令编辑与参考编辑为 Vidu S2-Editing(45.43、39.02)。这些分数应以 streameval.ai 的榜单和论文原文为准。
典型使用场景
- 模型团队:把自己的模型接到公开测试集上,拿同一套规则和商业模型对比。
- 研究与复现:题目和评分代码都公开,适合用来核对论文里的数字,或者检验评分规则本身。
- 选型的产品团队:按任务类型看榜单,而不是只看一个综合分,因为五类任务的指标并不相同。
如果你更关心单个视频模型的实时渲染能力,而不是评测基准,可以看 EdenLive。
快速上手
需要 Python 3.10 以上,Linux 或 macOS 都可以。第一次可以先跑 CPU 示例,它自己生成素材,不需要 API key、GPU 或下载数据集:
git clone https://github.com/StreamEval/StreamEval.git streameval
cd streameval
python -m venv .venv && source .venv/bin/activate
python -m pip install -e ".[runtime,judge,dev]"
python -m streameval.benchmark.synthetic --out .smoke
跑通后再下载完整数据,README 给出的体积约 3.1 GB,可从 Hugging Face 或 ModelScope 获取。
小结
StreamEval 适合需要横向比较流式视频模型的团队和研究者,也适合想复核这类评测方法的人。它不适合想找一个「最好模型」答案的读者:五类任务各有自己的榜单,README 明确不合并总分。
有几件事要先知道。第一,本文引用的分数来自公众号对论文和榜单的转述,我们没有打开榜单页面逐项核对,也没有读论文正文。第二,评测依赖模型输出的音视频,评分链路里包含自动筛查和评审配置,README 说同一任务下各模型使用相同的评审配置,但具体实现需要读代码确认。第三,完整数据约 3.1 GB,跑全量测试需要相应的算力和模型接口。
仓库创建于 2026 年 10 月 15 日,最近一次推送是 2026 年 10 月 22 日,未归档,截至 2026-10-23 有 125 颗星,许可证为 Apache-2.0。我们核对了 README 与仓库元数据,没有安装运行。