TokenEconomizer:让编码 Agent 按仓库学会省 token
微软开源编码 Agent 插件 TokenEconomizer:按仓库学事实、裁闲置工具、拦死循环,微软称 SWE-Bench 平均省 18.4–30.9%。
项目资料
GitHub Ecosystem- 许可证
- Apache-2.0
- 主语言
- Python
- 星标
- 7,062
- 核查时间
- 2026-11-17
以上快照资料以核查当日为准,可能随版本或运营策略变化。
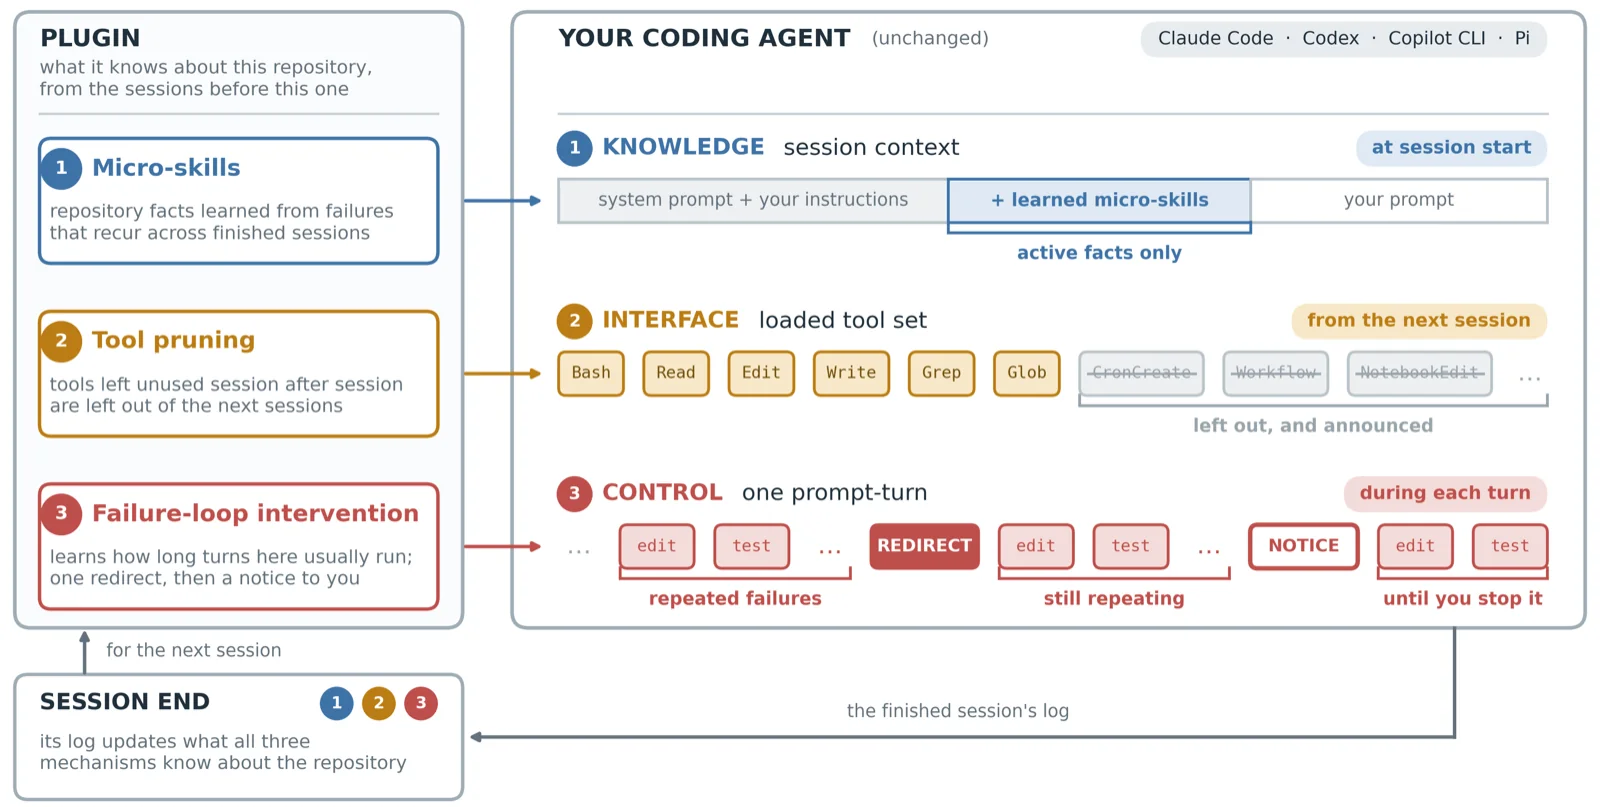
在同一个仓库里反复跑编码 Agent 的人,大多见过同一种浪费:新会话重新摸索测试命令,每一轮请求都带着几十个用不到的工具定义,卡在同一个报错上继续烧钱。TokenEconomizer 是微软研究院与 UC Berkeley 开源的编码 Agent 插件(Apache-2.0,Python),它不改模型也不改 Agent 代码,而是读取已结束会话的日志,为每个仓库学出三类策略:注入仓库事实、裁掉闲置工具、在失败循环里介入。仓库 2026-10-13 建立,截至 2026-11-17 有 7,062 星。
核心功能
- micro-skills 记仓库事实:从跨会话重复出现的失败里,以及每 3 个会话由模型复审一次提出的候选中,学出「这里得用
python -m pytest」这类一行事实;同一事实被 3 个会话确认后才在会话开头注入,之后有证据与之矛盾就丢弃。它默认关闭,因为提议本身要花模型调用。 - 工具裁剪不再发送闲置工具:某个工具在跨至少 2 个会话的 10 个提示里没被调用,或累计跨 5 个会话(不限会话长度)没用过,插件就通过 Agent 自己的设置把它移出后续会话。Claude Code 裁单个工具,Codex 裁能力包,Copilot CLI 裁整台 MCP server;
toolprune restore可以还回来,还回来的工具不会再被裁掉。 - 失败循环干预只在疑似卡住时叫模型:插件先学这个仓库正常的轮次长度,规则检查发现重复失败、错误密集或明显超长时才交给裁判模型;置信度达到 0.7 就插入一条「换个思路」的提示,每轮最多一次,仍然卡住就只提醒你按 Esc。它不会自己结束会话。
- 黑盒接入:只使用 Agent 已经暴露的指令前缀、工具加载和事件流,不碰模型权重和 agent loop;插件自己的模型调用走你当前的登录或套餐,成本计入它给出的报告。
- 数据留在本机:学到的东西存在
~/.tokeneconomizer,插件没有自己的 API key,也不接触凭据。
性能数据
微软在官方博客里给出的主结果是:同一批 277 个 SWE-Bench 任务、6 个仓库、5 组 agent–model 组合,平均成本下降 18.4–30.9%,6 × 5 共 30 个格子里全部更便宜,Pass@1 在 5 组里有 4 组上升。所有数字都计入了插件自身的模型调用成本。
| 测试(微软自测) | 结果 |
|---|---|
| SWE-Bench,277 个任务,6 个仓库 × 5 组组合 | 平均成本 −18.4% 至 −30.9%;30/30 格更便宜;Pass@1 4/5 上升 |
| Web-Bench | 成本 −16.0% 至 −21.2% |
| 安全审计基准(每个任务都是新仓库) | 成本 −6.4% 至 −19.6% |
| 单项消融,Claude Code | 工具裁剪 13.2–17.7%,micro-skills 11.8–14.3%,循环干预 5.4–7.1% |
论文与项目页还给了三组诊断,解释了钱花在哪:在 60 个 Claude Code 任务上,仓库积累到 5 个以上任务后,30% 的工具调用在重复此前任务做过的动作;每轮请求带着 23 个工具描述,其中 16 个从未被调用;17% 的失败任务吃掉了 32% 的花费。Opus 4.8 那一组的 Pass@1 掉了 1.0 个点,是五组里唯一没有提升的一组。
固定策略的对比更能说明它为什么按仓库学习。同一批任务上,压缩命令输出的 RTK 在 30 个格子里有 12 个反而更贵,成本区间 −8.9% 至 +4.5%;Aider 的 RepoMap 有 15 个格子更贵,区间 −6.1% 至 +6.5%;RTK、Serena、RepoMap 这三个固定方案都在 Django 上省钱、在 SymPy 上多花钱。
典型使用场景
- 长期维护少数几个仓库的独立开发者:同一套测试命令、同一个构建顺序、同一批用不到的工具反复出现,正好是 micro-skills 和工具裁剪能积累经验的地方。
- 按 token 计费或周额度吃紧的团队:先用
te status看几个仓库的实际账单变化,再决定是否打开默认关闭的 micro-skills。 - 想验证「省 token 插件」是否真省的人:项目自带
te savings、te status一类命令,报告里含插件自己调模型的成本,方便和不开插件时的基线对比。
快速上手
需要 Python 3.10 或更新版本在 PATH 里,以及一个已登录的受支持 Agent;插件不需要自己的 API key。以 Claude Code 为例,命令来自 README:
git clone https://github.com/microsoft/TokenEconomizer.git
claude plugin marketplace add "$PWD/TokenEconomizer"
claude plugin install tokeneconomizer@tokeneconomizer
启动 claude、信任该目录后,运行 /tokeneconomizer:status 看它在这个仓库学到了什么;每台机器装一次、以及每次 Claude Code 升级后,再跑一次 /tokeneconomizer:toolprune refresh-catalog。Codex 把 claude 换成 codex plugin,Copilot CLI 换成 copilot plugin;Pi 只有一行 pi install git:github.com/microsoft/TokenEconomizer,之后用 /te status。
支持的版本写得很具体:Claude Code 2.1.300–2.1.310、Codex 0.153.1–0.164.0、Copilot CLI 1.0.83–1.0.102、Pi 1.2.0–1.3.0,范围外不保证。Cursor、Grok Build、opencode、Hermes Agent、Antigravity CLI 和 Factory Droid 属于实验性支持,各自的缺口都写在 README 里:Grok 和 Hermes 没有工具裁剪,Cursor 报不出会话成本,Antigravity 只能学不花模型调用的事实。
小结
TokenEconomizer 适合每天在同样的仓库里跑 Claude Code、Codex 或 Copilot CLI,并且愿意让它先观察几个会话的人。它的思路和 Headroom 那种「发出去之前压缩工具输出」不同:不改请求内容,而是改下一次会话带什么进去;也不像 billion-context 那样折叠对话,而是把仓库级的经验沉淀成几行事实和一份工具名单。Apache-2.0,Python 编写,建仓一个月出头,接口还在快速变动。
有几件事需要提前知道。省下的比例是微软自测,前几个任务可能更贵,因为插件还没有该仓库的历史;micro-skills 默认关闭,打开后提议用的模型调用会计入账单。第三方实测的折扣明显更小:CyberQ 在 288 个 Claude Code 会话上测得 Sonnet 5.5 默认配置每轮省 6.2%、稳态省 10.8%,全开并修好辅助模型后为 13.0% 与 22.4%;用默认的 haiku 别名时,辅助调用实际按 Sonnet 计价,合计反而多花 2.9%,改成完整模型 ID 才回到正收益。它的测试版本 2.1.314 也在官方保证范围之外。版本窗口窄、实验性 host 多,这两点决定了它现在更像一个值得盯住的实验,而不是装完就不用管的省钱开关。