Headroom:在发给模型之前,先把工具输出压掉一半
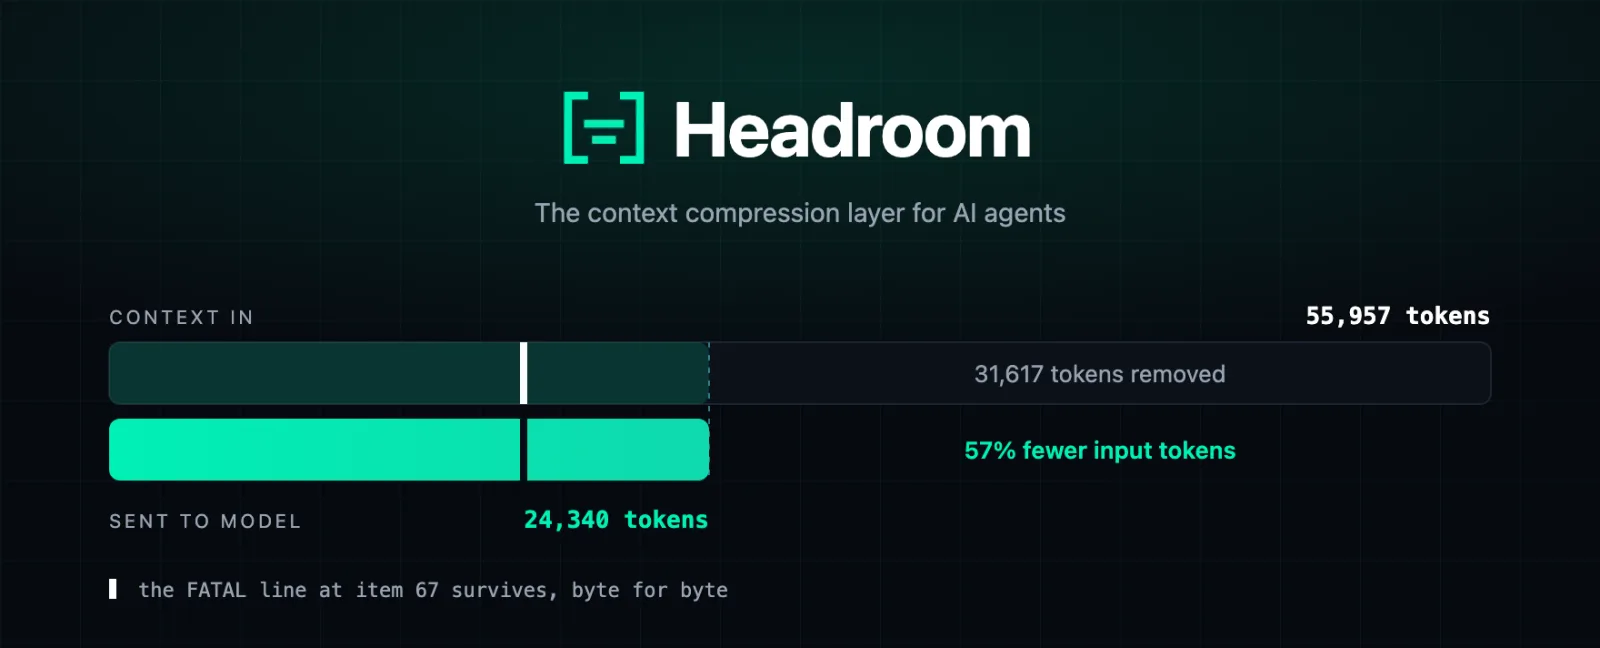
Headroom 是本机运行的上下文压缩层:按内容类型压 JSON、代码与日志,原文可回取,官方称 SRE 排障场景省 57% token。
项目资料
GitHub Ecosystem- 许可证
- Apache-2.0
- 主语言
- Python
- 星标
- 75,879
- 核查时间
- 2026-10-19
以上快照资料以核查当日为准,可能随版本或运营策略变化。
编码 Agent 的 token 账单,大头往往在工具返回的那一坨东西上:上百条搜索结果、几千行测试日志、整份 JSON、重复读过的文件。你的提问通常只占小头。Headroom 在中间加了一层本地压缩器,按内容类型分别处理 JSON、源码与散文,再把压缩后的版本发给模型。原始内容留在本机,模型需要时可以调 headroom_retrieve 取回。仓库采用 Apache-2.0 许可,主要语言 Python,截至 2026 年 10 月 19 日有 75,879 颗星。
核心功能
- 五种接入方式:Python / TypeScript 库直接调
compress(messages);headroom proxy --port 8787起一个本地代理,任何语言零改动接入;headroom wrap claude|codex|cursor|aider|opencode|cline|zcode一条命令包住 Agent;MCP 客户端装headroom mcp后可用压缩、取回、统计三个工具;也可以作为 ASGI 中间件或 LangChain、Vercel AI SDK 的适配层。 - 按内容类型路由:CacheAligner 先标出会破坏厂商 KV 缓存前缀的易变内容,ContentRouter 判断这段是 JSON、代码还是散文,再交给对应压缩器——SmartCrusher 处理 JSON 数组,保留错误项、统计上的离群值和首尾边界;CodeCompressor 按 AST 处理 Python、JS/TS、Go、Rust、Java、C/C++、C#、PHP;Kompress-v2-base 是作者自己训的文本压缩模型,权重在 Hugging Face。
- 只压新内容,保住缓存:live-zone 压缩只处理本次新增的字节,冻结的前缀保持逐字节一致,所以厂商侧的 prompt cache 仍然命中,历史也不会被丢弃。CacheAligner 只做标记,不改写提示词。
- 压缩可逆:CCR 把原文缓存在本地,模型发现信息不够时可以按需取回。这是它和「把旧消息摘要掉」最实质的区别——信息没有真的消失。
- 顺带管输出 token:输出侧有两条可选开关,verbosity steering 在系统提示词末尾加一句「简明回答、不要复述上下文」,effort routing 在模型只是接着工具结果往下走时降低思考预算;两者默认关闭,设
HEADROOM_OUTPUT_SHAPER=1打开。 - 跨 Agent 共享记忆:Claude、Codex、Gemini、Grok 可以共用一份记忆库并自动去重;
headroom learn会挖出失败的会话,把修正写进CLAUDE.local.md、AGENTS.md或GEMINI.md。
典型使用场景
- 每天跑长会话的编码用户:一次重构里反复读文件、跑测试,工具输出占了大半上下文,压缩后同一份订阅能撑更久。
- SRE 排障:把几十个服务的日志和监控输出一起喂给模型,Headroom 的测试场景里这一类压缩率最高。
- 多 Agent 协作:多个子 Agent 之间传上下文时先压一遍,减少重复传输;SharedContext 提供了现成的接口。
- 想量化省了多少的人:
headroom dashboard按工具、模型列出调用次数和节省量,headroom savings可以对自己的流量跑一遍。
性能数据
下面是 README 公布的四组场景,全部用厂商 tokenizer 和随包的 compress() 在本地跑出,脚本与随机种子都给了(benchmarks/index_proof_table.py --seed 20260902),可以自己复现:
| 场景 | 压缩前 | 压缩后 | 节省 |
|---|---|---|---|
| 代码搜索(100 条结果) | 17,199 | 13,597 | 21% |
| SRE 事故排障 | 55,957 | 24,340 | 57% |
| 代码库探索 | 58,801 | 33,895 | 42% |
| GitHub Issue 分诊 | 46,067 | 32,429 | 30% |
压缩耗时官方给的是 10K token 的 JSON 搜索结果 p50 0.21 毫秒、100K token 1.4 毫秒。准确率方面,GSM8K 与 TruthfulQA 各 100 题的结果是 ±0.000 与 +0.030,作者自己注明这个幅度落在置信区间内,算不上提升;SQuAD v2 在 19% 压缩下保持 97%,BFCL 工具调用在 32% 压缩下 97%。这些话该原样读:重复度高的负载能省九成,散文和已经很密的输出几乎压不动。
快速上手
uv tool install --python 3.13 "headroom-ai[all]"
headroom wrap claude        # 包住一个编码 Agent
headroom proxy --port 8787  # 或起一个通用代理
headroom doctor             # 检查路由是否正常
headroom dashboard          # 看实时节省(代理需在运行)
也可以只当库用:
from headroom import compress

messages = [{"role": "user", "content": "Analyze these results"}]
result = compress(messages, model="gpt-4o")
小结
它解决的是一个真实且越来越贵的问题:上下文里大部分内容是给机器读的废话,但删掉又怕丢关键行。Headroom 的做法——本地压缩、按类型分流、原文可回取、前缀保持稳定——比粗暴截断稳妥得多,75,879 颗星和 18 天省下 590 亿 token 的传播数字(后者来自推荐它的公众号,官方 README 未给出该口径)说明了需求。
要留意的边界:默认开启的匿名 beacon 会上报压缩比例、供应商与模型 ID、操作系统架构,不上传提示词、代码或路径,可用 HEADROOM_TELEMETRY=off 或 DO_NOT_TRACK=1 关闭;headroom wrap 会把流量指向默认上游,接第三方 OpenAI 兼容服务时必须传 --openai-api-url,否则会把你的 key 发到 OpenAI 并收到 401;短对话、散文和本身就很紧凑的内容几乎不省,块小于 min_input_words 时原样返回;沙箱里跑不了本地进程的环境用不上。对企业团队它区分了开源版与收费的 Enterprise,模型路由、注入检测这些能力在付费侧。和 context-mode 把工具输出关进沙箱的思路不同,Headroom 保留原文但压缩传输量,两者可以叠着用。Python,Apache-2.0。