VSR:用 AI 把视频里的硬字幕擦掉,再把背景补回来
VSR 用 PaddleOCR 定位硬字幕,再用 LAMA、STTN 或 ProPainter 补画背景,本地运行、无损分辨率,Apache-2.0。
项目资料
GitHub Ecosystem- 许可证
- Apache-2.0
- 主语言
- Python
- 星标
- 13,360
- 核查时间
- 2026-10-20
以上快照资料以核查当日为准,可能随版本或运营策略变化。
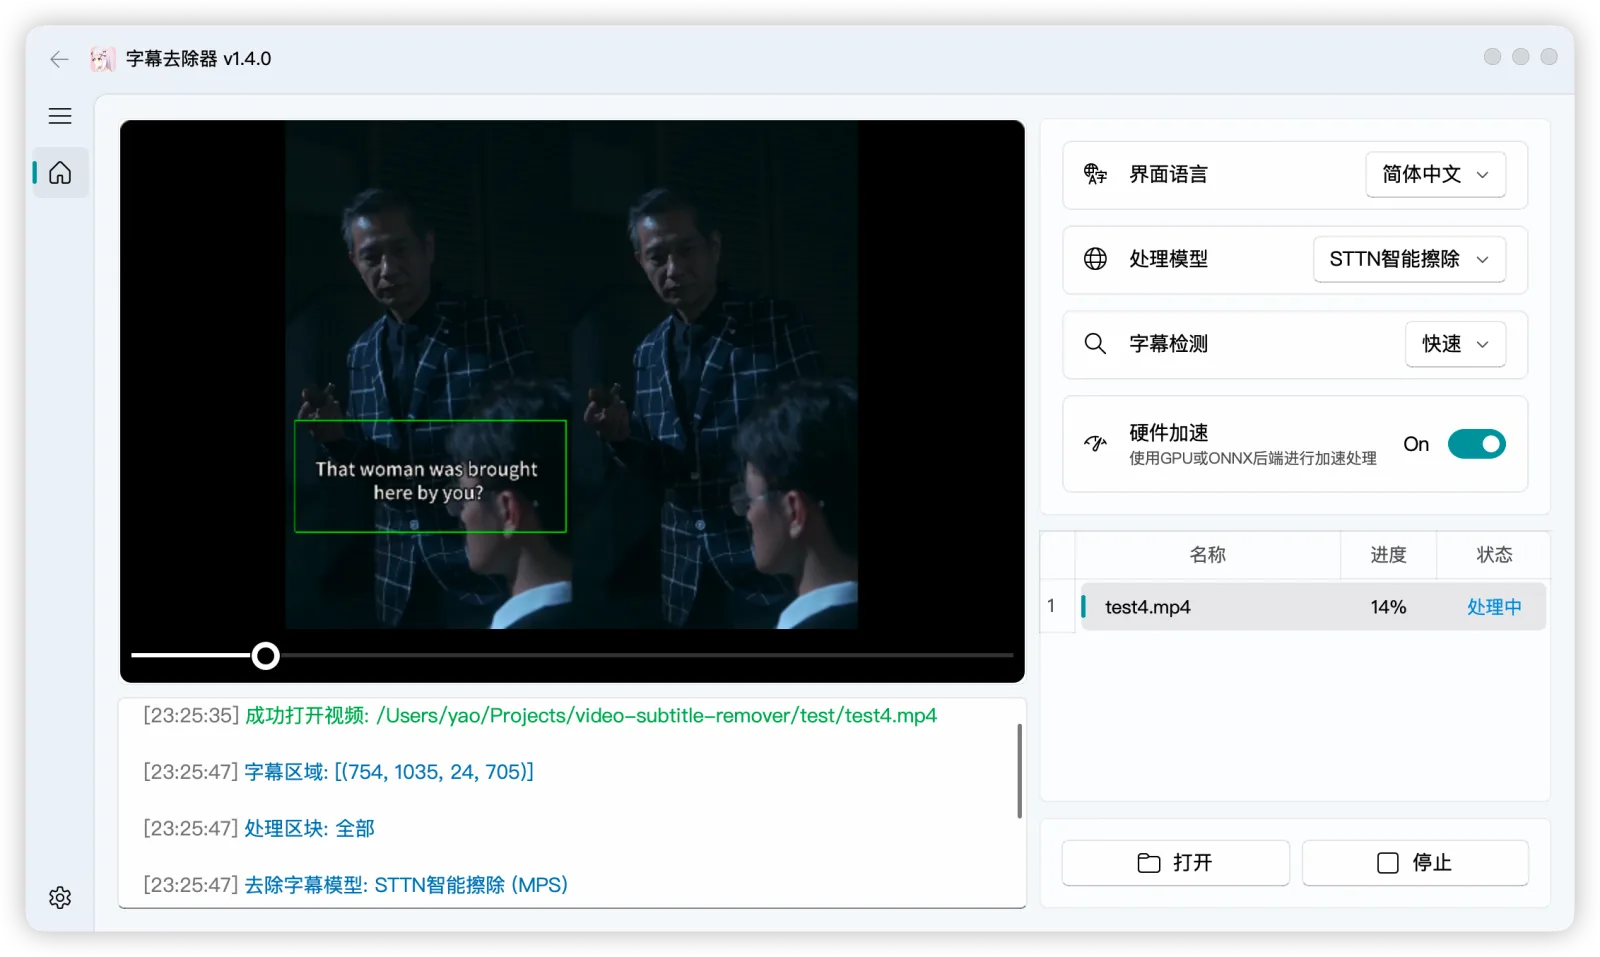
视频里烧死的硬字幕,靠裁剪或模糊处理总归会留下痕迹。Video-subtitle-remover(VSR)换了个思路:先用 PaddleOCR 找到字幕位置,再用图像修复模型把字幕盖住的背景补出来,输出的分辨率与原视频一致,不是把那一块糊掉或打马赛克。它完全本地运行,不需要申请第三方 API,支持 Windows、macOS、Linux 与 Docker。项目 Apache-2.0 开源,主要语言 Python,截至 2026-10-20 有 13,360 颗星。
核心功能
- 先定位,再补画:PaddleOCR 负责识别硬字幕区域,修复阶段可选 STTN、LAMA、ProPainter 或 OpenCV,默认是
sttn-auto。思路是从「删字」变成「补画」,所以纯色或静态背景几乎看不出痕迹。 - 无损分辨率:输出文件与原视频同分辨率,不是降采样或涂抹。
- 两种范围:可以指定字幕位置,只处理那一条区域;也可以不传位置,自动去除全视频所有文本。
- 图片也能用:支持多选图片批量去除水印文本。
- 预构建包按显卡分档:Windows 提供 CPU、DirectML(非 NVIDIA 显卡)以及 CUDA 11.8 / 12.6 / 12.8 五个版本,按显卡的计算能力选;Docker 镜像也按 10/20/30 系、40 系、50 系与 AMD/Intel 分开。
- 可配合 VSE:需要先提取字幕再处理的话,可以和同作者的 video-subtitle-extractor 搭配使用。
典型使用场景
- 搬运或二创视频要去掉原字幕:换成自己的字幕或配音,不必再裁掉画面底部。
- 处理下载素材里的硬字幕:本地跑,素材不上传。
- 批量去图片水印:同一套修复模型也能处理静态图。
- 做数据集清洗:去掉视频里的文字信息,避免模型学到字幕。
快速上手
最省事的是直接下预构建包解压运行。Windows 按显卡选对应版本:没有 NVIDIA 显卡用 vsr-windows-directml.7z,30 系及更早用 vsr-windows-nvidia-cuda-11.8.7z,40 系用 vsr-windows-nvidia-cuda-12.6.7z,50 系用 vsr-windows-nvidia-cuda-12.8.7z。也可以用 Docker:
# NVIDIA 40 系显卡
docker run -it --name vsr --gpus all eritpchy/video-subtitle-remover:1.4.0-cuda12.6 \
  python backend/main.py -i test/test.mp4 -o test/test_no_sub.mp4
命令行还可以指定修复模式:--inpaint-mode {sttn-auto,sttn-det,lama,propainter,opencv},默认 sttn-auto。要自己搭环境则需要 Python 3.11+ 与 PaddlePaddle 3.0.0。
小结
适合需要去掉硬字幕或图片水印、又不想把素材上传到在线服务的人。不适合期待「一键完美」的人:效果很看素材——纯色或静态背景几乎无痕,复杂纹理、大幅度运动或大面积遮挡仍可能留下修复痕迹。
需要注意的几点:项目最近一次推送是 2026-06-30,之后没有新提交,属于阶段性完成而非持续活跃;运行依赖 GPU 才有可接受的速度,CPU 模式会慢很多;Windows 预构建包按 CUDA 版本分档,选错版本会跑不起来。Python,Apache-2.0,13,360 星。做视频的另一头可以看本站的 Huashu Motion,那个是把动效做出来,这里是把已有的字幕去掉。