XERJ:给代码智能体本地检索后再读文件,减少整文件塞进上下文
XERJ 是 Rust 写的本地搜索引擎:autoindex 一键索引代码与文档,Agent 按片段和行号检索;兼容 ES API,内置 MCP。
项目资料
GitHub Ecosystem- 许可证
- Apache-2.0
- 主语言
- Rust
- 星标
- 8,092
- 核查时间
- 2026-10-18
以上快照资料以核查当日为准,可能随版本或运营策略变化。
让编码 Agent 用 grep 找到一行后,通常还得把整份文件读进上下文;私有代码、刚发布的 API 又不一定在模型记忆里。XERJ 是一个 Rust 编写的本地搜索服务,提供单个静态二进制:先用 xerj autoindex <文件夹> 为代码、文档、日志、PDF 和 SQLite 等建索引,Agent 再取回带文件行号的相关片段。它也实现 Elasticsearch REST API,兼容现有 ES 客户端。仓库截至 2026-10-18 有 8,092 颗星,采用 Apache-2.0 许可。
核心功能
- 先索引,再按片段取回:
xerj autoindex <文件夹>自动识别文件类型并建立数据集,不用手写 schema;代码以 tree-sitter 解析,保留符号与行号。可以检索源码、文档、日志、PDF、SQLite 和 CSV,再让 Agent 读取相关片段,而不是顺着目录逐份打开。 - 把 token 对比做成可复跑的实验:XERJ 官方 case study 测了 8 个任务、4 种语言,每种方案跑 16 次,并使用
claude -p记录结果。表中 XERJ 输出 token 为 9,982、费用 $1.58、完成 16/16;grep 驱动 Agent 为 26,477、$3.27、16/16;仅凭模型记忆为 260,916、$11.18、11/16。它是项目自己的小样本测试,不能直接推成所有仓库或模型都省同样比例。 - 复用 Elasticsearch 工具链:原生 REST API 支持 index、bulk、search、aggregation、mapping、kNN 和
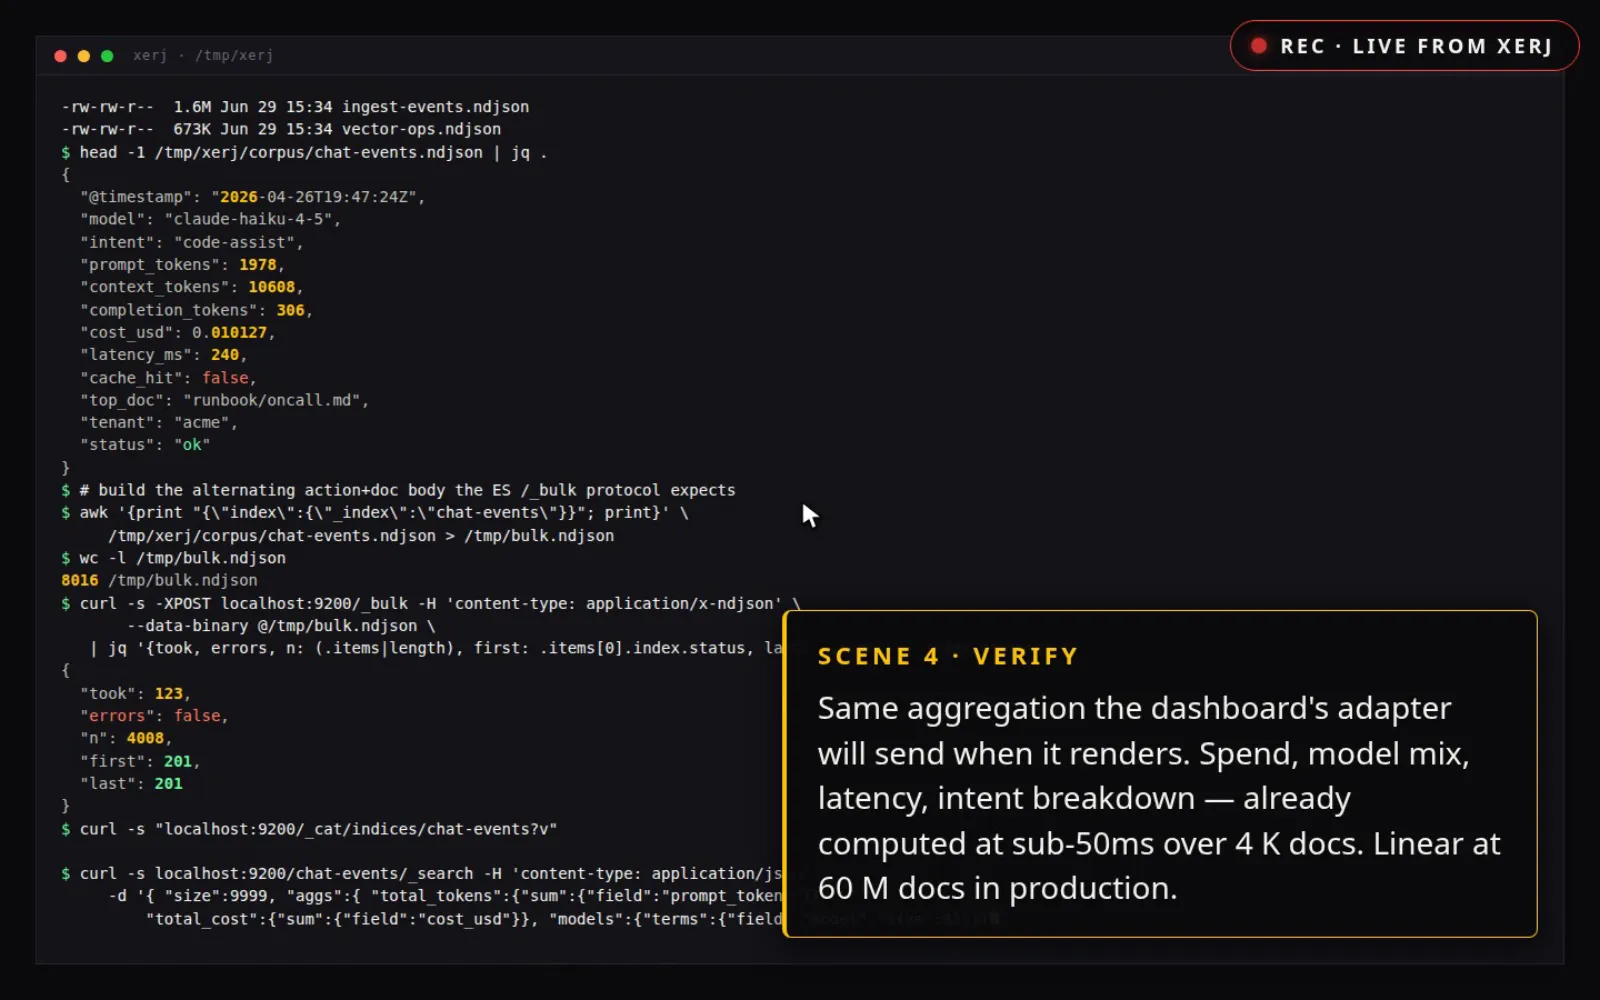
_cat等接口,官方客户端与 Kibana 可以直接指向本地服务。项目自己的 ES-YAML 一致性套件当前通过 1,366/1,369 项;README 也列出与 Elasticsearch 行为不同的边界,不能把它当成 Elasticsearch 内部实现。 - 一个二进制里带 MCP 与 Agent 记忆:
xerj init可把 MCP 与 skill 配进 Claude Code 或 Cursor;/_memory/{namespace}接口按名称空间保存跨会话信息。xerj gain统计实际检索量与节省量,而不是估算。 - 保留安全边界:不带参数启动时认证默认开启。README 示例里的
--insecure会同时关闭 TLS 和 API key;虽然新节点默认只绑定127.0.0.1,但任何能连接该端口的调用者都拥有索引的超级用户权限。共享或公网服务器应使用认证配置,不能照搬开发机命令。
典型使用场景
- 私有代码库问答:先索引内部源码,让 Agent 按函数名或问题取回
file:line片段。官方 case study 的优势主要出现在模型没记住的代码上;热门开源库已经熟悉时,仓库也承认收益可能很小,甚至带来额外开销。 - 内部文档和日志检索:将 PDF、CSV、SQLite、日志和代码放在同一个本地服务查询,适合不想先部署一整套 Java 搜索基础设施的单机开发环境。
- 给多个 Agent 接同一检索后端:通过 MCP 或 Elasticsearch 客户端复用索引;需要跨会话笔记时,再按名称空间调用
/_memory。
这类检索对敏感资料很方便,但“本地部署”不等于“默认安全”:启动时若手动加 --insecure,务必保持只允许本机访问。与 agent-s 这类管理 Agent 运行流程的平台相比,XERJ 专注数据检索与记忆;它不是用来托管或编排 Agent 的控制台。
快速上手
curl -fsSL https://xerj.org/get | sh
xerj --insecure --data-dir ./data &
xerj autoindex ~/my-project
xerj search "how do we rotate the WAL segment"
xerj gain
上述 --insecure 示例只适合个人开发机:它关闭 TLS 与认证,务必让服务只监听本机回环地址。需要共享访问时按官方安全文档启用认证。接入 Claude Code 或 Cursor 可运行 xerj init;变更安全配置前先读 README 的认证说明。
小结
XERJ 适合代码模型不熟悉的私有仓库、小众依赖、内部文档,以及希望减少 Agent 为找上下文而反复读文件的开发者。值得看的差异是检索、ES API、MCP 和持久记忆都在一个本地服务里;限制也要一起看:节省量证据主要来自项目自测和用户 field reports,不是跨模型独立基准;认证关闭时同机端口访问者拥有广泛权限;滚动查询等部分 ES 行为有明确差异。仓库为 Apache-2.0,主要语言 Rust,stats checked 2026-10-18。
进一步了解可看官方 case study、benchmark 与 security model。