DeepSeek 模型卡列 V4.1 Flash 1017:11 项基准高于旧版
DeepSeek 的 V4.1 Flash 1017 模型卡列出 11 项高于旧版的成绩;IT之家报道称网页、App 和 API 已更新,调用名与价格不变。
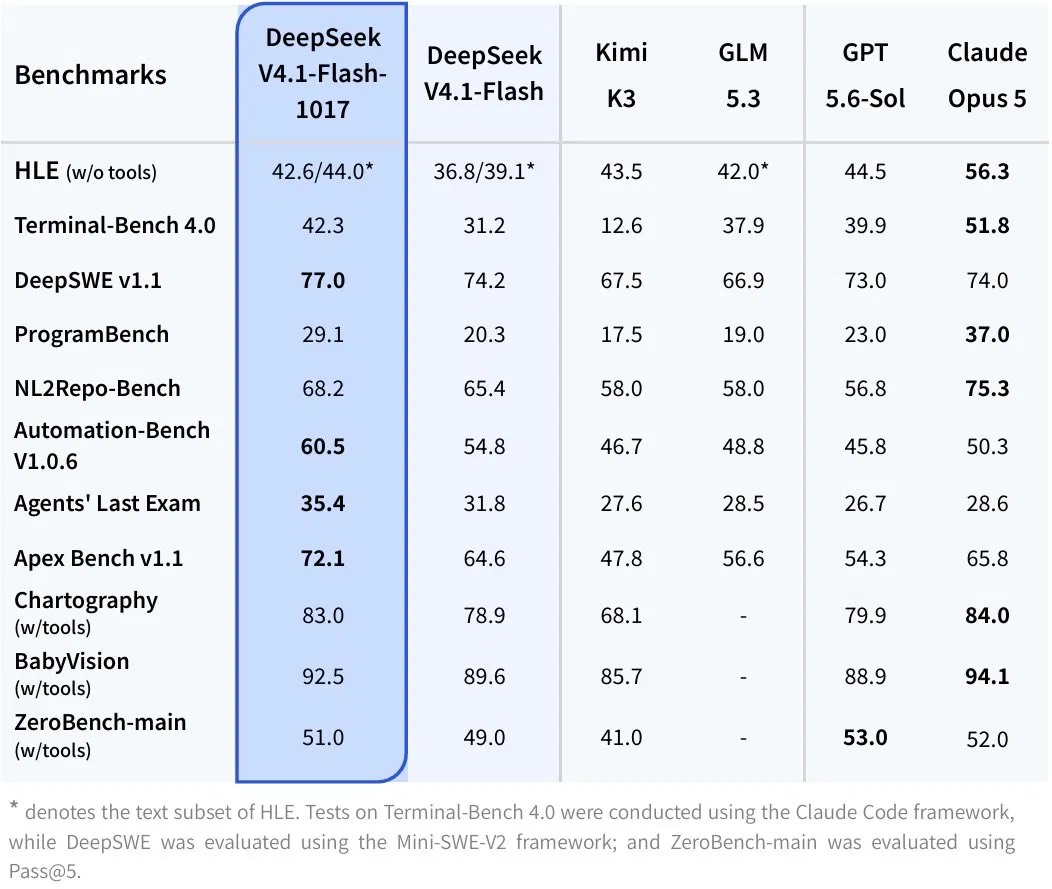
DeepSeek 的 V4.1 Flash 1017 模型卡于 2026 年 10 月 17 日创建并更新,面向编码、智能体任务和视觉基准。卡片列出 11 项成绩,逐项高于此前的 V4.1 Flash;IT之家当天报道称 DeepSeek 网页、App 和 API 已更新,API 调用名与价格不变。
要点
DeepSeek 的 V4.1 Flash 1017 模型卡列出 11 项高于旧版的基准成绩;IT之家报道称网页、App 和 API 已更新,调用名与价格未变。
- 模型卡将新快照与上一版 V4.1 Flash 放在 11 项基准中对照;新版在表列成绩上每项都更高。
- IT之家称 DeepSeek 网页、App 和 API 均已更新,API 调用名
deepseek-flash与价格没有变化。 - 模型卡只说明少数评测设置;OfficeChai 转述的任务成本来自 DeepSeek 图表,并提到 mini-swe-agent harness。
背景
DeepSeek 的 V4.1 Flash 1017 模型卡标识为 deepseek-ai/DeepSeek-V4.1-Flash-1017。Hugging Face 元数据显示模型卡于 02:40:38 UTC 创建、05:46:55 UTC 更新;RuntimeWire 页面标注发布时间为 05:08 UTC,落在创建与更新之间。RuntimeWire 报道两名用户观察到 API 可能刷新,同时指出这些观察不能证明发布了独立新模型。IT之家另报道称 DeepSeek 网页、App 和 API 已更新,API 别名仍为 deepseek-flash。这条时间线能区分模型卡创建、后续更新和媒体报道,不能把模型卡 ID 等同于 API 调用名,也不能据此称 DeepSeek 发布了独立 API 模型。
这份模型卡的基准成绩,放在编码和智能体评测竞争中更容易理解。我们此前记录过 DeepSeek 的 DSec 训练沙箱,它解释了大规模智能体训练和评测背后的运行环境;Arena 智能体榜单则展示了另一种证据:基于真实会话滚动统计的线上任务表现。两者回答的问题不同,不能拿来验证这份新模型卡的基准分数。
模型卡同时给出了权重和使用信息。它标注 MIT 许可证、7630 亿参数,权重文件总计约 510.3 GB,并建议使用 100 万 token 上下文窗口。这个体量让“权重开放”与“个人电脑能否轻松运行”成为两件事;页面列出 Transformers、vLLM、SGLang 等部署路径,但没有声称本地部署只需普通显卡。
DeepSeek V4.1 Flash 更新
DeepSeek V4.1 Flash 1017 的基准表主要回答“新版相对旧版变了多少”,而不是给出统一、可直接套用到每个应用的质量分。以下数据按模型卡截至 2026 年 10 月 17 日的表格整理;括号中的 † 是 HLE 的纯文本子集成绩。
| 基准 | V4.1 Flash 1017 | 旧版 V4.1 Flash | Opus 5 |
|---|---|---|---|
| HLE(无工具) | 42.6(44.0†) | 36.8(39.1†) | 56.3 |
| Terminal-Bench 4.0 | 42.3 | 31.2 | 51.8 |
| DeepSWE v1.1 | 77.0 | 74.2 | 74.0 |
| ProgramBench | 29.1 | 20.3 | 37.0 |
| NL2Repo-Bench | 68.2 | 65.4 | 75.3 |
| Automation-Bench v1.0.6 | 60.5 | 54.8 | 50.3 |
| Agents’ Last Exam | 35.4 | 31.8 | 28.6 |
| Apex Bench v1.1 | 72.1 | 64.6 | 65.8 |
| Chartography(使用工具) | 83.0 | 78.9 | 84.0 |
| BabyVision(使用工具) | 92.5 | 89.6 | 94.1 |
| ZeroBench-main(使用工具) | 51.0 | 49.0 | 52.0 |
这张表显示新版在 11 项上都超过旧版,但与 Opus 5 的相对表现并非单向领先:DeepSWE、Automation-Bench、Agents’ Last Exam 和 Apex Bench 的新模型成绩较高,HLE、Terminal-Bench、ProgramBench、NL2Repo、Chartography、BabyVision 和 ZeroBench-main 则较低。不同基准测量的任务和工具环境不同,不能把其中一项的优势概括成所有编码或视觉工作都更好。
官方披露的评测设置有限。模型卡注明 Terminal-Bench 4.0 使用 Claude Code framework,DeepSWE v1.1 使用 Mini-SWE-V2 framework;HLE 的 † 表示文本子集成绩。页面没有进一步给出其他测试的完整提示词、采样参数、运行环境、重复次数和误差范围。
权重信息与在线调用也要分开。模型卡的 MIT 标注说明权重页面声明的许可证;IT之家报告网页、App 和 API 已切换,调用别名与价格维持原状。公开模型卡没有给出一次在线请求的现行价格,也没有列出托管推理服务,因此不能从 510.3 GB 的权重大小推导 API 单次成本或可用性。
各方说法
DeepSeek 的模型卡将更新描述为编码、智能体和视觉能力提升,并称执行时间与输出长度有所下降。模型卡给出了与旧版及其他模型的成绩对照;IT之家另行报道网页、App、API 的更新状态。OfficeChai 的成本数字则来自 DeepSeek 图表。现有这些材料能说明各来源公布了什么,不能据此推断没有其他独立评测。
IT之家从产品可用性的角度补充了模型卡没有回答的部分:截至其 10 月 17 日报道,网页版、App 和 API 已更新,API 仍可使用 deepseek-flash,价格未变。这里的“已更新”是媒体报道的产品状态;如果团队部署依赖固定模型行为,仍应在自己的账户和请求链路里确认别名实际指向的版本,因为公开别名本身没有给出版本锁定承诺。
OfficeChai 进一步解读了一张 DeepSeek 任务成本图,讨论在 DeepSWE v1.1 上准确率与成本的关系。该报道称,最低推理强度时,成绩超过 72% 的任务成本约为每项 0.15–0.20 美元;最高设置达到 77% 时,每项低于 0.25 美元。它也将结果与 Opus 5 的高推理设置作比较。成本点来自 DeepSeek 图表,报道提到 mini-swe-agent harness,但没有给出足以复算的输入、输出 token、运行次数或失败任务计费规则;OfficeChai 没有称这些数字是其自行跑出的结果。
编辑判断
DeepSeek V4.1 Flash 1017 对开发者的实际意义,要从两类可核对材料分别判断:模型卡列出一组带日期的权重与成绩,IT之家则称网页、App 和 API 已切换,API 别名与价格不变。正在维护代码代理或自动化流程的团队,可以将模型卡里的新快照与现有基线对照,再用自己的任务集测试当前 API 返回结果。公开信息没有说明 deepseek-flash 是否提供版本锁定,因此生产环境应先观察调用行为和回归情况。
目前表格显示,模型卡列出的新快照在 11 项基准上都高于旧快照。这个对照本身不代表对竞品的全面胜出。OfficeChai 转述的成本曲线可供需要批量运行智能体的团队参考,但公开文章没有列全复算条件;实际费用还取决于提示长度、工具调用、失败重试和使用的 harness,不能把图表上的单点直接当作自己的预算。
权重页面标注 7630 亿参数和约 510.3 GB 文件,也列出 Transformers、vLLM 和 SGLang 等部署路径;这些信息给有算力与运维条件的团队提供本地评估选项。IT之家报道网页、App 和 API 均已更新,API 价格未变。价格信息没有回答延迟、稳定性、隐私要求或别名指向是否固定,选择线上还是本地路径仍应按团队的约束决定。
怎么试
想快速感受本次更新,可以先打开 DeepSeek 网页版或 App,选择 Flash 对话并用一段自己熟悉的代码修改或多步任务测试。IT之家称这些入口已更新,测试时记录具体日期、输入、是否启用工具和结果;短对话不能代替基准,也不要把一次回答当成稳定性结论。
如果原有程序走 API,IT之家称调用别名仍为 deepseek-flash、价格没有变化。可在不改动其他依赖的测试环境里,用同一组提示和工具配置分别记录旧结果与当前结果;DeepSeek 模型卡则提供本地权重与 Transformers、vLLM、SGLang 等部署入口。部署前先核算约 510.3 GB 权重的存储和运行资源,并确认所用推理框架支持这份模型。