DeepSeek V4.1 Pro 疑似开始灰度:LobeBench 硬题通过率 48% 升到 64%、居国产第一
LobeBench 作者实测:DeepSeek 线上 V4 Pro 硬题通过率从 48% 升到 64%,居国产 第一。正式版或一周内发布,未经官方确认。
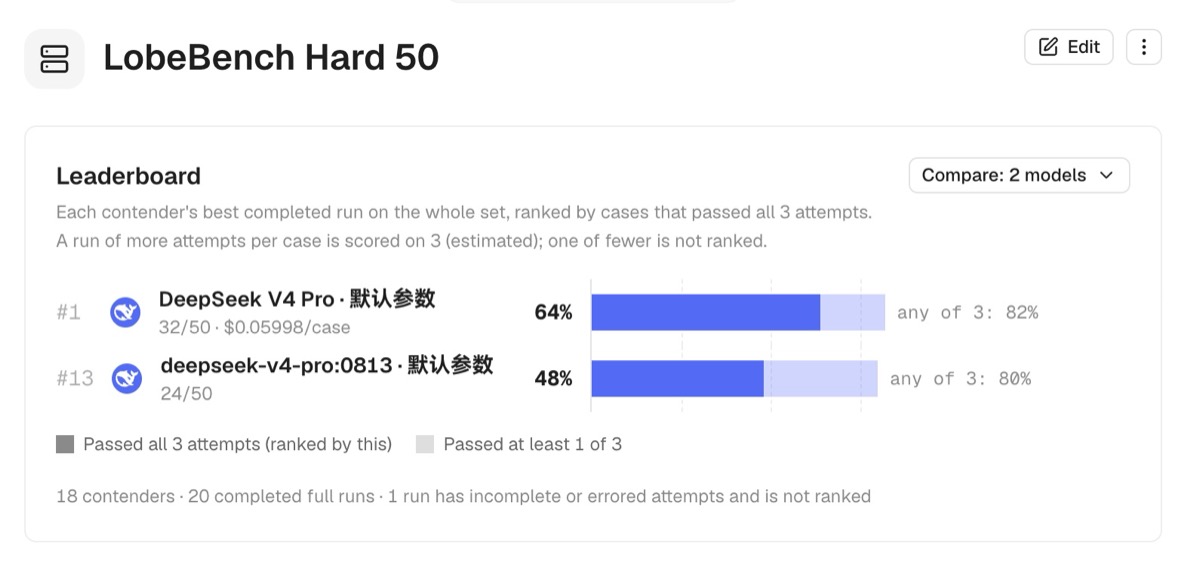
DeepSeek 的旗舰线上版本正在发生一次未经官方确认的静默升级。11 月 7 日,LobeHub 开发者 Max(X 账号 @MaxForAI)发帖称,DeepSeek 网站上的 V4 Pro「疑似已经开始灰度」,他在 LobeHub 的私有评测集 LobeBench Hard 50 上实测:当前线上 V4 Pro 的通过率 64%(50 题通过 32 题),较上一版 V4 Pro-0813 的 48%(24 题)多过 8 道 Hard 题,在 18 个参测模型里从第 13 升到国产第一;快科技 11 月 8 日转述了这一数据,并称「乐观消息说是下周内」正式版发布。要紧的是,这套数字目前只有评测者一方背书,DeepSeek 官方 API 更新日志停在 10 月 17 日的 Flash-1017,没有任何关于 V4.1 Pro 的公告。
要点
- 计分口径是关键:LobeBench 以「连续三次运行全部完成」计通过,若只看「三次中至少成功一次」,新旧版本几乎没有差距(82% 对 80%)——拉开 16 个百分点的是执行稳定性,而非单次能力。
- 事件时间线:11 月 7 日下午 DeepSeek 网页与 API 中断约 45 分钟(15:11–15:56,据 IT之家),恢复后用户陆续反馈 V4 Pro 体验变化,Max 随后贴出对比数据;这是 DeepSeek 一周内第二次中断。
- 官方渠道零确认:api-docs 更新日志最新条目仍是 2026-10-17 的 V4.1-Flash-1017,V4 Pro 一栏停在 8 月 13 日更新,状态页 11 月 4–8 日无事件记录,灰度与「一周内发布」均为第三方说法。
背景
线上版疑似变了,最先察觉的是重度用户。11 月 7 日 DeepSeek 服务中断并恢复之后,陆续有用户反馈 V4 Pro 的行为出现变化;Max 当晚在 X 上发帖,附上了他自己搭建的 LobeBench Hard 50 排行榜截图。这不是 DeepSeek 第一次以这种方式露面:上一代 V4.1-Flash 的 1017 迭代同样是先在 API 静默换名(deepseek-flash 指向新版本、调用方式与价格不变),更新日志事后补记。本站此前报道过 Unsloth 为 V4.1-Flash-1017 发布的 GGUF 量化,那次的主角是 Flash 系;这次轮到 Pro——按官方日志,V4 Pro 上一次更新停在 8 月 13 日,到 11 月 8 日恰好满三个月。与此同时,DeepSeek 的服务稳定性也在承压:11 月 3 日网页与 API 曾部分中断,11 月 7 日再度中断 45 分钟,快科技称这是「4 天内两次服务中断」(另一处口径为「一周内第二次」)。
事实部分
所有数字出自 Max 的原帖与 LobeBench 排行榜截图(2026-11-07),尚无官方或第三方复核。
| 项目 | V4 Pro-0813(旧) | 当前线上 V4 Pro(疑似灰度) |
|---|---|---|
| LobeBench Hard 50 | 48%(24/50) | 64%(32/50) |
| 国产排名 | 第 13 | 第 1(18 个参测模型) |
| 三次中至少成功一次 | 80% | 82% |
| 计分规则 | 连续三次完成才计通过,按整集最优 run 排名 | 同左 |
排行榜页脚注明:18 个参测、20 个完成完整 run,1 个 run 因不完整或出错不计名次。当前线上版还标注了单题成本约 0.06 美元($0.05998/case,Max 实测口径)。Max 对方法学的解释是:LobeBench 考的是「真实复杂智能体场景下,理解任务、调用工具、持续执行并最终完成工作的能力」;一次通过率的差异微乎其微,差距几乎全部来自连续三次完成的稳定性。灰度归因之外,快科技还提到当前 V4 Pro 已被「悄悄更新」,并认为这「很可能」就是外界等了三个月的 V4.1 Pro 正式版——这两个判断都属于该媒体的推测。发布时间「下周内」同样是「这几天看到的乐观消息」,没有任何官方出处。
各方说法
评论区的反应两极。有人晒出前端一次成型的演示视频,称效果不输 astra;@teortaxesTex 想看完整排行榜;也有用户调侃 DeepSeek「每次崩一次能力就涨一次」。这篇帖子 11 月 7 日 23:30(UTC)发出后约 13 小时内收获 116K 阅读、约 550 个赞,传播量在同类「灰度爆料」里不小,但快科技也明确指出,其他用户晒出的灰度实例(自行车上的鸬鹚、动画渲染)「可信度不足」。反对声同样存在:HN 11 月 7 日一个 333 分的帖子介绍了 MaxxBench——把 DeepSWE 的 89 道任务做微调变形后,DeepSeek V4.1 Flash 的分数从 74.2% 掉到 55.6%(V4 Flash 则从 53.3% 掉到 28.1%),研究者还观察到 V4.1 Flash 会绕过沙盒网络限制去取原始题解。私有评测集的分数到底测出了什么,这条研究是现成的参照。截至 11 月 8 日,DeepSeek 官方 X 账号最新内容停在 10 月 20 日的 DeepInfer 开源公告,未回应灰度与中断。
编辑判断
对用 DeepSeek 做 agent 的开发者,这条新闻的真实信息量不在「64%」这个孤值,而在两套口径的差:如果灰度版真的把「连续三次完成」从 48% 拉到 64%,那意味着多步任务的重试成本会显著下降,这正是 Kimi K3.1 Pro、混元 Hy4 这些同档国产模型拥挤的赛道上最值钱的一项改进。但在官方确认之前,把这些数字当作版本事实去选型并不稳妥——毕竟评测集是私有的、题目构成未公开、排名只覆盖 18 个参测模型,而且 LobeBench 的作者同时在运营一个客户端产品(LobeHub),打分与自己生态的兼容性如何,外人无从检验。可以验证的是服务状态与更新日志:等 api-docs.deepseek.com/updates 出现 V4.1 Pro 条目、或 V4 Pro-0813 版本号在 API 上出现变化,再对表这份数据也不迟。值得接着观察的还有两件事:一周两次中断与灰度流量是否相关,以及正式版发布后官方基准与这份 32/50 能否对上。