谷歌把语音识别与合成搬到端侧:识别 100+ 语言,合成 100 毫秒开口
谷歌上线端侧语音:ASR 支持 100+ 语言、10 倍实时;TTS 约 100 毫秒开口、24kHz,模型由系统管理,APK 零体积。
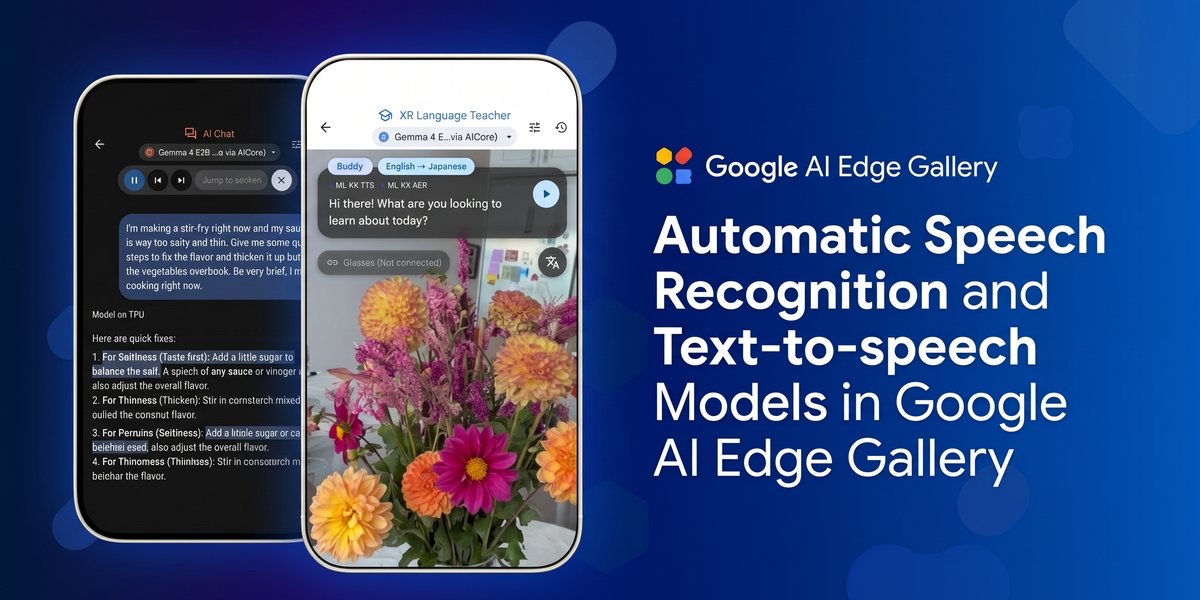
谷歌 11 月 10 日在开发者博客宣布,AI Edge Gallery 现已支持离线的端侧语音识别(ASR)与语音合成(TTS),可配合 Gemini Nano、Gemma 4 等端侧小模型构建语音应用。与此前需要联网的语音方案不同,这两套模型都跑在设备本地:识别、合成与对话可以完全离线完成,数据不出设备。
要点
- 识别:100+ 语言、10 倍实时:ML Kit 的 GenAI 语音识别在 FLEURS 上取得 8.0%–9.0% 的 WER,转写速度约为实时的 10 倍(3 秒语音约 300 毫秒),端到端语音翻译的等待时间缩短约 35%–44%。
- 合成:约 100 毫秒开口:TTS 采用少步扩散模型并在 NPU 上加速,开口延迟约 100 毫秒,输出 24kHz 音频,最高 50 倍实时,提供 8 种音色、21 个语区;官方称合成 27 秒的段落约需 500 毫秒,功耗比传统自回归 TTS 低 50% 以上。
- 零 APK 负担与跨平台:两套模型通过 AICore 由系统统一管理,APK 体积增加 0 MB;跨平台侧则提供 MediaPipe Tasks 与 LiteRT 的
.litertlm模型包,包括 Parakeet-TDT 0.6B、PocketTTS 100M、Kokoro-82M 与 Phonon 31M,可在与端侧小模型并行时保持较低内存占用。
发布背景
过去两年,语音能力大多以云端 API 的形式提供:识别准确、但依赖网络,且每次调用都要把音频上传。端侧方案的价值在于延迟、隐私与成本三件事同时改善——音频不出设备,识别不必等网络往返,调用也不按 token 计费。
谷歌这次给出的是两条集成路径。一条是 ML Kit 的 GenAI Speech Recognition 与 Text-to-Speech API:原生、仅 Android、模型由 AICore 管理,开发者不用处理模型下载与更新,APK 也不会因为语音模型膨胀。另一条是 MediaPipe Tasks 加 LiteRT 的开源权重方案,覆盖 iOS、macOS、Windows、Linux 与 Web,适合需要跨平台或用自定义模型的产品。
值得注意的是模型包的尺寸梯度:Parakeet-TDT 0.6B、PocketTTS 100M、Kokoro-82M、Phonon 31M,从服务端级精度到几十兆的轻量合成都有覆盖。团队可以按目标设备的内存与延迟预算挑组合,而不是被单一模型锁死。
谁现在能用
Android 开发者可以直接调用 ML Kit 的 GenAI 语音接口;跨平台团队可以从 LiteRT 的 .litertlm 模型包起步,把 Parakeet、PocketTTS、Kokoro 或 Phonon 接进现有管线。想在手机或桌面端先感受效果,可安装 AI Edge Gallery,其 AI Chat 已加入麦克风输入与朗读,支持选择引擎、音色与语言,并会随朗读高亮句子。
怎么看
- 数字是谷歌自测:WER、10 倍实时与 100 毫秒开口都基于谷歌的模型与设备组合,换到你的机型、语言与麦克风条件会有差异,建议先用真实音频试一轮。
- 系统级管理改变分发方式:模型随系统走意味着应用体积不变、更新由系统负责,但也意味着可用性依赖设备与系统版本;跨平台产品仍需 LiteRT 路径兜底。
- 与端侧小模型组合才是完整形态:识别与合成只是入口,真正的语音助手还需要对话模型;谷歌给出的组合是 Gemini Nano 或 Gemma 4,这与 Ming 3.0 全栈音频 这类自托管方案形成两条不同路线。
编辑摘要
如果你的应用要做离线转写、语音输入或朗读,现在有两条可评估的路径:Android 原生用 ML Kit + AICore,跨平台用 MediaPipe Tasks + LiteRT 开源权重。先用目标设备测延迟与功耗,再决定是否把语音链路从云端迁到端侧;谷歌的数字提供了上限参考,实际体验取决于设备与语种。对隐私敏感的离线场景,这条路值得优先评估,尤其是会议室、车载与可穿戴设备。