Ming-3.0-tts:开源语音合成模型,支持零样本音色克隆
Ming-3.0-tts 是 MIT 许可的开源语音合成仓库,提供 0.5B 与 tiny 两个版本,支持零样本音色克隆,并附推理代码与评测表。
项目资料
GitHub Ecosystem- 许可证
- MIT
- 主语言
- Python
- 星标
- 120
- 核查时间
- 2026-10-21
以上快照资料以核查当日为准,可能随版本或运营策略变化。
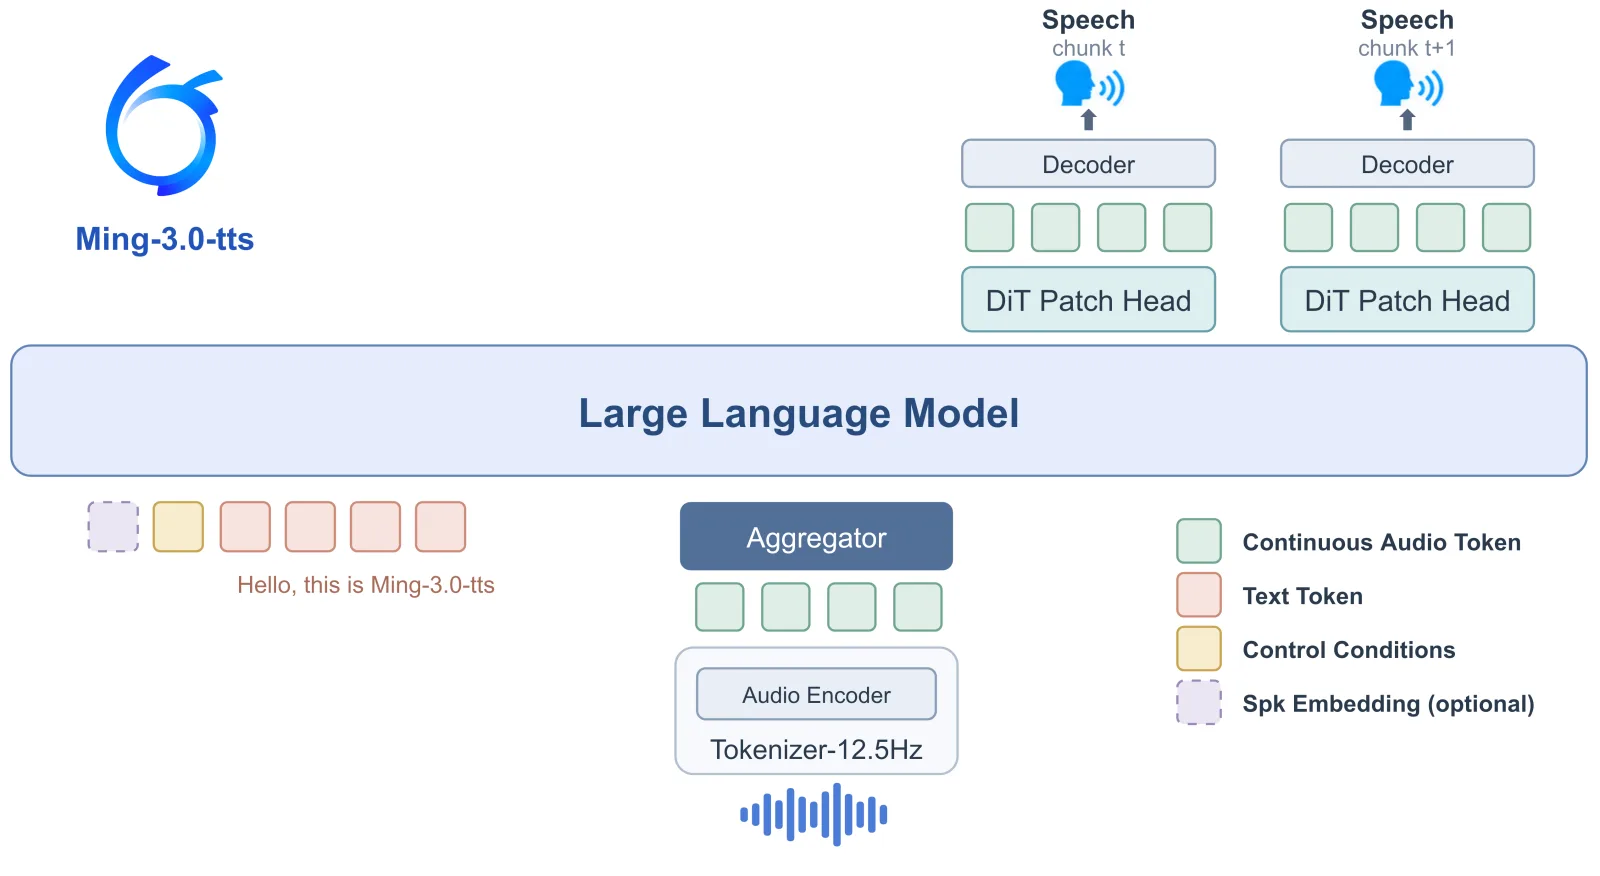
Ming-3.0-tts 是 inclusionAI 组织在 2026 年 10 月发布的开源语音合成仓库。仓库里有两个模型:0.5B 的稠密模型,以及 tiny 版本,后者是 MoE 结构,总参数 7.9B,激活参数 1.3B,基于 Ling V3。两者都以 MIT 许可发布,附带推理代码、任务示例和评测表。一则中文新闻速递把这一系列归到蚂蚁百灵名下,系列里还有语音识别和音频理解的其他仓库。
核心功能
- 两个模型,两种结构:0.5B 为稠密模型,tiny 为 MoE 模型。两者都发布在 Hugging Face 和 ModelScope 上,README 说在中国大陆 ModelScope 通常更快。
- 音色克隆与设计:可以用一段参考音频做零样本克隆(
prompt_wav_path),也可以用文字描述设计音色,或从内置的 100 多个中文音色和五个英文音色里选。 - 情绪与韵律控制:可以指定情绪,也可以调整语速、音高和音量。
- 多人对话(仅 tiny):给出脚本和说话人参考,直接生成多人对话。
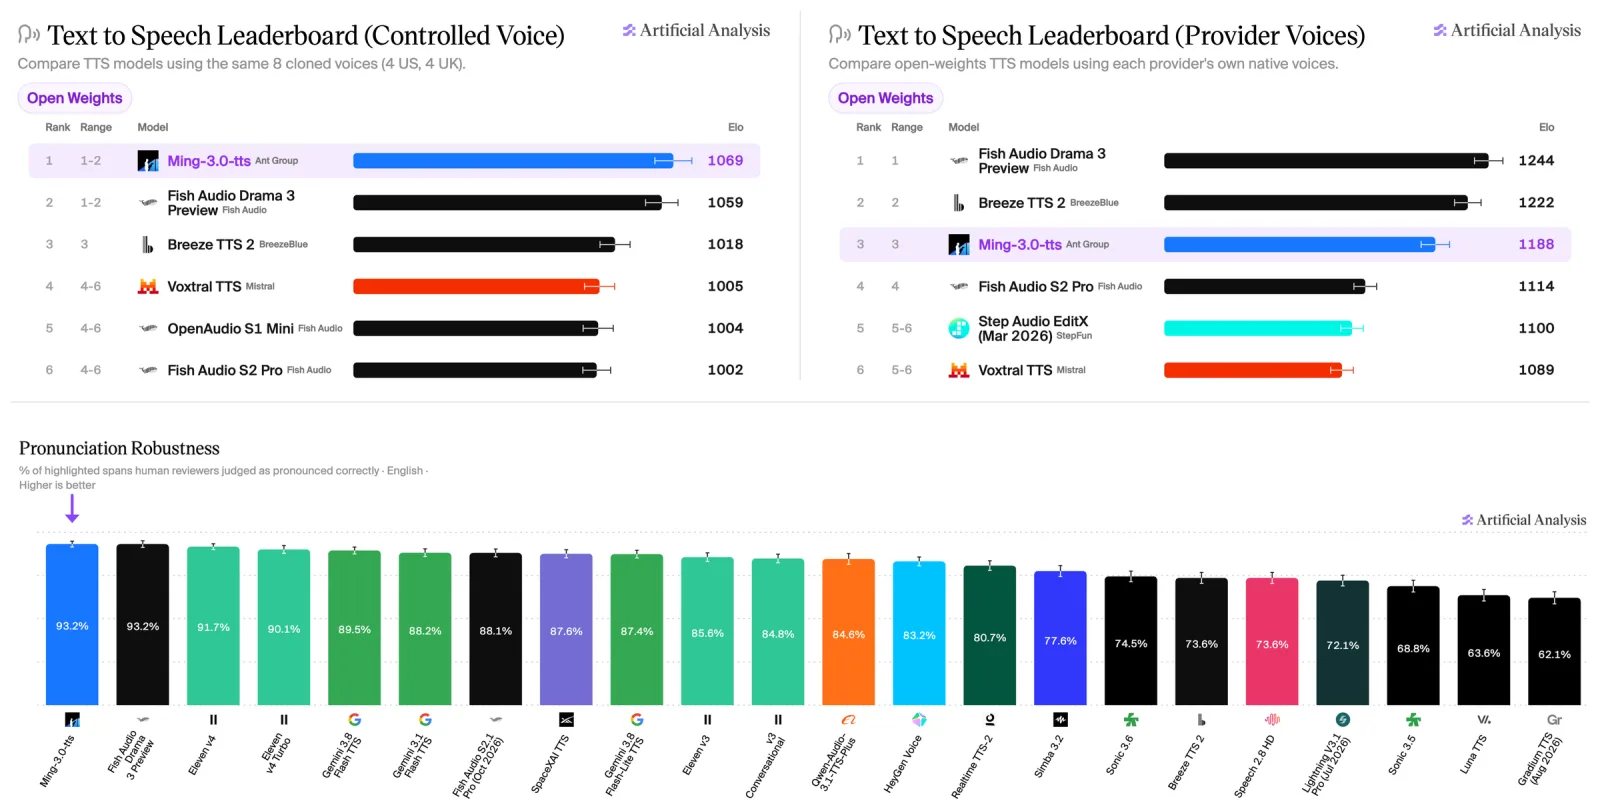
- 第三方榜单上的成绩:README 引用了 Artificial Analysis 2026 年 10 月的榜单。Controlled Voice 的 Elo 为 1069,开源模型中排第一;Pronunciation Robustness 为 93.2%,总榜第一;Provider Voice 的 Elo 为 1188,开源模型中排第三。
典型使用场景
- 做有声内容的团队:用同一段参考音色批量生成旁白或短视频配音,再用情绪控制调整语气。
- 想在自有 GPU 上部署语音的开发者:模型权重公开,可以在自己的机器上运行,不必把文本交给云端 API。
- 比较语音模型的研究者:README 附有榜单和评测图表,便于和其他模型交叉对照。
- 主要做中文内容的团队:README 引用的发音稳健性指标针对英文文本,中文场景需要用自己的真实文本测试。
快速上手
git clone https://github.com/inclusionAI/Ming-3.0-tts.git
cd Ming-3.0-tts
pip install -r requirements.txt
hf download inclusionAI/Ming-3.0-tts-0.5b --local-dir Ming-3.0-tts-0.5b
以上是 0.5B 版本的步骤,还有几点需要注意:
- 0.5B 环境在 NVIDIA H800-80GB 和 H20-96G 上测试过。flash-attn 可选,缺失时回退到 PyTorch SDPA。
- tiny 版本需要单独的环境:Python 3.10.15,torch 与 torchaudio 2.7.1(CUDA 11.8 版本),transformers 4.46.3,依赖写在
requirements-tiny.txt里。 - 在中国大陆,README 建议用 ModelScope 下载,把
hf download换成modelscope download即可。 - README 还提供了 0.5B 的 Docker 镜像构建方式,基于 torch 2.6 和 CUDA 12.4。
下载完成后,README 用 MingTTS 类按仓库路径加载模型,零样本克隆的示例通过 prompt_wav_path 指定参考音频。如果你关心的是音乐而不是语音,可以参考音频生成条目 YuE2。如果你想要的是可以直接在本机操作的语音工作台,而不是模型仓库,可以看看 VoiceStudio。
小结
Ming-3.0-tts 适合有 NVIDIA GPU、想自己部署语音合成,并且看重音色克隆和情绪控制的开发者。它不适合只想在网页上点几下、又没有 GPU 的人。如果需要多人对话,要选 tiny 版本,因为只有它支持这一功能。
音色克隆需要特别注意。README 写明,音色克隆和内置角色音色仅供研究和合法的创作用途,不得在未经同意的情况下冒充真人,不得用于欺骗或任何非法用途;作者不对滥用承担责任。克隆别人的声音之前,应先取得对方同意。
同一系列还有 inclusionAI/Ming-3.0-asr(语音识别,MIT,2026 年 10 月 19 日创建)和 inclusionAI/Ming-3.0-audio-flash(MIT,10 月 15 日创建),它们各自在独立的仓库里。本条目只讨论 TTS 仓库。
我们只核对了 README、LICENSE 和仓库元数据,没有安装运行,也没有打开 README 引用的 Artificial Analysis 原始页面。模型权重的许可证可能与仓库不同,使用前请查看 Hugging Face 上的模型页。截至 2026-10-21,仓库有 120 颗星,创建于 2026 年 10 月 19 日,未归档。