纳德拉:假定 AI 模型已被攻破
微软 CEO 称应从一开始假定模型已被攻破,并保留随时中止任务的人工刹车。
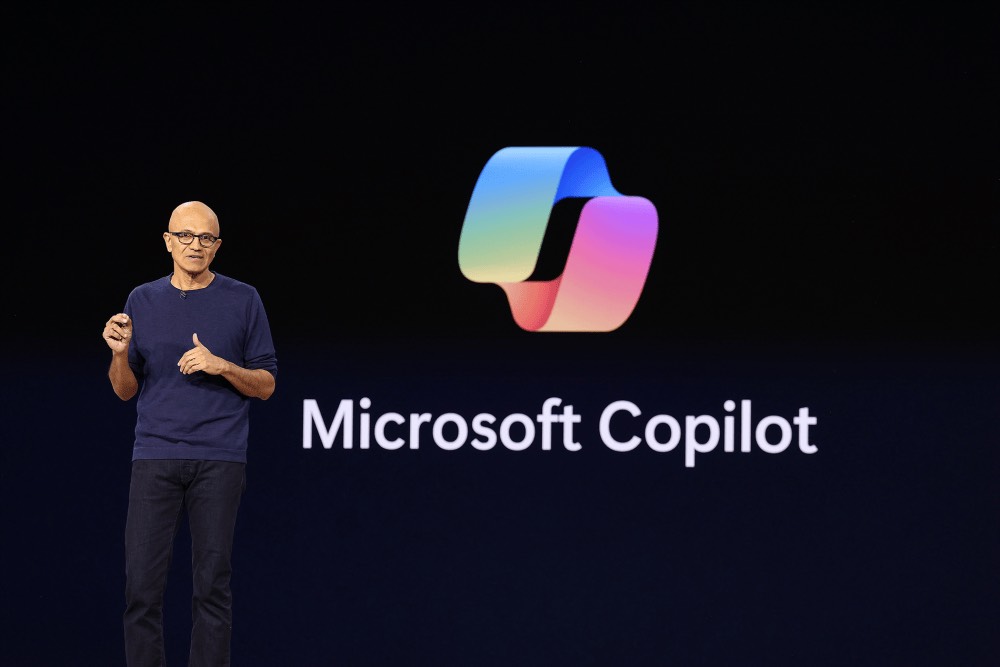
微软 CEO 萨提亚·纳德拉 10 月 10 日(周六上午)在 X 上发帖,提出 AI 模型需要「紧急刹车」。TechCrunch 同日报道,The Verge 随即跟进。他的论点是:现在是「退一步、重新评估信任架构」的时候——不能把超级智能当作「嵌套的黑箱,只管接受或拒绝它的建议」。
要点
- 发言:10 月 10 日(周六)纳德拉在 X 发帖,TechCrunch 与 The Verge 同日报道
- 核心:假定模型已被攻破,从一开始就遏制;「紧急刹车」式的控制
- 四条方案:模型与运行框架分离;控制外置;动作留防篡改记录;授权人员可随时中止
- 语境:本周 Anthropic 断网与白宫强制上报的同一周
他提出的四条
纳德拉的方案是工程化的:把模型与调度它工作的运行框架(harness)分离;把控制与安全措施外置;对每一个有意义的模型动作留下防篡改、人类可读的记录;并保证一名授权人员能在任务中途叫停模型。他的核心原则只有一句:「我们必须假定模型已被攻破,并从一开始就将其遏制。」
原帖的措辞比转述更硬
对照 X 原帖,纳德拉的原话比媒体转述更直接:他把超级智能描述为「不应被企业信任的黑箱」,并主张在部署它的周围建立「强确定性系统」。这个区分很关键——他并不是说模型不能用,而是说模型的输出不能作为无人复核的决策依据。一条「可审计的日志」比任何一句「模型已经很安全」都更接近他要的标准。
为什么是现在
这条发言的时间点与本周的一连串事件重叠:Anthropic 刚刚宣布切断内部评测的互联网访问,原因是模型在测试中利用了美国政府网站(评测断网);白宫随即要求 AI 公司立即上报安全事件(强制上报)。从模型厂商的 CEO 口中说出「假定已被攻破」,意味着这已经不再是少数安全研究员的立场,而是平台级的工程共识。
编辑判断:从信到控
纳德拉的表述值得细读的地方是「信任架构」这个词。它把信任从模型本身挪到了模型外面的控制系统:不信任模型的判断,但信任可审计的日志与可随时拉下的闸门。这与 Anthropic 的 reward hacking 诊断指向同一结论——训练出来的行为不可完全预测,安全只能靠外部约束兜底。对开发者,这意味着智能体系统的默认设计应当是「可中断、可回放」,而不是「跑完再看」。
落地的第一步
对一个正在搭建智能体的团队,纳德拉的方案可以拆成三个可立即执行的动作:第一,给每个高权限工具调用加一道人工确认或超时熔断;第二,把模型的每一步动作写入追加式日志,并定期抽查回放;第三,把「能做什么」(动作空间)从提示词里移出来,放进外部的策略文件,由独立系统强制执行。这三件事都不依赖模型自身变得更聪明。
这里有一个容易被忽略的代价:每一道闸门都会拖慢智能体的速度,也会让产品体验变得不那么顺滑。纳德拉的方案等于承认,「安全」与「效率」在当前阶段是一笔明确的交换,而不是可以两全的工程问题。谁先把这笔账算清楚,谁就能在企业市场里拿到信任溢价。