OpenAI 免费开放 CSAM 图像分类器,ChatGPT 对相关请求警告并暂停 24 小时
OpenAI 11 月 16 日免费开放 CSAM 图像分类器给通过审核组织,可识别 AI 生成内容;ChatGPT 同步上线警告屏,暂停相关账号 24 小时。
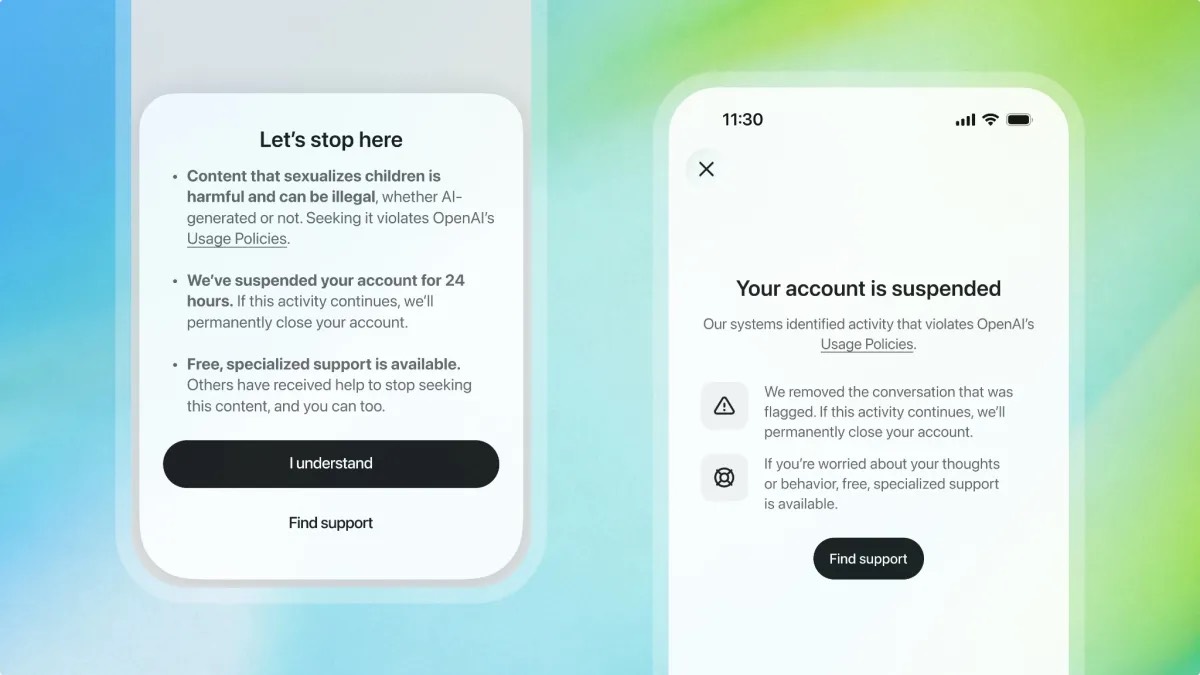
OpenAI 11 月 16 日发布一组儿童安全措施:一个能识别潜在儿童性虐待材料(CSAM)、包括 AI 生成图像的图像分类器,通过 OpenAI API 免费提供给通过审核的组织;ChatGPT 同时上线警告界面,对被判定为寻找此类内容的账号暂停访问 24 小时。分类器由 OpenAI 与 NCMEC(美国国家失踪与受虐儿童中心,CyberTipline 的运营方)共同开发与评估,官方称这是第一个带「可能由 AI 生成」专门信号、又面向广泛组织开放的 CSAM 分类器。
要点
- 申请制免费 API:模型名为
omni-moderation-csam-latest,走标准/v1/moderations接口,一次一张静态图、上限 20 MB,返回likely-csam与likely-csam/gen-ai两个 0–1 分数。免费,但要提交申请表、完成 Persona 身份核验、走完项目入驻并接受条款。 - 官方口径的效率数字:OpenAI 在自家用户上传图像的内部评估里估计,新分类器需要复核的图像少 48%,找到的虐待图像数量与现有工具大致相同;被它标记的图像含虐待内容的概率约为原来的两倍。这两个数字是 OpenAI 自述,没有第三方复核。
- 合作方各测各的:fal 在人工复核过的生产图像上确认,高置信标记里 72% 是此前未见过的 CSAM;invideo AI 的测试中每四个被标记的案例有一个导致封禁;SafetyKit 在儿童色情化的绘画与动画上检出 90%。
背景
OpenAI 既有的儿童安全防线在模型卡里被写成四层:哈希匹配、内容分类器、滥用监控和受训专家复核。它能认出「同一张图换个尺寸再传一次」,却认不出模型新生成的图——后者没有被收录进任何哈希库。这次发布的分类器补的正是这块空白:没见过的图,靠画面特征打分,而不是靠比对指纹。
外部压力同时在增大。10 月 15 日,丹麦最高法院以持有并传播 3.6 万张 AI 生成 CSAM 影像维持 18 个月监禁,并明确虚构人物不减刑(丹麦高院判决);同月,美国八州起诉 OpenAI,指 ChatGPT 对未成年人不够安全(八州起诉)。行业侧的协作也在成形:OpenAI 说已加入 Tech Coalition 的 Lantern 项目,用于跨平台共享儿童性剥削与虐待信号,并与 ROOST 一起分发新分类器的访问权限。
事实部分
这次发布是四件事捆在一起:分类器、ChatGPT 的干预、开发者指引、给执法机构的工具。四块面向的对象不同,能拿到的东西也不同。
分类器的性能数字来自三个层面,口径差别很大,混着看会失真:
| 数字 | 口径 | 来源方 |
|---|---|---|
| 48% | 需人工复核的图像减少比例,与现有防护对比 | OpenAI 内部评估 |
| 约 2 倍 | 被标记图像含虐待内容的相对概率 | OpenAI 内部评估 |
| 72% | 高置信标记经复核确认为新型 CSAM 的比例 | fal 生产图像测试 |
| 1/4 | 被标记案例最终导致封禁的比例 | invideo AI 测试 |
| 90% | 儿童色情化绘画与动画的检出率 | SafetyKit 评估 |
| 低于 1% | 合法成人内容上的误报率 | SafetyKit 自述 |
模型卡给出的数字更能看出边界。默认阈值下(likely-csam 0.996324,likely-csam/gen-ai 0.90),它在去重后的留出集上召回率为 80.2% 与 86.4%,精确率 0.991 与 1.0;同一阈值放到 ChatGPT 的抽样流量上,精确率掉到 0.298 与 0.340。OpenAI 在模型卡里解释了原因:流量里 CSAM 极少,少量误报的绝对数量就会盖过真阳性,所以「离线很准、线上七成是误报」并不矛盾。
ChatGPT 的改动属于产品层。用户提出相关请求时,界面弹出警告,说明「把儿童性化是有害的,即使所要求的材料由 AI 生成也一样」;OpenAI 会删除被标记的会话,并暂停该账号访问 ChatGPT 24 小时,同时提供专业支持渠道。24 小时是带警告性质的临时暂停,不是永久封禁;官方写明重复违规可能导致更长的限制,最终关闭账号或移交执法。这套做法是与 Protect Children、Lucy Faithfull Foundation 以及肯特大学、塔斯马尼亚大学的研究者共同设计的。
开发者侧新增了一份 CSAM 指引,由 Tech Coalition、Thorn、NCMEC 和 IWF 参与编写。内容是按阶段给的清单:在条款里明确禁止、给用户可见的举报入口、用 safety identifier 把每次上传关联到具体终端用户、上哈希匹配和新型图像分类器、向 NCMEC 注册以便上报、保留可用记录、写好响应手册、给复核人员做培训与心理支持。指引里有一句容易被忽略的边界:标准 Moderation API 的 sexual/minors 类别只覆盖文本,图像侧必须另配工具。
执法侧是插件、调查工具与数据分析能力,按项目管理员分配权限。首批工具用来梳理冗长的聊天记录与法律程序回执、找出潜在关联、生成时间线,并把结论链回原始材料;配套培训是概览加演示,另有一份现场手册。使用需要机构授权并满足项目要求。
各方说法
NCMEC 高级副总裁 John Shehan 在公告里说,这类技术的作用不止是识别材料,还在于帮助找到影像里可能存在的孩子,并给识别和保护受害者的人提供线索。
合作方的说法更直接。SafetyKit 技术人员 Samuel Wang 称这是他们测试过最好的同类工具,能抓到哈希匹配漏掉的未知 CSAM,在绘画与动画上表现稳定,对合法成人内容的误报低于 1%。这是合作方在厂商公告中的表述,样本与测试方法没有公开。
TechCrunch 在同日报道里把发布放进了另一条线索:OpenAI 正因产品对未成年人的影响面对多起诉讼,Common Sense Media 曾把它的技术称为对青少年「不可接受的风险」。报道也提到,生成式图像工具被滥用制作非自愿的性化内容的问题并不只发生在 OpenAI 一家。
最尖锐的限定来自 OpenAI 自己的模型卡:它明确写分类器分数不确认图像就是 CSAM、不判定在某个司法辖区是否违法、也不决定是否必须上报;还呼吁行业建立共享的独立基准,因为没有统一标准和代表性测试集,各家的检出率与误报率无法横向比较。
编辑判断
对做 UGC 产品的人来说,这次的实际变化是门槛:过去要接新型 CSAM 检测,得自己训模型或买商业服务;现在通过审核就能拿到一个免费信号,小团队也能把它排进复核队列。成本确实降了,不只是宣传口径。
但它只是排序器。模型卡反复强调三件事:不要提交已经确认的 CSAM,那类图像要走既有流程;上报 NCMEC 或热线前必须由受训人员复核;部署前要在自家流量上重新测阈值。按用途选阈值也有讲究——自动拦截该偏精确率,人工复核队列可以偏召回。
三个已知缺口值得先写进方案:分类器没有在视频帧上测过;婴幼儿、施虐等更细的子类信号仍只在内部,API 不单独返回;在线精确率约三成意味着复核人员看到的标记里大部分是误报,人力预算要按这个比例算。另外,模型卡里的在线数据全部来自 ChatGPT 流量,换到图片社区或社交产品未必复现。
还没答案的问题:24 小时暂停是否真的降低了重复行为,官方没有公布回流数据;Lantern 的信号共享能覆盖多少平台;独立基准什么时候出现。在这些数据出来之前,把它当成一层有用的补充信号,比当成解决方案更稳妥。
怎么试
先提交分类器申请表并完成 Persona 核验,拿到通过审核组织的 API key 之后,调用方式和普通 moderation 请求一样,只是换模型名:
curl https://api.openai.com/v1/moderations \
  -X POST \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "omni-moderation-csam-latest",
    "input": [
      {
        "type": "image_url",
        "image_url": { "url": "https://cdn.openai.com/API/docs/images/soap.png" }
      }
    ]
  }'
返回里看 results[0].flagged 与 category_scores。官方提醒分数不是校准过的概率,0.5 也不是通用阈值,具体切在哪里要按自己的复核流程定。图片不会被保留,也不用于训练。
接下来
未来几个月值得盯三件事:一是独立基准能不能落地,现在所有性能数字都来自 OpenAI 或它的合作方;二是执法工具与培训的实际部署范围,目前只有首批工具和一份手册;三是监管怎么处理「AI 生成但不对应真实儿童」的材料——丹麦已经给出刑事判例,其他司法辖区还没跟上。