权重空间编程改写 Qwen3.5-0.8B 权重,数学分数随循环修复上升
MIT CSAIL 报告:GPT-6 Astra 修改 Qwen3.5-0.8B 的 0.016% 权重,MATH-500 从 7.9% 升至 48.1%。
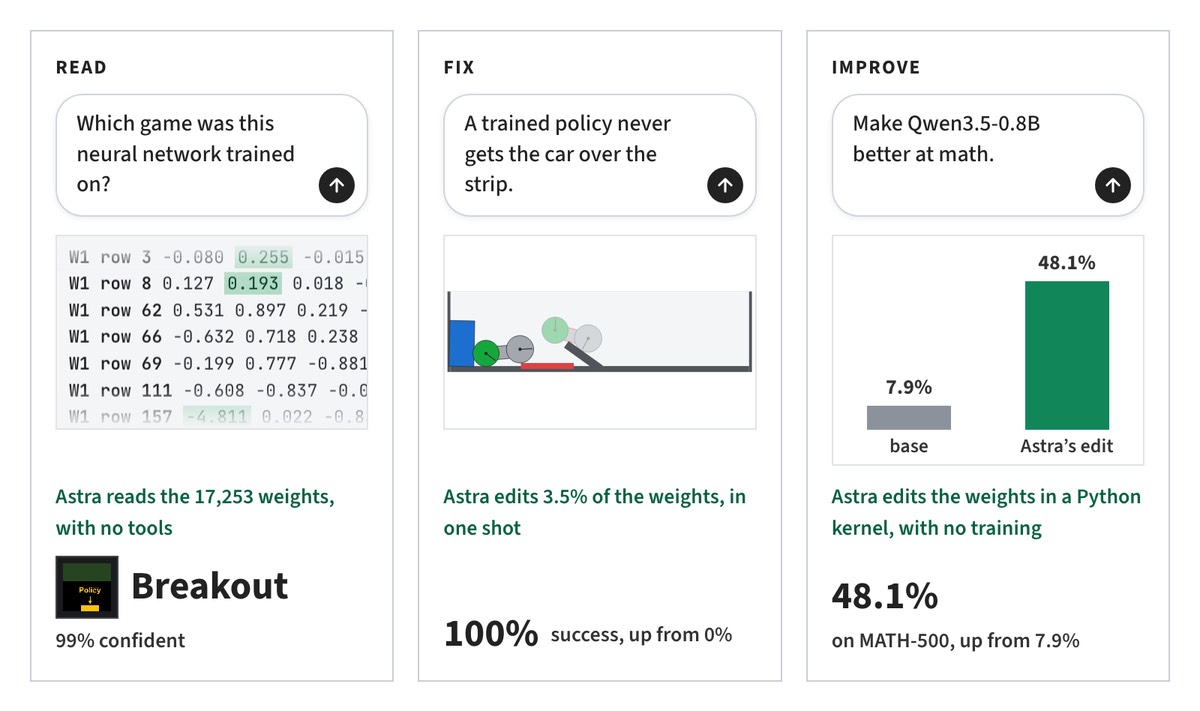
权重空间编程(weight-space programming)把模型参数当作可直接读写的对象,而不是只能由梯度训练更新的内部数据。MIT CSAIL 研究团队于 2026 年 11 月 2 日发布八组实验,称 GPT-6 Astra 能读取小型网络的权重、从头写出网络,并直接编辑 Qwen3.5-0.8B;在后一个实验中,研究者报告 MATH-500 得分由 7.9% 升至 48.1%。这组结果值得关注,但得分跃升主要对应修复重复推理循环,不能直接解释为模型学会了新的数学能力。
要点
- 实验 8 修改 Qwen3.5-0.8B 中 131,072 个参数,约占 0.8B 权重的 0.016%;作者报告 MATH-500、GSM8K 与 IFEval 均有上升。
- 作者给模型 Python 权重操作环境、GSM8K 与 MATH 的练习题,以及最多 50 次前向评测;没有进行梯度下降或训练循环。
- 独立复现验证了公开权重差分和接近的 MATH-500 分数,但无法复现闭源 GPT-6 Astra 如何发现该编辑;结果更像修复特定循环故障,而非普遍提升数学能力。
权重空间编程做了什么
研究团队把八项实验汇总在一篇研究博客中,而非同行评审论文。实验覆盖读取网络权重、修复控制策略、从零写网络,以及编辑一个小型语言模型。最容易核对的结果来自 Qwen3.5-0.8B:模型会重复生成推理内容,常在回答前耗尽 32,768 个 token。作者称,Astra 检查权重后,把问题定位到第 15 与第 19 层 MLP 写入的一条方向,并从两层 down_proj 的 64 个输出列中减去它。
这个过程不是“模型自行改写自己的大脑”。实验给 Astra 一个可操作权重的 Python 环境、GSM8K 的 7,469 道与 MATH 的 7,275 道练习题,并允许 10、25 或 50 次前向评测;没有用梯度下降,也没有训练循环。作者报告,50 次评测设置下改动 131,072 个参数(0.016%),且变化集中在两个张量。封面图将博客中的“读取、修复、提升”三个实验画在一起;其中 Qwen 对比是右侧那组结果。
报告中的分数
作者在 2026 年 11 月 2 日的博客中使用开启思考、最多 32,768 个生成 token 的协议。每个基准的采样次数不同,MATH-500 为每题四次;摘要分数也不能脱离循环故障的占比解读。
| Qwen3.5-0.8B | 原始模型 | 编辑 50 次前向评测后 |
|---|---|---|
| MATH-500 | 7.9% | 48.1% |
| GSM8K | 13.8% | 67.1% |
| IFEval | 21.0% | 62.3% |
| MATH-500 答案触及 token 上限 | 93.0% | 33.1% |
最能解释分数变化的是最后一行:原模型的大量答案卡在重复循环,编辑后更多答案能完整输出。研究团队自己的对照也限制了结论:对很少出现循环的 Gemma 3 270M,MATH-500 只从 6.8% 变到最高 7.7%,作者认为没有建立起可靠提升。因此,“修复循环后分数增加”比“少量改权重就能普遍提高数学推理”更符合现有证据。
独立复现核对了什么
Hugging Face 上的 pngwn/weight-space-repro 逐张量校验公开差分,并报告在相同思考开启协议下,50 次编辑的 MATH-500 结果曾被独立重跑到 50.2% 与 51.0%。它也指出 Astra 是闭源模型,复现者无法验证 Astra 是否能独立发现这个编辑;能复核的是公开差分及应用后的模型行为,而不是发现能力本身。另一篇 DEV Community 审计按 500 道题、每题四个采样重新评测,得到 51.0%,并记录仍有 31.6% 的答案触及 token 上限,接近原报告的 33.1%。
纽约大学上海校区 RITS 的独立综述补充了实验边界:它汇总了使用 Qwen 3.8 27B 和 Kimi K3.1 Pro 重做部分小网络识别任务的报告,也记录 Claude Opus 5.5 对 Gemma 4 进行局部行为编辑的另一个案例。这些是不同模型、任务和评测设置,不能当作 Qwen 数学分数的重复验证。RITS 同时指出,真实语言模型实验使用了 Python;Qwen 实验还使用练习题与前向评测,因此“直接操作权重”不等于完全无工具地读懂任意模型。
编辑判断
权重空间编程目前最有把握的工程信号,是对公开权重做小而可审计的补丁:差分可逐张量重建,编辑后的 Qwen 检查分数能在独立环境中接近复现。它与常见微调的目标不同;这里没有重新训练整套参数,而是试图定位并修改特定行为所依赖的方向。这对研究者检查局部故障、构造可逆补丁或分析模型行为有参考价值。
限制也很具体。显著的 MATH-500 提升主要来自一个有重复循环的 Qwen 配置;同一研究的 Gemma 对照没有得到可靠数学增益。练习数据、Python 操作和多轮前向评测都是方法的一部分。独立复现公开差分并不能证明另一个模型会自行找到同样的补丁,也不意味着任何模型都能通过少量权重编辑获得新技能。相关的模型评测问题,可与我们此前的 RoboColiseum 多智能体基准 对照;GPT-6 Astra 的产品背景则见 GPT-6.1 Astra 发布计划调整。
怎么试
研究日志 RikiyaT/lm_understand-logs 包含作者发布的提示、响应、代码与评测记录;Hugging Face 模型卡提供编辑后的 Qwen3.5-0.8B 权重。独立评测者也公开了重新构建差分和评测的过程。读者若要复核,先把编辑模型与基座放在相同推理设置、思考模式、采样参数和评分器下比较,并记录触及 token 上限的比例;只比较 7.9% 与 48.1% 两个数字,会把循环修复误读成能力凭空出现。