RoboColiseum 用 Agent2Act 横评四款前沿模型:Opus 5.5 以 76.28 领先,通用操作仍输专用策略
RoboColiseum 10 月 20 日报告:四模型同走 Agent2Act,Opus 5.5 以 76.28 居首,通用操作仍输专用策略模型。
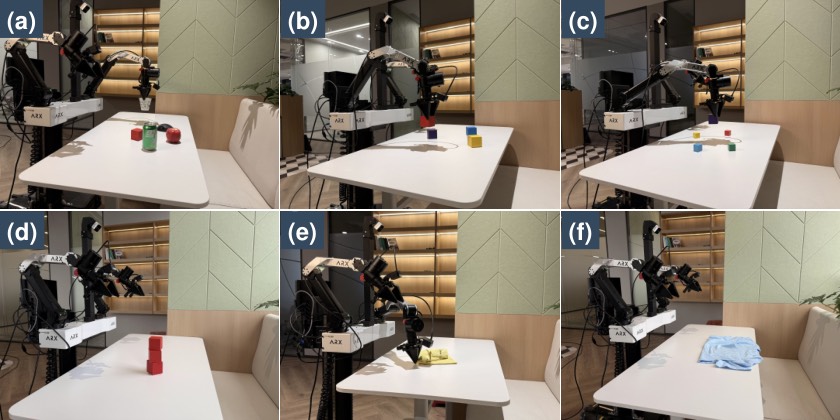
RoboColiseum 是一个面向具身模型的仿真评测平台,同时收录 vision-language-action 模型、world/action 模型和 agent 系统,按指令跟随、空间理解、通用操作、鲁棒性四条赛道打分。2026 年 10 月 20 日,Da Huang、Jichao Wang 等 11 位作者把平台上的跨模型评测写成技术报告挂到 arXiv 的 cs.RO 分类。报告写了一套叫 Agent2Act 的控制框架,把 GPT-6 Astra、GPT-6.1 Sol、Claude Opus 5.5、Gemini 4 Argon 接到同一批样本、同一个随机种子上各跑一次;Opus 以 76.28 分居四者之首,Astra 75.99、Sol 70.91、Argon 66.86。
要点
- 四款模型这次有了同一套 harness 下的可比分数:综合分跨度 66.86–76.28,指令跟随 85.89–99.35,空间理解 69.38–82.50,通用操作只有 38.79–46.70。
- 总榜上专用策略模型仍占前二:Paimon 0.7754、HiDream-O1-Embodied 0.7692,Opus 0.7628 排第三;但 Table III 脚注写明外部条目「retain their respective training and execution settings」,它们没过 Agent2Act。
- 五类扰动里图像质量打击最大,Sol 的指令跟随分从 0.96 掉到 0.18(Δ0.77),Opus 从 0.97 掉到 0.76(Δ0.20);基线是各模型的指令跟随分,不是综合分。
背景
在 RoboColiseum 之前,前沿模型当机器人策略的评测大多是单模型、各搭各的架子。报告引用的三份工作都在 9 月:RoboDojo 跑全部 42 个任务,Astra 与 GPT-5.5 按官方每任务 50 回合、DeepSeek-Flash 按每任务 10 回合;Astra 在 2100 次试验里平均成功率 22.48%、得分 28.97,后处理相同的情况下 GPT-5.5 只有 0.88%,DeepSeek-Flash 1.92%。Galbot 拆成六个域,与 π0.5 混合控制在 RoboDojo 子集上 48%;RoboICL 在 30 个任务上把 Astra 的零样本成绩提高 20–27 个进度分,总分 50.64。三组数字各自来自不同的任务集与 harness,横向拼不到一张表上。
本站 10 月 18 日写过 Manifold 的 R²SI 登顶 RoboDojo 智能体栏,那是「同一个 Astra 外面套不同的壳能提多少分」;这次反过来,壳固定成 Agent2Act,看「换模型差多少」。作为参照,Claude Opus 5.5 在 9 月 23 日发布时,Anthropic 把它定位成长时间编程 Agent 与知识工作的主力模型,讲的是通用能力与 API 价格,没有机器人控制这一项。
事实部分
报告的评测口径写得比较死:每个 case 每个模型跑一次,同赛道内四款模型用相同样本、同一个固定随机种子、同一套 Agent2Act;单任务分是该任务各 substep 分的均值,赛道分是所属任务分的均值,任务等权,不按 case 数量加权。四个赛道的任务全部用基准原始指令,不额外加任务提示;通用机器人指令与控制接口描述四款模型完全一致。
Table I 是四款模型的百分比分数(按综合分排序):
| 模型 | 综合 | 指令跟随 | 空间理解 | 通用操作 | 鲁棒性 |
|---|---|---|---|---|---|
| Claude Opus 5.5 | 76.28 | 96.60 | 82.50 | 46.70 | 79.30 |
| GPT-6 Astra | 75.99 | 99.35 | 78.33 | 45.86 | 80.42 |
| GPT-6.1 Sol | 70.91 | 95.50 | 77.71 | 40.01 | 70.40 |
| Gemini 4 Argon | 66.86 | 85.89 | 69.38 | 38.79 | 73.36 |
Table III 把四款模型放进 RoboColiseum 官方总榜,跟策略模型同表,0–1 尺度:
| 名次 | 模型 | 综合 | 指令跟随 | 空间理解 | 通用操作 | 鲁棒性 |
|---|---|---|---|---|---|---|
| 1 | Paimon | 0.7754 | 0.8961 | 0.6791 | 0.6613 | 0.8653 |
| 2 | HiDream-O1-Embodied | 0.7692 | 0.8913 | 0.7437 | 0.6442 | 0.7978 |
| 3 | Claude Opus 5.5 | 0.7628 | 0.9660 | 0.8250 | 0.4670 | 0.7930 |
| 4 | GPT-6 Astra | 0.7599 | 0.9935 | 0.7833 | 0.4586 | 0.8042 |
| 5 | GPT-6.1 Sol | 0.7091 | 0.9550 | 0.7771 | 0.4001 | 0.7040 |
| 6 | DM0.5 | 0.7076 | 0.8444 | 0.6146 | 0.6370 | 0.7344 |
| 7 | Gemini 4 Argon | 0.6686 | 0.8589 | 0.6938 | 0.3879 | 0.7336 |
| 8 | GigaBrain-0.7 | 0.6504 | 0.8166 | 0.4729 | 0.6320 | 0.6800 |
任务数按 §III-C 的三张表逐项点:Table IV 指令跟随 10 项、Table V 空间理解 8 项、Table VI 通用操作 10 项,合计 28 项,鲁棒性另有 5 类扰动(Table VII)。中文二手报道里流传的「78 个高保真任务」在论文正文和表格里检索不到,全文也没有把 78 当整数单独用过。引用任务规模时,28 项任务加 5 类扰动是唯一能从表里数出来的口径。
成本只有相对结论,没有绝对数字。报告说 Opus 在四款里总分最高、总 token 消耗最少;Astra 与 Sol 总用量接近,Sol 略多;Argon 消耗最多。按参考 API 价格折算,Sol 用明显更低的估计推理成本拿到接近 Astra 的分数,Argon 的估计成本略高于 Sol。
能力画像
四条赛道的分数落差本身是这份报告最稳的结论。四款模型的指令跟随都在 85.89 以上,空间理解都在 69 以上,通用操作全部落到 46.70 以下,报告自己的说法是「强零样本指令跟随尚未转化为可靠的复杂物理操作」。
分任务看,短板集中在需要连续接触调整的活。通用操作里 clean desktop 四款只有 0.05–0.20,continuous sorting 0.00–0.07,pour workpiece 0.10–0.24;pot holding 上 Opus 0.60、Astra 0.41、Sol 0.23、Argon 0.00。空间理解里 bowl stacking 四款全是 0.00,报告给的原因是反复抓碗沿失败把步数预算耗尽。指令跟随的差距主要来自 straighten object 这一项:需要拿起来再转腕把物体摆正,Argon 0.60,其余三款 0.83–0.98。
案例部分只做了 Astra。它能协调底盘、躯干和机械臂完成扔垃圾、从柜子取杯、开门、推椅子;在 ARX、AgileX、G1、G2 四种本体上都能完成棋子收纳;家居场景里能走到厨房拿一罐雪碧放到餐桌。反过来,灵巧手叠碗在补充手指与手掌几何信息后仍然失败,手机充电和插网线能抓起来但对不准接口,硬币放置第一次没进槽、后面再也没抓起来。真机部分接的是 ARX Lift2,三台 RealSense D405 提供 RGB 与深度,结果由人眼判定:有深度后毛巾和衣物对折能成,多阶段叠衣服仍然失败。
鲁棒性
鲁棒性这一栏最容易读错。Table VII 的比较基准是每款模型自己的指令跟随分(Astra 0.99、Sol 0.96、Opus 0.97、Argon 0.86),扰动集从指令跟随测试集派生,只改一个维度,所以 0.18 不等于「综合分掉到 18」。
图像质量扰动包含头部与两个腕部相机的随机丢帧、镜头遮挡和多种噪声,是五类里打击最大的一类:Sol 从 0.96 掉到 0.18,Δ0.77;Astra 从 0.99 掉到 0.68,Δ0.32;Argon 0.86 到 0.60,Δ0.26;Opus 0.97 到 0.76,Δ0.20,同时是这一项的最高分。其余四类里,背景与光照让四款各掉 0.08–0.16,相机位置 0.10–0.20,指令改写 0.09–0.18,初始位姿 0.06–0.20。Opus 在五个维度上的跌幅最平;Argon 的指令跟随基线最低,但在扰动下与 Sol 相当,鲁棒性总分 0.7336 高过 Sol 的 0.7040。
框架消融
报告用 Astra 单模型做了七组 harness 消融,前六组跑 10 项指令跟随任务,历史那一组跑 4 种积木入盒布局。完整系统 9/10 成功,平均 16.7 次规划决策、32.50 分钟、118.8 个执行步。
拿掉执行偏差反馈,成功降到 8/10,决策增至 35.6 次,耗时 58.26 分钟(+79.3%)。拿掉抓手几何与接触说明,成功降到 7/10,决策 51.6 次(+209.0%),耗时 68.26 分钟(+110.0%),是六组里最差的一档。放宽 IK 校验反而把成功率推到 10/10,代价是决策 46.9 次(+180.8%)。改成直接关节控制,步数涨到 254.3(+114.1%),耗时反而降到 19.62 分钟(−39.6%)。拿掉历史记录,四种布局的成功率从 100% 掉到 50%,决策从 27.5 次涨到 66.5 次,耗时从 64.65 分钟涨到 131.81 分钟(+103.9%),两次失败都是已经抓起积木、在放置阶段重复同一动作。
这组数字说明「模型分数」里有一部分是壳给的。同一份报告在结论里也承认,推理成本与响应延迟仍是实际部署的主要障碍。
口径问题
口径问题集中在三处。第一处是 Argon 的档位。报告写明 Astra、Sol、Opus 用 high 推理档,Argon 只能用 medium,原因是这次评测所用的 API 通道在 high 档下太慢,撑不住批量评测;原文紧接着写「Comparisons involving Argon therefore reflect differences in both the model and its reasoning setting」。所以 66.86 与 76.28 的差距里混着模型与推理设置两个变量,不能当成纯模型差距读。
第二处是外部策略模型的口径。Table III 里 Paimon、HiDream-O1-Embodied、DM0.5、GigaBrain-0.7 来自官方总榜,脚注说外部条目「retain their respective training and execution settings」,浅蓝行只标出过 Agent2Act 的四款多模态模型。通用操作上 0.3879–0.4670 对 0.6320–0.6613 的落差是表里的原数,但一边过了 Agent2Act、一边保留了各自的设置,这个对比是「榜单同表」而非「同考卷」;外部条目具体用了什么观测与动作接口,报告没有交代。
第三处是利益相关。报告测的是 RoboColiseum 自家榜单,结论一节写这些发现将用来改进 RoboColiseum 的评测能力。四款模型的成绩由报告方自己跑出,论文没有提到任何独立复现。
中文二手报道另有两处需要打折扣。新智元 10 月 20 日的稿子(华尔街见闻转载)把「78 个高保真任务」和「仿真评测与实机部署的相关性高达 89.5%、差异小于 10%」当成平台卖点,这两个数字在论文全文与表格里都检索不到,只能算平台宣传口径。同稿把四款模型的图像质量跌幅 0.20 / 0.26 / 0.32 / 0.77 抄对了,但没有交代基线是指令跟随分。
编辑判断
对做具身智能的团队,这张表最有用的是分赛道看而不是看总分。要选一个模型当高层规划器,Opus 与 Astra 的指令跟随、空间理解都够用,0.29 分的综合分差距在单次评测里说明不了谁更好;要选一个直接输出动作的策略,四款通用模型的通用操作都在 0.47 以下,专用策略模型在同一张表上是 0.6320–0.6613,最弱的策略模型(GigaBrain-0.7 0.6320)比最好的通用模型(Opus 0.4670)还高 0.165,而四款通用模型在这一项上的全部跨度只有 0.0791。现在把前沿 LLM 放进机器人控制环,合理的用法是当决策层与纠错层,执行交给学出来的策略。
诚实的一面有三条。四款模型各跑一次、没有重复实验,报告没给方差,0.29 分(0–1 尺度上 0.0029)的 Opus–Astra 差距谈不上显著。Argon 降档、外部策略不过同一 harness、报告方评自家榜单,三处都削弱了「统一横评」这个卖点。消融只做了 Astra 一款,换模型后 harness 各组件的收益未必一样。
还缺的东西也清楚:论文没有给绝对 token 数与成本,只有相对排序;任务规模只能按 Table IV–VI 数出 28 项,外界流传的 78 项无从核对;真机只做了 Astra 一款、结果靠人眼判定,没有真机与仿真的相关性数字。
接下来
RoboColiseum 维护着一个官方总榜,报告结尾说会继续接入不同的多模态模型与 agent 系统,并把评测能力与模型能力放在同一个迭代循环里改进。可核对的下一步是榜单本身:新模型提交后,Table III 的名次会变,而 Agent2Act 的 harness 消融结论要等第二款模型复跑才能验证是不是通用规律。想自己判断这套评测值不值,可以拿本站记过的 OpenAI 机器人招聘当参照——那边在补执行器与制造的人,这边在量模型离执行还有多远。