行元智能发布跨本体数据引擎 Chorus:1 小时人类视频扩出 16 种本体的训练数据
行元智能 10 月 27 日发布跨本体数据引擎 Chorus:1 小时人类视频产约 13.6 小时、16 种本体轨迹,自称 40 倍扩容,均为官方自述。
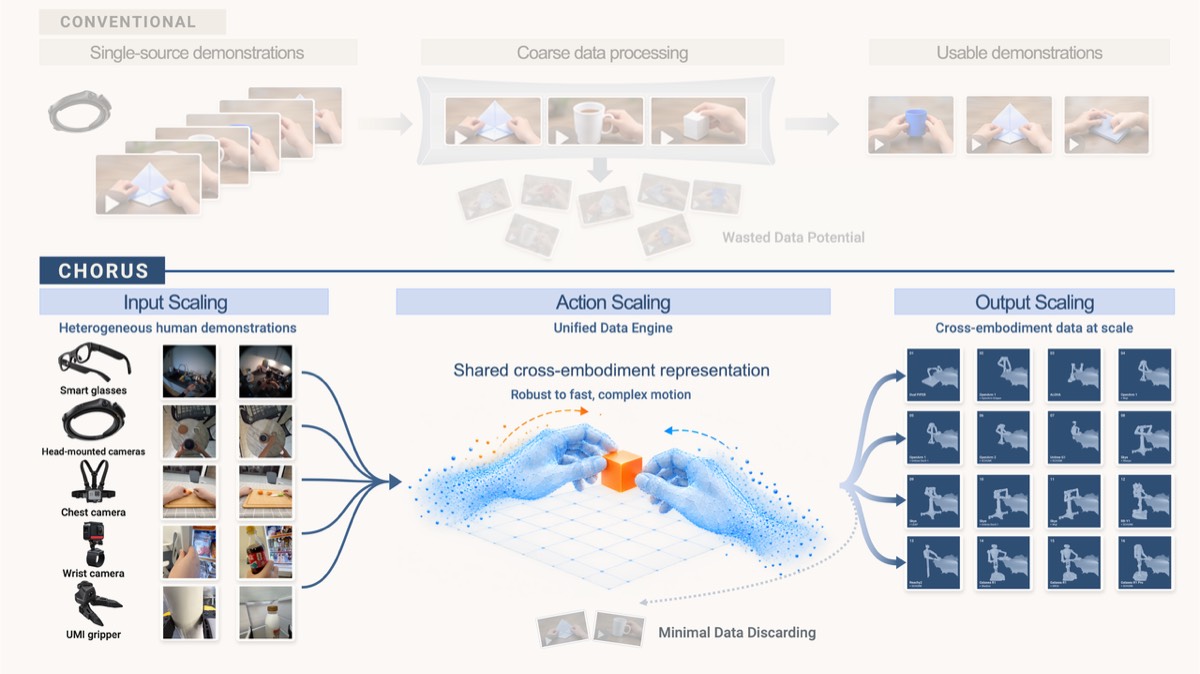
机器人基础模型公司行元智能(Action Intelligence)10 月 27 日在其官网研究页发布跨本体数据引擎 Chorus(中文名「众行」):把智能眼镜、胸戴相机、UMI 设备等采集的人类第一视角操作视频,清洗、重建并转写成适配不同机器人本体的训练轨迹。官网研究页(版本号 v=20261027-5)给出的扩容公式是「1 筛选后源小时 × 16 本体 × 85% ≈ 13.6 轨迹小时」——先把人的一段操作视频跨到 16 种机器人本体,再叠加约 3 倍指令增广,钛媒体与雷科技的报道据此得出约 40 倍有效训练数据扩容的口径。这套数据引擎面向的买家是做机器人预训练的团队;要说明的是,页面上的转化率、成本等数字全部为官方自述,目前没有任何第三方评测。
要点
- Chorus 官方扩容公式为「1 筛选后源小时 × 16 本体 × 85% ≈ 13.6 轨迹小时」,叠加约 3 倍指令增广后合计约 40 倍有效训练数据扩容;处理成本按官方口径折算约 14.7 元/轨迹小时(雷科技写作四舍五入后的 15 元)。
- 标注靠自研的 4B 原子动作识别模型,帧级处理速度 10 FPS,官方称标注成本约为 Gemini 3.8 Flash 基线的 1/20——这是页面里唯一的对比实验,且对象是成本而非效果。
- 公司由 00 后研究者杨世琦创立,钛媒体明确时间为其今年(2026 年)6 月;战略上不做硬件本体,走「数据 + 模型」路线,全部关键数字均为官方自述、无第三方评测。
背景
Chorus 不是凭空出现的。行元智能官网把产品线写成三章:第一章 Continuo(随行)「For Human」,是把人类经验持续收进模型的体验层,状态为已发布(雷科技称其此前已发布,可部署于可穿戴设备);第二章 Chorus(众行)「From Human」,也就是这次发布的数据引擎,页面同样标为已发布,另给出一个演示站 chorus.a-i.co;第三章 Duet(同行)「With Human」规划人类指导、纠错与交互反馈的训练回流,官网标注为「Classified / UNRELEASED」,雷科技称其计划年内推出。公司名「行元」的来历,钛媒体解释为:LLM 的基础单元是词元(Token),而机器人要解决「行动」(Action)维度,杨世琦想定义机器人的「Action Token」。
这条路线放在当下的行业里读更有意思。OpenAI 的招聘页上挂着 19 个机器人职位,从电机设计排到制造采购(见我们此前的报道),模型公司亲自下场造硬件;杨立昆阵营则押注世界模型,H-JEPA 论文用分层规划做物理世界的预测(见我们此前的报道)。行元选了第三条路:不碰本体、不绑硬件,只做「物理世界的通用具身大脑」所需的数据与模型。钛媒体引述的理由很直接——中国已有成熟庞大的机器人硬件供应链,自建本体投入巨额资本,还会拖慢模型迭代。
事实部分
Chorus 的流水线(官网研究页口径):先把多源人类操作视频做清洗与三维重建,再经原子动作识别、语义标注、轨迹优化,最后跨本体映射到目标机器人。页面给出的可核对数字如下,全部为官方口径:
| 项目 | 数字 | 出处 |
|---|---|---|
| 本体适配 | 16 种机器人本体 | 官网研究页 |
| 转化率 | 平均可用数据转化率 85% | 官网研究页 |
| 扩容公式 | 1 源小时 × 16 本体 × 85% ≈ 13.6 轨迹小时 | 官网研究页 |
| 指令增广 | 约 3 倍 | 官网研究页 |
| 处理成本 | 约 200 元/输入小时,折合约 14.7 元/轨迹小时 | 官网研究页 |
| 标注模型 | 自研 4B,帧级 10 FPS | 官网研究页 |
| 标注成本 | 约 Gemini 3.8 Flash 基线的 1/20 | 官网研究页 |
标注环节用短时间窗加时间 token 压缩,在原子动作、子任务、完整任务三层做标注,再叠加约 3 倍指令增广;数据评分维度包括语义完整性、三维重建质量、运动一致性、视觉质量,外加有效时长与动作数。页面还定义了一个「action surprise」指标:用语言模型在上下文里预测下一个动作,再量预测与实际动作的偏差,用来捕捉意外选择、策略变化和纠偏动作,优先安排人工复核。输入端支持智能眼镜、胸戴/腕部相机、颈挂与头戴系统及 UMI 式设备,覆盖单目、双目、四目、六目配置。雷科技补充了一个等效口径:叠加指令增广后,单位训练样本的等效成本约 5 元/小时。创始人背景出自雷科技:杨世琦毕业于 UCSD,师从 Meta Superintelligence Labs 研究总监王小龙;技术联创司晨阳、杨靖康入选 2026 年全球前 2% 顶尖科学家榜单。钛媒体补充:杨世琦 2025 年 7 月回国,之后花数月调研国内具身智能,今年 6 月创立行元智能。
各方说法
目前对 Chorus 的公开报道只有中文科技媒体,且信息高度依赖官方口径。钛媒体的角度是商业路线:它把「训练数据的规模化供给与复用」称为行业的命门,引述杨世琦「坚决不做硬件本体,也不绑定单一硬件」的表态;部署上,物流场景初期「一拖一」——一名工人监督一台机器人,机器人卡住时不懂技术的工人两三秒内接管、纠偏后交还,反馈回流训练,随成功率提升向「一拖三」演进。雷科技的角度是团队与成本:师承关系、两位技术联创的科学家榜单入选,加上 15 元/轨迹小时、5 元/小时的等效样本成本。机器人卡住时由现场人员短时接管纠偏、纠偏数据回流训练,这个闭环设计与 Duet 一章「GUIDANCE · CORRECTION · COLLABORATION」的规划吻合,但 Duet 本身未发布,回流是规划而非现有功能。
需要指出的是口径问题。钛媒体的关键数字(85%、13.6 小时、16 种本体)与官网一致;雷科技转写了 85%、16 种本体与成本口径(15 元、5 元/小时、40 倍)——两家均转写自官方材料,不是独立复测;机器之心同日仅有标题可读,正文被反爬挡住,本站无法核对其内容。页面唯一自带的对标实验是标注成本对 Gemini 3.8 Flash 的 1/20,没有任何任务成功率或策略性能的基准。检索层面,本站未能找到第四家独立媒体或批评性报道,海外社区(HN/Reddit)暂未见到讨论。
编辑判断
对做机器人预训练或数据采集的团队,Chorus 值得放进对比清单:如果 85% 转化率和 14.7 元/轨迹小时的口径成立,一份人类演示摊到多种本体的成本结构,会好过「一份数据对应一种机器人」的采集方案——演示站 chorus.a-i.co 公开,验证的门槛不高。对关注具身智能路线的人,它是「数据层」细分的一个新样本:OpenAI 在造本体,LeCun 阵营在做世界模型,行元断言行业命门在数据供给,三家赌的是同一个市场的不同瓶颈。
诚实的 catch 是所有关键数字都出自官方页面:85% 转化率没有给出逐本体的明细,13.6 小时是公式推演而非某批数据的实测,40 倍扩容也是两层自述口径的乘积。官方研究页只字未提公司成立时间与融资,钛媒体「今年 6 月创立」的说法也没有第二家独立信源佐证。什么时候出现第三方在自有数据上的复测,什么时候这组数字才从「宣称」变成「证据」——在那之前,把它们当一枚待验证的报价单看待,比当成基准更稳妥。
接下来
三件事值得盯。一是 Duet(同行)落地:年内推出的话,2-3 秒人工接管的数据回流会从规划变成功能,那是行元「系统规模化」叙事的关键一块。二是第三方复测:有没有客户或研究组在自有数据上跑 Chorus,给出公开的成功率。三是机器人基础模型本身:官网把它标为「UNRELEASED / TO BE REVEALED」,行元明确不做本体,这个模型就是它的终局产品——发布时间与形态,会检验「数据引擎先行」这条路线是否走得通。