Anthropic 披露动态工作流架构:Claude 写编排程序管理最多 1000 个子智能体
Anthropic 10 月 12 日披露 Claude 动态工作流架构:模型自己写编排程序交服务器执行,单次运行累计最多 1000 个子智能体,预算触顶熔断。
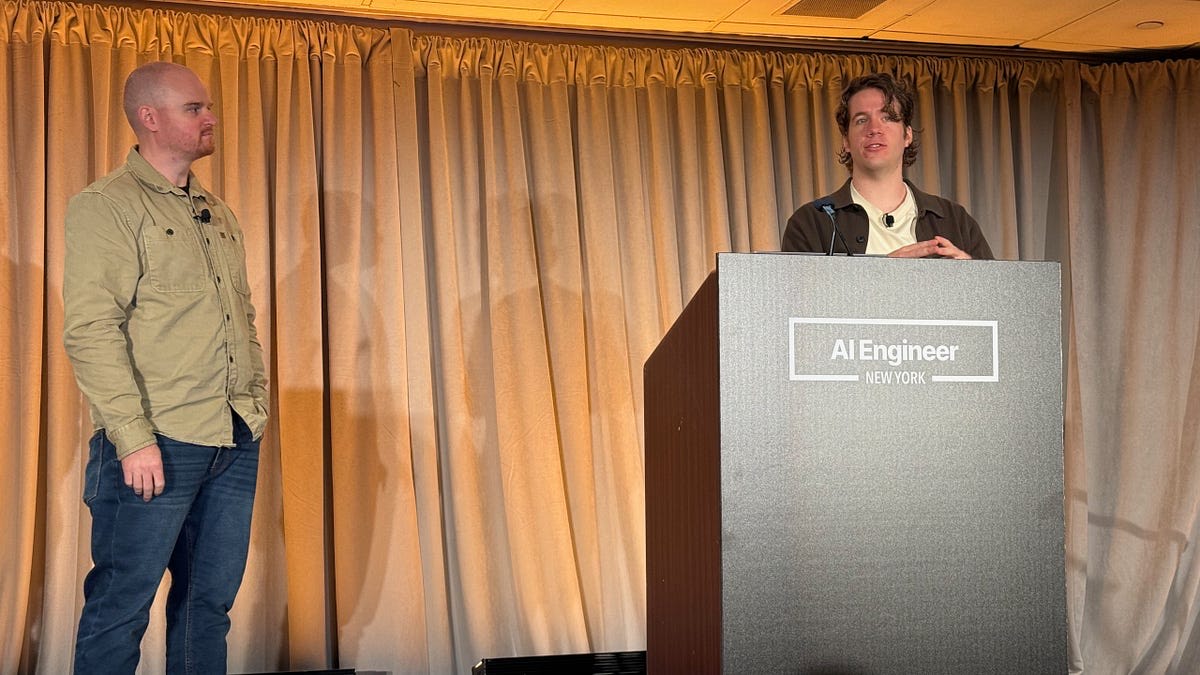
Anthropic 的动态工作流(Dynamic Workflows)是 Claude Managed Agents 平台的多智能体编排能力:主智能体不再逐步给子智能体派活、逐个收结果,而是自己写一段带执行逻辑的编排程序,交给 Anthropic 的服务器在后台跑完。10 月 12 日,Anthropic 工程师 CJ Avilla 与 Harrison Stall 在 AI Engineer NYC 2026 开幕日上午的工作坊上公开了这套架构的运作细节,科技媒体 Latent Space 当天报道了演示与问答。官方文档写明的硬边界是:单次运行生命周期内累计最多启动 1000 个子智能体,同时并发 64 个线程,默认最长运行 24 小时。
要点
- 编排方式变了:此前是主智能体推理一步、调度一步;现在 Claude 写出程序、服务器照着执行,模型不再逐步参与运行时调度,主线程腾出来与用户交流、盯多个运行。
- 官方文档的口径:1000 个子智能体是单次运行生命周期内的累计数,不是同时并发——并发上限 64,运行默认 24 小时寿命,每个会话默认同时开 10 个运行。
- 会话预算只能在创建时设定,事后不能补加;预算触顶后新请求被拒,但已在途的模型请求会跑完,实际花费可能按每个在途线程多出一条请求。
背景
动态工作流搭载在 Managed Agents 上,那是 Anthropic 面向开发者的智能体托管运行平台。功能于 10 月 9 日以公开测试形式上线,调用需带 anthropic-beta: managed-agents-2026-04-01 请求头(Latent Space 说它「上周五发布」,InfoQ 中文站写明 10 月 9 日)。在那之前,平台的多智能体形态是 subagents:主智能体把任务分给子智能体,再逐个读汇报,一个会话最多同时挂 25 个子线程,委托层级只有一层。主线程必须亲自吞下每个子智能体的中间结果,上下文和延迟都堵在这里。动态工作流把这一段换掉,官方文档的说法是「上下文和结果以程序方式从一个智能体传给另一个」,主会话线程因此空出来。
这个方向有前情可接:智能体能力上,Arena 智能体榜 10 月 12 日显示 Claude Opus 5.5 Max 首次入榜即登顶;计费侧,Anthropic 10 月 7 日给 Max 与 Team 订阅加了每月 API 额度,覆盖清单里就包括 Managed Agents。
事实部分
机制与数字出自官方两页文档(10 月 14 日查证):
| 项目 | 官方数值 | 触顶或超限后 |
|---|---|---|
| 单次运行累计子智能体 | 1000 个 | thread_limit_error |
| 同时并发线程 | 64 个 | 新工作排队等线程结束,API 注明不保证该数值 |
| 运行寿命 | 默认 24 小时 | timeout_error,暂停不停表 |
| 每会话并发运行数 | 默认 10 个 | max_workflow_runs_error |
| 会话子线程 | 最多 25 个 | 新线程被拒 |
程序由主智能体在对话里现场生成,不需要额外的 API 调用;官方原文是「Claude 写一个程序来编排智能体,而 Claude 不直接参与」。运行分阶段推进,每个子智能体在独立会话线程里工作;失败的子智能体可以在新线程重跑,所以线程总数可能超过 1000。
计费按会话预算走:预算覆盖 token、网页搜索等用量,按各模型公开标价计算,运行本身没有独立价格。预算触顶(budget_reached)不是硬中断——文档明说「每个线程会把已经开始的模型请求跑完」,运行可以按每个在途线程超预算一条请求;调高或移除预算能恢复被暂停的运行,但对没有公开标价的模型,只有移除才恢复。completed 状态只表示程序跑完,原文是「结果不说明工作是否通过」,验收要逐线程查事件。
一个口径差异值得记下:部分中文报道把 1000 写成「同时调度千个智能体」,官方文档说的是运行生命周期内的累计数。
各方说法
Latent Space 的报道(Richard MacManus,10 月 12 日)记录了现场演示:一个股票观察列表扫描器,扫描阶段把代码分给各自带隔离上下文的子智能体,评审阶段汇总成报告。被问到成本,CJ Avilla 承认动态工作流比单智能体方案「贵得多(much more)」,但「在找全细节上也有效得多」。MacManus 自己的观察是,这个演示「与 Anthropic 鼓励开发者去尝试的那些大而野心勃勃的项目相去甚远」。
问答里另外两点值得记:被问到怎么调度数百个子智能体,回答是靠评估和更保守的默认值;被问到工作流能否在多次运行间自我改进,Harrison Stall 说「这没有内建(this wasn’t built in)」,建议用 hill-climbing 或研究预览的 dreaming 功能自己搭。子智能体之间共享文件系统,但不能通过 API 直接互发消息。
InfoQ 中文站(林绮蓓,10 月 13 日)的分析集中在风险侧:熔断非硬中断,并行场景可能超支;共享文件系统有权限与状态冲突的风险;重试可能对外部系统重复写入;「主智能体少读一些中间结果」推不出整体更省钱。
编辑判断
对已经在用 Agent SDK 或 Managed Agents 跑长任务的团队,这次披露给出了真实的规模边界。代码审计、大规模迁移、需要交叉核验的研究——任务能拆、结果能程序化合并的场景,是把编排交给服务器的合理候选;一次性的对话任务没必要为此改架构。
实质变化是责任转移:编排从「模型每步决定」变成「模型写一次、平台照着跑」。可预测性和可观测性变好,每个线程有事件流可查;但循环、重试、结果校验的正确性从模型挪到了程序层,写提示词的人要为程序的边界条件负责。
诚实的坑有三层:成本更高,工程师自己承认;completed 不等于成功;模型在运行中不知道自己花了多少钱,预算是创建者的约束——Stall 被问到要不要把预算告诉模型时打趣说,那可能让它「有点焦虑(a little bit anxious)」。
还有文档没写的:编排程序用什么语言或形式表示,官方页面没有说明;平台没有列出运行的端点,运行事件也不触发 webhook,运维状态要自己从会话事件流里拼。
怎么试
文档在 platform.claude.com 的 Managed Agents 一节:「Multiagent orchestration」讲机制,「Workflow runs」讲运行边界与事件。调用带 anthropic-beta: managed-agents-2026-04-01 请求头;在系统提示或用户消息里写触发规则(官方示例思路:「当你被要求审查多份合同时,启动一个工作流运行」),并在创建会话时把预算设好——事后补不了。