智谱 GLM-5.3-Highspeed 现身 Zcode,网友实测 490 tokens/s
智谱未官宣的 GLM-5.3-Highspeed 在 Zcode 随机灰度,网友实测 490 tokens/s,官方数字与定价未公布。
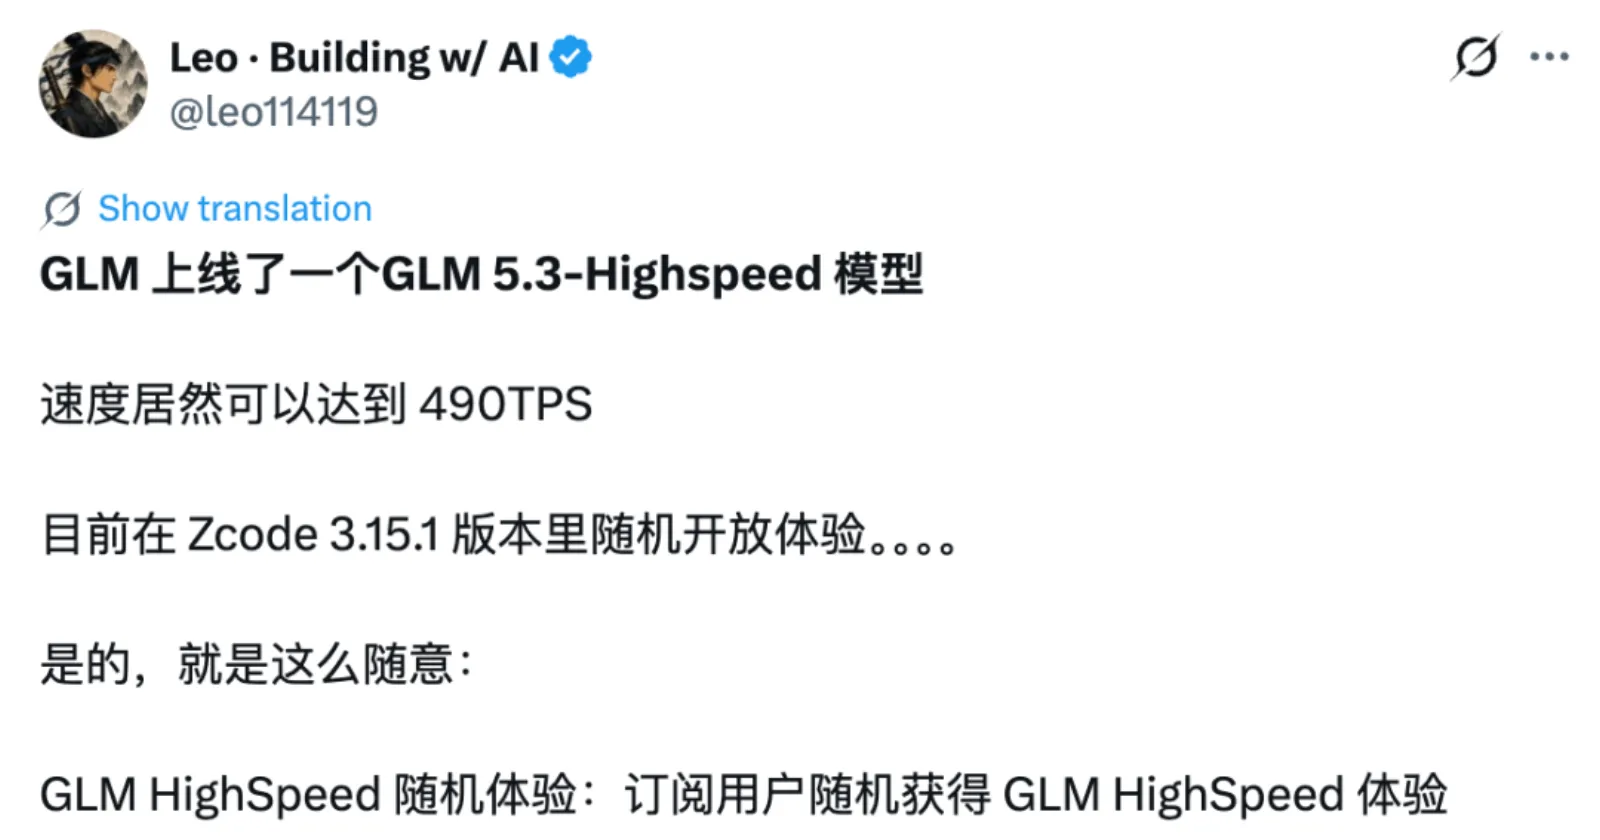
10 月 12 日,据量子位报道,智谱一个尚未官宣的新模型 GLM-5.3-Highspeed 出现在 Zcode 3.15.1 里,向部分订阅用户随机开放。网友 Leo(@leo114119)晒出的实测速度达到 490 tokens/s——照这个速度,输出 1 万 token 的生成阶段只要约 20 秒。智谱官方没有发过公告,Z.ai 开发者文档的模型列表(10 月 12 日查看)里也还没有这个名字。
要点
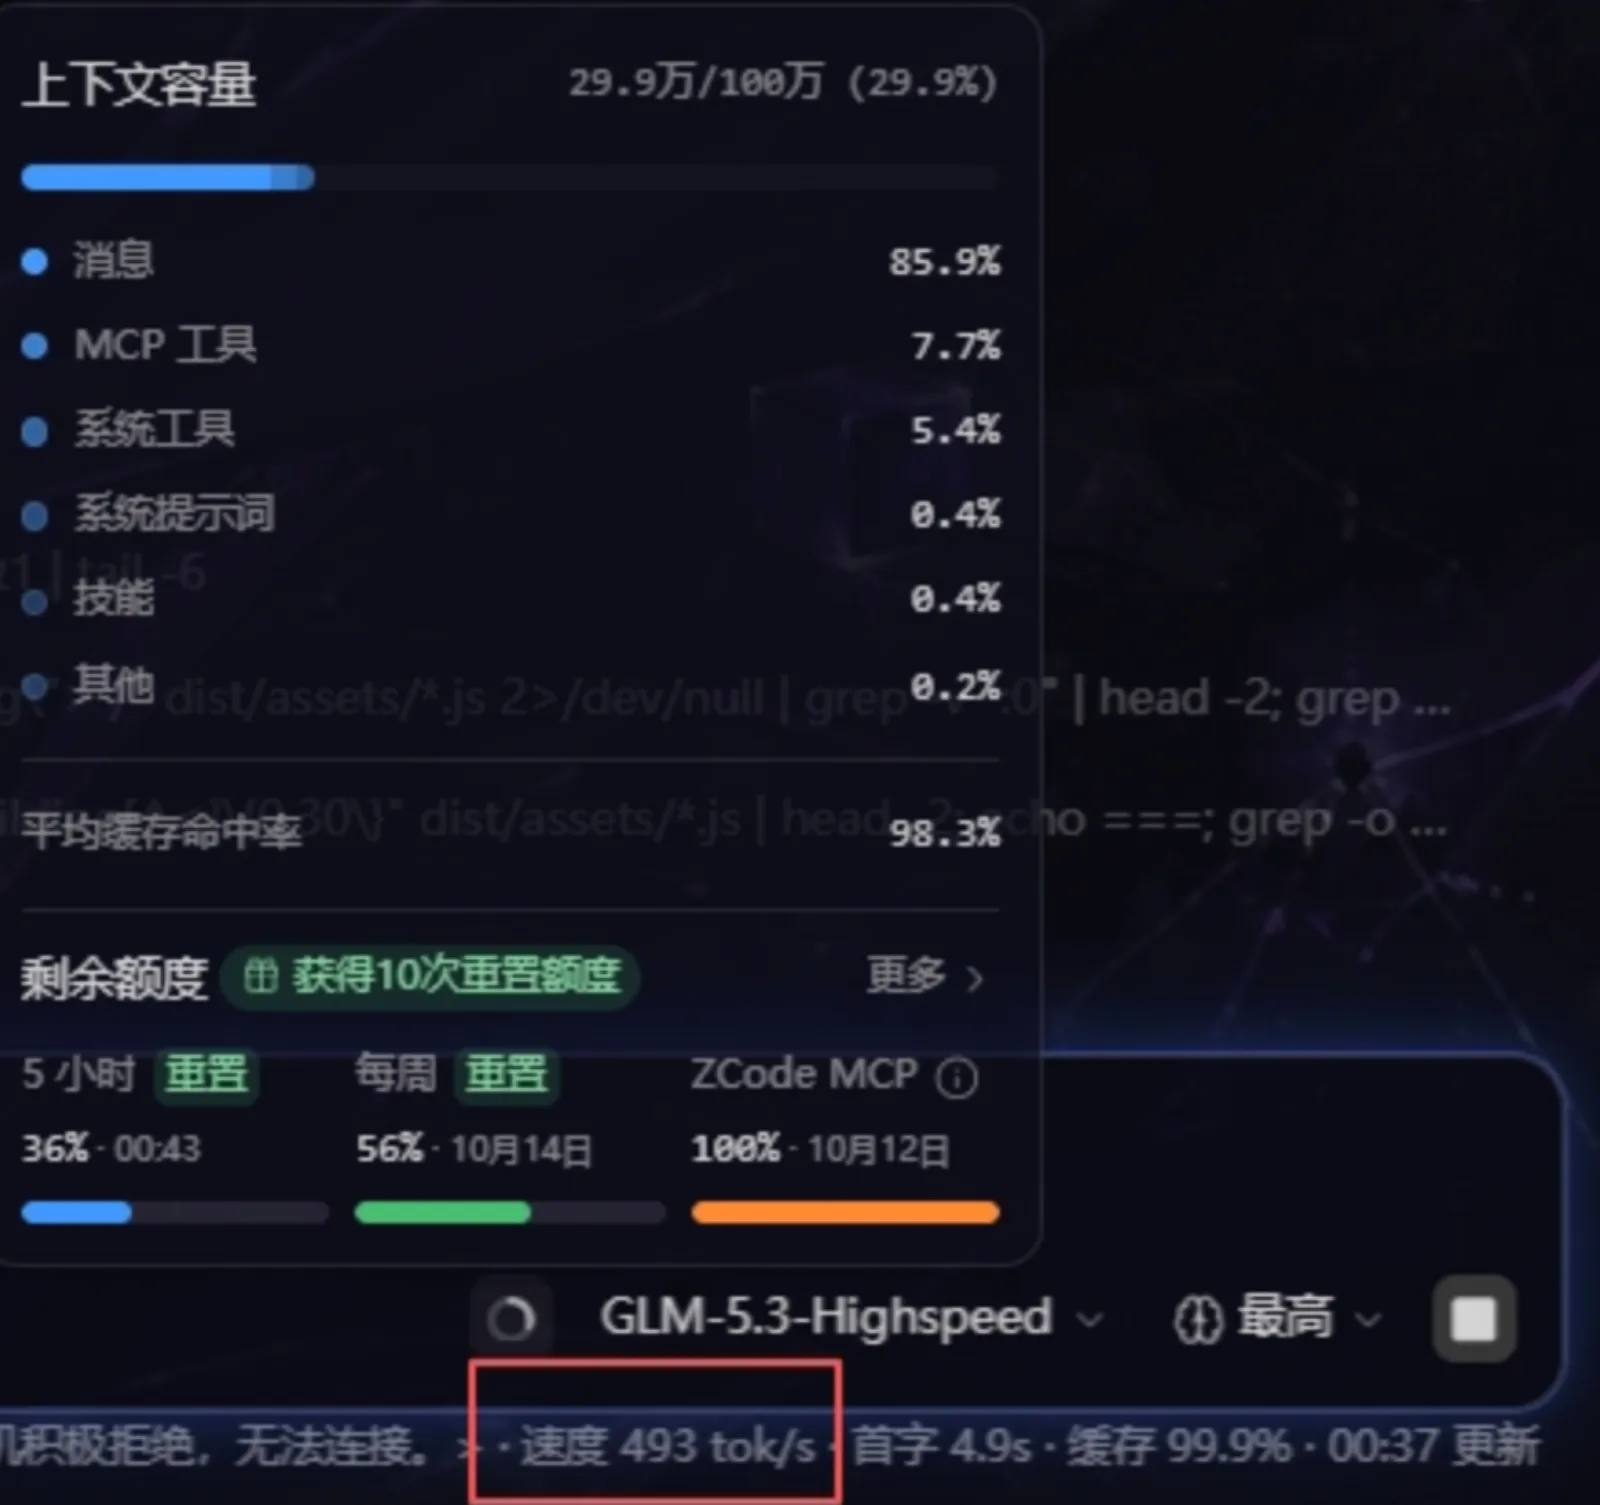
- 490 tokens/s,来源是个人截图:@leo114119 的 X 帖子和随后流传的 Zcode 界面截图(状态栏显示 493 tok/s、缓存 99.9%),智谱未确认,也没有第三方复测。
- 随机灰度,无申请入口:@leo114119 帖子里的原话是「GLM HighSpeed 随机体验:订阅用户随机获得」;量子位作者本人也没有被灰度到。
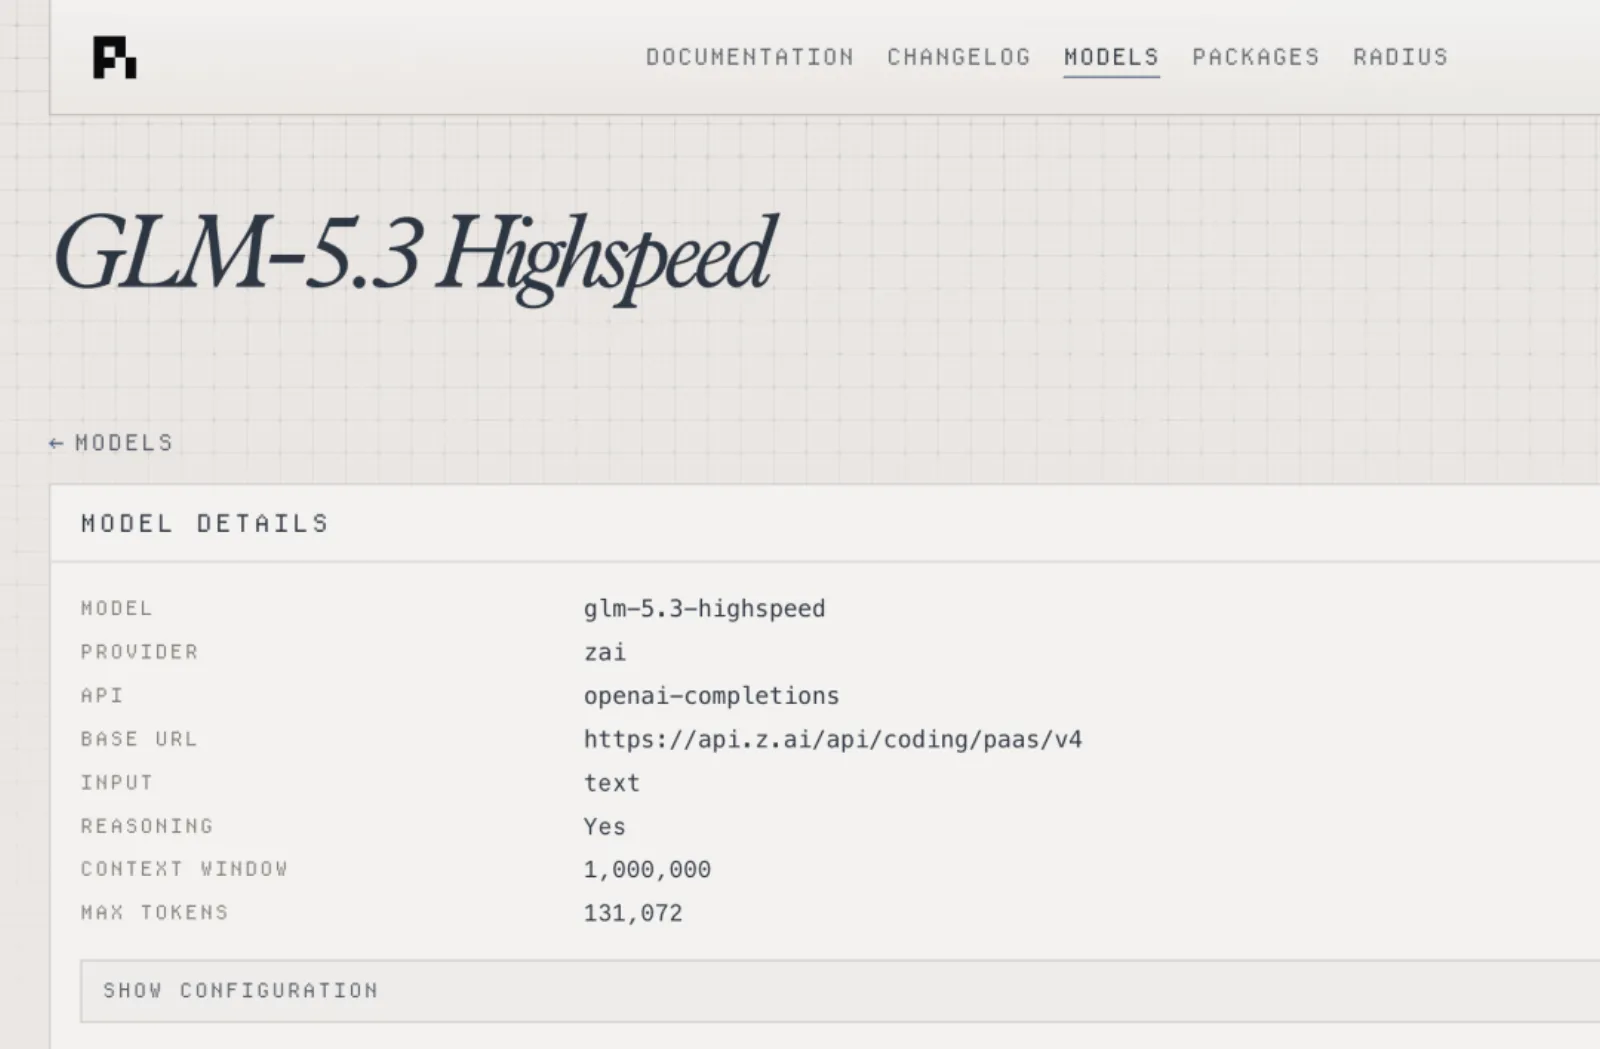
- 规格已在第三方目录露面:Pi 的模型目录收录了 glm-5.3-highspeed——100 万 token 上下文、最大输出 131,072、off/low/high/max 思考档位,标价一栏是 $0。
背景
速度是智谱这条产品线的明线。8 月发布的 GLM-5.3 主打编程,9 月的 GLM-5.3-FlashX 把最高速度做到 200 tokens/s;据量子位援引 Artificial Analysis 的测速,GLM-5.3-Flash 在 Z.ai API 上的输出约为 60 tokens/s。再往前,据量子位回顾,今年 5 月的 GLM-5.1-highspeed 曾做到 400 tokens/s,当时被称为刷新了 API 输出速度的上限。隔几个月提一档速度,是这家公司的固定节奏。
匿名模型的伏笔也在。9 月初,OpenCode 上出现匿名模型 Omen Alpha,用户界面里一度显示 zhipu/omen-alpha 标签,社区由此判断它属于智谱 GLM-5 家族。我们此前写过匿名模型 Space Bunny 登顶 OpenRouter 与 OpenCode 调用量榜——匿名模型抢走注意力的事,上个月刚发生过一次。对手同样在快模型上加注:MiniMax 9 月底上线 M3.1-Flash 预览,把 1M 上下文打进 Flash 档,同样暂无定价。
事实部分
Pi 模型目录(10 月 12 日查看)给出的规格:
| 项目 | 数值 |
|---|---|
| 模型名 | glm-5.3-highspeed |
| 提供方 | zai(api.z.ai/api/coding/paas/v4) |
| 上下文 | 1,000,000 tokens |
| 最大输出 | 131,072 tokens |
| 思考档位 | off / low / high / max |
| 目录标价 | $0,正式定价未公布 |
速度对比(各数字来源与时间如下):
| 模型 | 输出速度 | 来源 |
|---|---|---|
| GLM-5.3-Flash | 约 60 tokens/s | Artificial Analysis,转引自量子位 |
| GLM-5.3-FlashX | 最高 200 tokens/s | 量子位,2026-09 |
| GLM-5.1-highspeed | 400 tokens/s | 量子位回顾,未独立核实 |
| GLM-5.3-Highspeed | 490 tokens/s | @leo114119 截图,2026-10-12 |
可用性方面:Zcode 3.15.1 订阅用户随机灰度,没有申请入口;Pi harness 的模型列表已经可见该模型;Z.ai 官方文档(10 月 12 日查看)目前只列出 GLM-5.3 与 GLM-5.3-Flash。Pi 目录还显示,模型同时挂在 zai 的国际端点与国内端点(zai-coding-cn)下,base URL 走的是 /api/coding/ 路径——与「Coding Plan 订阅福利」的分发方式一致,而非通用开放 API 模型。那张 Zcode 截图里还能看到平均缓存命中率 98.3%、上下文已用 29.9 万/100 万,与 Pi 目录的 1M 窗口对得上。
各方说法
爆料人 Leo 在 X 上强调这次的分发「就是这么随意」——随机发放,不是申请制。r/ZaiGLM 的讨论里,发帖人 IsseyShiitake 把 Highspeed 和 Omen Alpha 联系起来:传言称那个匿名模型「性能与 5.3-Flash 几乎相同,速度约 3 倍」,与 Highspeed 的画像对得上。也有人提醒别急着高兴:Reddit 用户 Sad_Recording_1290 拿 OpenAI 的快速模式做类比——快是有代价的,那个模式速度加成 50%、单价翻倍,Highspeed 转正后大概率也有自己的计费档或配额。IsseyShiitake 还回忆说,Z.ai 的定价页写过最贵的套餐可优先体验新模型——若属实,这次「随机」未必全凭运气。围绕 Omen Alpha 本身,量子位转述的社区实测结论是「速度快、思考久、效果还蛮好」;也有用户直说 GLM 5.3 「有点慢」,速度够快的话「就太疯了」。截至发稿,没有任何独立跑分,所有速度数字都来自个人截图。
编辑判断
如果 490 tokens/s 站得住,编程 agent 的体感瓶颈会明显后移:同样输出 1 万 token,Flash 要等约 3 分钟,Highspeed 只要 20 秒,长任务里「等模型」的时间占比大幅下降。这对每天跑 agent 的人是实打实的差别,也是编程套餐竞争的新变量——速度成了继上下文长度之后的下一个比拼维度。不在 Zcode 生态里、走标准 API 的团队,这条消息暂时只是观察项:模型还没进开放 API 的价目表。但这笔账要算得诚实:数字来自一张截图,无官方确认、无第三方复测;灰度随机,多数订阅用户现在还刷不到;定价未公布,「快」最终怎么收费是未知数。下一件值得盯的事是智谱的正式公告——如果 Highspeed 被证实就是 Omen Alpha,「匿名模型是下一任正式版」的剧本又多了一个案例。
怎么试
把 Zcode 升到 3.15.1,在模型列表里找 GLM-5.3-Highspeed;没有就说明未被灰度,只能等下一轮发放。量子位作者猜自己没被灰度可能与 Lite 套餐有关——帖子里没有定论,但 Lite 用户先别抱太大期望。被灰度到的用户,跑一个长输出任务看状态栏的实际 tok/s,是眼下唯一验证 490 这个数字的方式。