Google 发布 TPU 8tx 与 8i Max,分别主攻机密推理和大上下文
Google 官方博客 11 月 10 日公布 TPU 8tx 与 8i Max;两篇媒体报道日期为 11 月 9 日,前者面向机密推理,后者采用双芯封装。
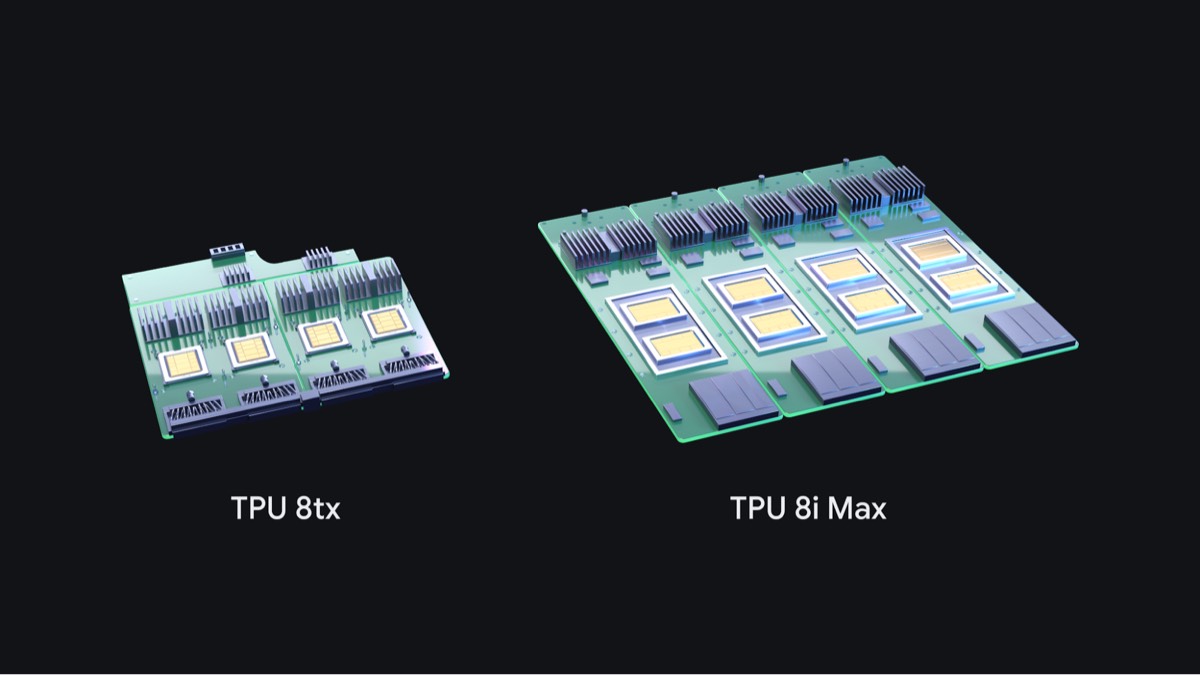
Google 官方博客于 2026 年 11 月 10 日刊出 TPU 8tx 与 8i Max 的公告;Data Center Dynamics 与 Network World 的报道日期为 11 月 9 日。TPU 8tx 面向机密推理和小规模训练,TPU 8i Max 则把两颗 TPU 8i 集成进一个封装,目标是为大上下文推理提供更多片上内存与带宽。官方称 8tx 相对 TPU 8t 的延迟最高可低 2 倍;这仍是厂商口径,目前没有找到第三方复测。
要点
- TPU 8tx 把机密计算加入 Google 第八代 TPU 产品组合,官方定位包括处理敏感数据的推理、小规模训练,以及微调、蒸馏和强化学习等工作。
- TPU 8i Max 以两个 8i 芯片组成一个封装;Google 称其计算能力、SRAM 容量和 HBM 带宽均为 TPU 8i 的两倍。
- Google 没有公布两套系统的供货日期或价格;现有报道转述的是发布信息和厂商说明,没有独立性能复测。
背景
Google 把第八代 TPU 拆成不同工作负载方向,而不是只发布一个更大的通用加速器。TPU 8t 的重点是大规模训练,TPU 8i 面向低延迟推理;这次新增的 8tx 与 8i Max 分别围绕“运行时保密”和“上下文内存压力”展开。这个划分对应两类部署难题:数据与模型权重在推理过程中如何保持隔离,以及长上下文请求如何避免被内存容量和搬运速度拖慢。
这并不意味着芯片本身能解决所有系统瓶颈。一个模型服务仍要安排主机、网络、存储、调度和软件栈,芯片规格只有放进完整任务后才能转化为服务延迟、吞吐或成本。此前本站报道过 Inferact 用 TPU v7 部署 Kimi K3;那篇实测报道可以作为 TPU 部署案例的参照,但它测试的是不同一代硬件和不同模型,不能直接拿来验证 8tx 的数字。
事实部分
Google TPU 8tx 与 TPU 8i Max 的关键差别,是一个把保密边界作为产品卖点,另一个把更多计算与内存资源塞进单个封装。下表区分已公布的设计方向与厂商宣称的性能,不把宣传数字写成独立测试结论。
| 系统 | 设计与目标 | 已公布的比较 | 当前缺项 |
|---|---|---|---|
| TPU 8tx | 面向机密推理和小规模训练 | Google 称延迟相对 TPU 8t 最高低 2 倍 | 独立复测、详细测试条件、价格和供货日期 |
| TPU 8i Max | 两颗 TPU 8i 集成一个封装,面向大上下文推理 | Google 称 compute、SRAM 与 HBM bandwidth 均翻倍 | 真实模型下的性能、容量数字和供货日期 |
Data Center Dynamics 将 8tx 描述为建立在 TPU 8t 硅片基础上的机密计算方案,并提到配套主机与 Boardfly 网络;它同样把最高 2 倍的延迟改善归于 Google 的说法。Network World 补充了 TPU 8i Max 的内存数据:报道转述 Google 称该系统有 384 GB HBM、17.2 TB/s 带宽和 768 MB 片上 SRAM。报道也称相较 8i,HBM 容量增加约三分之一,而带宽和 SRAM 翻倍。这些数值都是发布材料中的规格或厂商陈述,并非媒体自行跑出的基准。
对 8tx,Google 宣称硬件级保护可在数据处理期间隔离敏感输入和模型权重。官方还把它放在私有数据微调、模型蒸馏和强化学习等工作流里。公开页面没有给出威胁模型、具体可信执行边界、验证接口细节或各类主机与设备组件的攻击面清单,因此“机密计算”应理解为系统设计目标,而不是对所有泄漏路径的笼统保证。
两种瓶颈
大上下文为何需要更高内存带宽,是 TPU 8i Max 值得观察的技术问题。模型处理长上下文时,权重之外还要保存与读取上下文相关的中间状态;并发请求越多,内存容量和访问带宽越可能成为限制因素。把两颗 TPU 8i 放到一个封装,并同步增加 SRAM 与 HBM 带宽,针对的是数据在计算单元附近的存放和搬运能力,而不只是峰值运算量。
但“规格翻倍”不能直接推出端到端吞吐翻倍。应用是否受内存限制、模型的上下文长度、批处理方式、缓存命中率、并发请求和软件调度都会改变收益。Google 没有在这次公告中提供一组公开、可重复的长上下文基准来说明这些条件下 8i Max 的实际收益。采购团队需要等到真实工作负载测试,才能判断额外 SRAM 和 HBM 带宽能否换来更高吞吐或更短首 token 延迟。
8tx 的挑战也不止于芯片是否支持隔离。机密计算要回答数据在何处解密、主机能否检查运行状态、模型权重如何载入、设备间通信是否受保护,以及发生故障时密钥如何处理。Google 提到数据与模型权重在处理期间受到保护,但公告所给信息不足以让外部团队判断信任边界究竟覆盖哪些组件。合规团队仍需要完整的架构说明、证明流程和运维控制,再把它纳入风险评估。
各方说法
三家来源提供的侧重点并不相同。Google Cloud 的公告负责定义产品定位和性能主张;Data Center Dynamics 把注意力放在产品线扩展、8tx 的保密用途及机柜密度上;Network World 则将 8i Max 放到内存和数据搬运瓶颈中解释,并给出更多内存规格。后两篇报道都在转述产品发布和 Google 的材料,没有报告第三方基准测试,也未提供独立的安全审计结果。
Network World 提到的 384 GB HBM、17.2 TB/s 和 768 MB SRAM,为“面向大上下文”的市场定位提供了可核对的规格基线;然而,单有容量与带宽并不能说明特定模型能容纳多少上下文或同时服务多少用户。实际结果还取决于模型结构、KV cache 精度、分片和服务软件。读者可以把这些数字当作硬件配置,而不能把它们当成已验证的服务性能。
编辑判断
Google TPU 8tx 与 8i Max 是把两种具体需求写进硬件组合:8tx 针对需要在云上处理敏感数据、但希望减少云运营方接触数据能力的团队;8i Max 面向长上下文或高并发推理中受内存和数据搬运限制的服务。前者的核心问题是信任边界是否可验证,后者的核心问题是额外的本地内存资源能否被真实工作负载用满。
现在能下的结论有限。8tx 的“最高低 2 倍延迟”是 Google 的对比口径,未见第三方复测;8i Max 的翻倍规格也尚无独立工作负载结果。两者的价格、区域和供货时间都没有公布。对开发者来说,现阶段适合先梳理自己的约束:敏感数据经过哪些组件、谁能访问主机与模型权重;长上下文服务又是在显存容量、带宽还是调度上受限。等产品开放后,再用自己的模型、上下文长度和并发模式做对照测试,才知道这两种设计是否对应到实际收益。