特斯拉公布 SI 系列加速器路线图,SI6 算力标称 HW4 的 80 倍
特斯拉演示材料 11 月 6 日披露 SI 路线图:SI6 标称 HW4 的 80 倍算力;Dojo D3 改用 chiplet 加 HBM,面向太空。
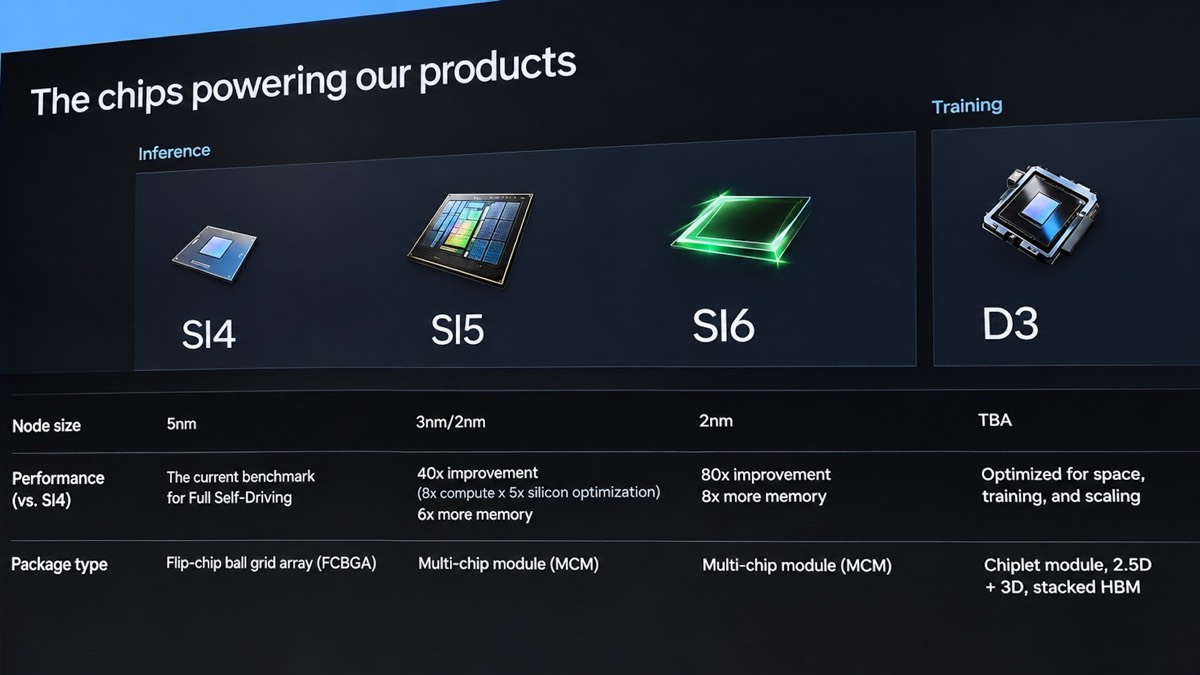
特斯拉 11 月 6 日流出的演示材料给出了一条完整的自研芯片路线图:推理加速器从现役的 HW4(新版图上改称 SI4)起步,SI5 标称性能是 SI4 的 40 倍、已接近量产,SI6 标称 80 倍、2029 至 2030 年落地;训练芯片 Dojo D3 在去年 8 月晶圆级方案被砍后重新出现,封装改为 chiplet 加堆叠 HBM,用途一栏写着「面向太空、训练与扩展」。这些倍数全部出自特斯拉自己的幻灯片,幻灯片照片经 Tom’s Hardware 于 11 月 6 日刊出,Mezha、TipRanks 等媒体当日跟进。注意口径:80 倍是厂商路线图标称,不是任何第三方测过的数字。
要点
- 演示材料将 HW4/AI4 改称 SI4,SI5 标称 40 倍(8 倍算力乘 5 倍硅片优化)、96 GB 显存、250-800 W,状态「接近量产」;SI6 标称 80 倍、144 GB 显存、2 nm 级制程、2029-2030 年
- Dojo D3 从 D1 的晶圆级 SRAM 架构改为 chiplet 加 2.5D/3D 封装、堆叠 HBM,优化目标写明「太空、训练、扩展」,但规格、制程、时间表全部空缺
- 幻灯片上 SI4 的制程写的是 5 nm,Tom’s Hardware 指出这与其已知的三星 7 nm 级工艺不符——读这份路线图要带着核对的习惯
背景
特斯拉的自研芯片此前只服务一件事:车上的自动驾驶推理。HW3 是 2019 年那代 14 nm 芯片,官方标称 72 TOPS;HW4 按马斯克自己的说法是 HW3 的 3 到 8 倍,外界由此倒推其算力在 216 到 576 TOPS 之间,16 GB GDDR6 显存。训练侧的 Dojo D1 用晶圆级集成(25 颗 D1 拼成一片晶圆,440 MB SRAM 每颗、整晶圆约 11 GB SRAM、片上带宽约 10 TB/s、362 TFLOPS),但这条线在 2025 年 8 月被马斯克砍掉,2026 年 8 月他进一步表态 SpaceX 和 xAI 的地面与太空数据中心将只用英伟达硬件——当时普遍认为 Dojo 已经死了。
转折发生在今年 4 月:据 Not a Tesla App 报道,特斯拉在 Austin 的 TERAFAB 活动上把 D3 重新放回叙事,理由是「硬件必须离开地球」——马斯克当时的算账是发射成本很快会比建地面数据中心便宜,太空中 24 小时有日照、散热可以直接向太空辐射。本站在谷歌把第一颗 TPU 送入轨道里记录过同一趋势:谷歌的 Suncatcher 计划也要把 TPU 送上天,轨道算力已经从科幻设定变成至少三家公司排队的事。
事实部分
特斯拉 SI 系列路线图的可核对信息如下,均出自 11 月 6 日的演示材料幻灯片与 Tom’s Hardware 同日的报道;带「估计」字样的数字是 Tom’s Hardware 基于马斯克口径的推算,特斯拉未公布官方 TOPS 值。
| 芯片 | 角色 | 制程 | 封装 | 显存 | 性能口径 | 状态 |
|---|---|---|---|---|---|---|
| SI4/HW4 | 推理 | 三星 7 nm 级(幻灯片误写 5 nm) | FCBGA | 16 GB GDDR6 | 估计 216-576 TOPS | 量产中 |
| SI5/AI5 | 推理 | 台积电 3 nm / 三星 2 nm 级 | MCM 多芯片模块 | 96 GB(GDDR6/GDDR7 未定) | 标称 40 倍;估计 8,640-23,040 TOPS | 接近量产 |
| SI6/AI6 | 推理 | 2 nm 级 | MCM | 144 GB GDDR7(未定) | 标称 80 倍;估计 17,280-46,080 TOPS | 开发中 |
| Dojo D3 | 训练 | 未公布 | chiplet,2.5D+3D | 堆叠 HBM(容量未公布) | 未公布 | 开发中 |
几个值得停下来的细节。SI5 的 40 倍是马斯克拆给的两项相乘:8 倍算力密度乘 5 倍「硅片优化」,功耗按用途在 250 到 800 W 之间,显存带宽视 GDDR6 还是 GDDR7 在 768 GB/s 到 1.536 TB/s 之间。SI6 的 TOPS 区间之所以宽达 2.7 倍,是因为 HW4 本身就只有推算区间、且特斯拉从未公布支持的数值格式——不同精度下的 TOPS 不能直接比。制造方面,SI5 双代工(台积电 3 nm 与三星 2 nm),SI6 归三星,双方协议覆盖到 2033 年(此前报道的 165 亿美元合同),候选工艺 SF2A、SF2P 或带背面供电的 SF2Z;路线图上没有 Intel 14A。SI6 用 HBM 的可能性,Tom’s Hardware 判断为低。
D3 那一栏几乎是空的:只有「chiplet 模块、2.5D+3D、堆叠 HBM」和「面向太空、训练、扩展」两行字。从 SRAM 中心转向 HBM 是对 D1 路线的事实否定——大模型的参数和激活值早已超出片上 SRAM 能装下的规模,这也是行业主流(英伟达、AMD、谷歌 TPU)都在走的路。 wafer-scale 是否彻底放弃,Tom’s Hardware 的判断是「可能性较低」,理由是成本、良率与散热,但这属于媒体推测而非官方口径。
各方说法
Tom’s Hardware 的角度是数字核对:指出幻灯片把 SI4 制程误写成 5 nm,倒推出 TOPS 区间,并把 SI6 与今天就在出货的英伟达 Rubin 放在一起——Rubin 推理标称 50 PFLOPS(NVFP4),SI6 要等到 2029-2030 年。评论区的高赞意见不客气:「没有一个发布日期,标准的马斯克」「他们最后大概率还是去买英伟达的芯片」。伊朗 Technoc、法国 Charles Tech、西班牙语媒体当日均转述了同一份幻灯片,事实口径一致。
市场用钱投了票:据 TipRanks 11 月 6 日报道,路线图流出当天 TSLA 盘中涨近 5%,尽管该股过去一年累计跌约 23%。分析侧的保留意见以 1950.ai 的长文为代表:TOPS「无法在不数值格式的情况下直接对比」,太空部署要过辐射容忍、纠错、冗余、无风冷散热四道关,「路线图与商品之间隔着相当的距离」。IT 之家 11 月 8 日的中文转述补充了完整表格,但也把「演示材料披露」与「媒体推测」分开标注——例如 D3 是否放弃晶圆级,媒体自己承认只是推测。
编辑判断
这份路线图真正的信息量不在 80 倍,而在两处结构变化。其一,特斯拉自研芯片第一次从车规推理扩张到数据中心加速器的叙事里——SI5/SI6 的功耗档位(250-800 W)已经完全超出车载范围,这是在给 Dojo 空出来的训练与推理市场补位。其二,D3 转向 chiplet 加 HBM 等于公开承认 D1 的晶圆级路线走不通,行业主流路线没有捷径。
对关注算力的读者,建议把三个数字都除以一个折扣系数再看:倍数出自厂商幻灯片、TOPS 是第三方推算、落地时间 2029-2030 距今三年以上,而英伟达的竞品此刻就在出货。真正值得跟踪的先行指标是 SI5——它接近量产,2027 年前后装车装机器人,届时 40 倍的标称能否兑现为可测的性能,会决定 SI6 的 80 倍值不值得押注。太空那一栏眼下更像叙事而非产品:D3 没有规格、没有时间表,2026 年 8 月马斯克还说过 SpaceX 和 xAI 只用英伟达。这份路线图改变预期的地方在于特斯拉把自己放回了自研芯片牌桌;改变现实的地方,还要等第一片 SI5 出厂。