Linus 用 Claude Code 写内核补丁:64 线程读吞吐 23 倍,合入前被揪出竞争条件
Linus Torvalds 用 Claude Code 写内核补丁:64 线程读吞吐自测 13.3M→304M 次/秒,评审发现竞争条件,未合入。
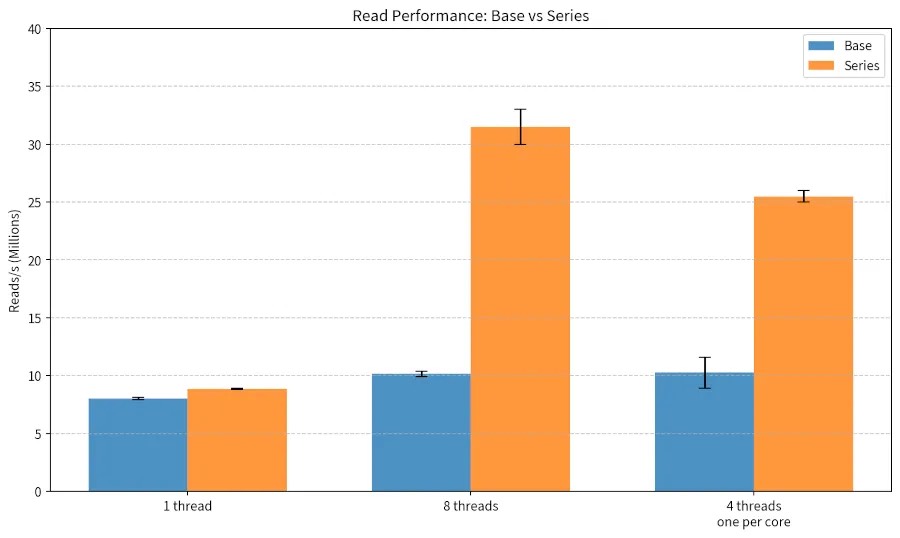
10 月 13 日,Linux 内核创建者 Linus Torvalds 把自己那组由 Claude Code 参与写成的 page cache 读路径补丁贴上 LKML(Linux 内核邮件列表),标题是「Improve page refcount scalability」。他把 16 字节 pread() 的读吞吐自测数据写进了提交说明:在 32 核 64 线程的 Ryzen Threadripper 3970X 上,64 个线程读同一个文件从每秒 1330 万次涨到 3.04 亿次,每次读的内核周期从 19857-19939 降到 735-736。补丁至今没有合入——内核维护者在评审阶段发现了读路径上的竞争条件。
要点
- 补丁系列有 10 个提交,主题是把 folio 的最终释放推迟到一个 RCU grace period 之后;10 个提交每个都带
Assisted-by: LLM标签,前 8 个只有 Linus 一人的Signed-off-by,第 9、10 两个是 Kiryl Shutsemau 在前、Linus 在后。 - 23 倍出自 Linus 10 月 13 日发上 LKML 那封信里的原话「I see a 23x performance increase on my Ryzen threadripper」,测试是 64 个线程反复读同一页的合成负载,他自己在同一段里写明「真实场景影响会小得多」。
- 竞争条件由 Meta 的内核维护者 Kiryl Shutsemau 在 10 月 13 日当天首次提出:
filemap_read_rcu_batch()里如果 folio 被换掉、i_size随后扩展,用户态可能读到从未写入过的数据。
背景
这个瓶颈已经挂在内核邮件列表里两年多。Linus 在 10 月 13 日发上 LKML 的那封信里把来龙去脉写得很直白:Matthew Wilcox 2024 年从一个客户工作负载提出这个问题,Linus 自己当时有个「很粗糙的第一版草案」,用了 18 个月才发现它「坏得够彻底」;之后 Kiryl Shutsemau 有个「稍作修正的版本」,也有问题;Ilya Gladyshev 换了条路子,版本已经推到第 6 版,「仍有已知的根本性毛病」。Linus 说,今年内核维护者峰会的大议题之一正是「LLM 在内核开发中的使用」,于是他决定拿这个问题试一次 LLM。
补丁数在不同报道里有 8 和 10 两个数字,都对,是两个时间点。10 月 11 日晚上 Phoronix 的 Michael Larabel 在等 Linux 7.3-rc7 时刷 Linus 的仓库,发现多出一个叫 noref-filemap-read-with-llm 的分支,基于 7.3-rc6,8 个提交;10 月 13 日贴到 LKML 的已经是 rcu-free-v3 分支上的 10 个提交。中间那次改版把 PG_rcu_free 的设置从「folio 离开 page cache 时」移到了「读取路径上发现这个 folio 反复被读回来时」,并补了 vmstat 计数和 OOM 前的强制释放。
Linus 对 AI 的态度这几年一直在动,ZDNet 的 Steven Vaughan-Nichols 按时间线梳理过:2023 年 12 月他说 AI 是「能帮我们做得更好的工具」,但兴趣集中在找 bug;到 2025 年底他自称「非常相信 AI 是工具」;2026 年 10 月 9 日在布拉格 Open Source Summit Europe 上与 Dirk Hohndel 对谈时,原话是「I used to think it was just not very good — but now I’m at the point where I actually really like using AI」,同时补了一句「做真正重要的事情时你得非常小心」。
事实部分
一次 read() 的代价在于共享的 cache line。filemap_get_read_batch() 取 folio 引用(lock cmpxchg)、filemap_read() 用完再放掉(lock decl),两次原子写都落在同一个 struct page 行上;Linus 在自己的笔记本(i7-8565U,4 核 8 线程)上测得,8 线程 16 字节 pread() 同一个页时,这一行占了跨核 load HITM 的 99.92%。这一组改动把引用计数整个从快速路径拿掉:folio 离开 page cache 后不立刻还给页分配器,而是等一个 RCU grace period,读者在 RCU 读侧临界区里可以直接从 page 拷到用户缓冲区——没有引用、没有栈上中转缓冲、没有 seqcount、没有拷贝后再校验,也没有读大小的上限。
| 测试 | 改前 | 改后 |
|---|---|---|
| 64 线程,reads/s | 13.3 M | 304 M |
| 64 线程,cycles/read | 19857-19939 | 735-736 |
| 32 线程(每核一个),reads/s | 13.4-13.7 M | 236-237 M |
| 8 线程 8 核,reads/s | 16.7 M | 60.5 M |
| 1 线程,cycles/read | 503-505 | 479-492 |
以上全部出自 rcu-free-v3 上 mm/filemap: read from the page cache without folio references 提交的 Numbers 一节:Threadripper 3970X(32 核 64 线程单路)、btrfs、单页文件、每个线程自己的 fd、每轮 5 秒跑三次,「before」是 7.3-rc6。Linus 对 64 线程那行的解读是:32 个核各一个线程时读同一文件已经和单线程一样便宜,改前则要贵二十倍。
笔记本上的数字(i7-8565U、ext4、mitigations off、CONFIG_HARDENED_USERCOPY off)来自 8 补丁那版的提交说明:8 线程 9.9-10.4 M 读/秒到 30-33 M,cycles/read 从 2937-2975 降到 725-726;单线程 452-454 降到 408-409;perf c2c 的 load HITM 从 30538 降到 101。代价也记在同一处:往未映射的用户页读要多一次失败异常,16 字节单线程读从 4117-4188 cycles 涨到 6543-6593。rcu-free-v3 上同一段话的配对是 4397-4428 → 6022-6296——两版的 before 不同,不是同一次测量,二手报道里常见的「约 4150 → 6550」混了版本。
Tools 一节是这件事被当成新闻的原因,原文在 8 补丁那版提交的末尾:「The code, the test programs, the review behind the list above and the first draft of this text were done with an LLM coding assistant (Claude Code) under my direction. The measurements were run on my machine.」——代码、测试程序、那份「已知问题」清单背后的评审,以及这段文字的第一稿,都出自 Claude Code,测量由 Linus 本机完成。rcu-free-v3 上 10 个提交每个都带 Assisted-by: LLM;Signed-off-by 前 8 个只有 Linus,第 9、10 两个(mm: count the pages waiting for a grace period and free them before OOM、mm: count the runs of the expedite work)是 Kiryl Shutsemau 在前、Linus 在后。Documentation/process/coding-assistants.rst 写明 AI 不得代替人签 Signed-off-by(DCO 只能由人认证),并要求 AI 找 bug 修 bug 时按九步流程走。
各方说法
10 月 13 日,Shutsemau 用一封邮件给出竞争条件的完整时序和一个补丁:CPU0 走 filemap_read_rcu_batch(),xas_load() 取到 folio A、确认 PG_rcu_free、xas_reload() 仍是 A;CPU1 同时 fadvise(FADV_DONTNEED) 把 A 挤出 page cache(释放被推迟,A 仍然有效),write() 重新填充 page cache 并把 i_size 扩展;CPU0 此时才读 i_size,于是 copy_page_to_iter(A) 把旧 folio 里「用户从未写入」的数据交了出去。Linus 在同一天的下一封回信里建议把 i_size 的读取提前、把两处 folio 有效性检查合并,并问出一个更要紧的问题:「你愿意把这整个系列接手过去吗?我周五开始休假,下周还要做合并窗口,现实地讲我没时间。」10 月 14 日,Shutsemau 解释 i_size 为何原本不能提前(uptodate 位的含义只在 reload 之后成立),同意改,同时坚持 filemap_read_rcu_can_copy() 里的 uptodate 检查必须保留——「PG_rcu_free 只说明 folio 被打标时是 uptodate,有些文件系统会清除留在 page cache 里的 folio 的 PG_uptodate,而且这可能发生在它拿到这个标志之后」。
内存回收设计是另一条争论线。Matthew Wilcox 说「I don’t like the PG_rcu_free flag」,建议改用页面类型字段(PGTY_rcu),或者让 inactive list 上的 folio 在一个 RCU 代之后立即可释放;Linus 10 月 13 日回信逐条否掉:标志必须在 folio 仍可映射进用户空间时设置,而只从 inactive list 回收覆盖不到 truncate 和 hole punch,「truncate() 在某些场景下会是很常见的情况」。Wilcox 还提到 Kiryl 用截断/hole-punch 的负载验证了他「害怕的那个东西」。Shutsemau 随后提议把该标志限制到 64 位系统,David Hildenbrand 回信支持「限制到 64 位很有道理」。Harry Yoo 担心的是「提交给 RCU 的 page cache 内存必须有个上限」,Linus 的回答是他最初的方案是让设标志的地方自己限流,但担心拖慢截断大文件这类「正在释放内存」的操作,最终改成在途页面多时主动 synchronize_rcu_expedited(),并实测了桌面启动加 Chrome 18 个标签、以及一次 make allmodconfig -j60 之后的 pgfree_rcu* 计数。
LWN(Jonathan Corbet,10 月 14 日)把它写成 brief,说这是「order-of-magnitude speedup for a read()-heavy benchmark」,并直接点出评审已经找到一个竞争条件。Hacker News 上 LWN 那条拿到 122 分、108 条评论,分歧集中在两处:tombert 写「我用 AI 像现在大多数软件工程师一样,但我得承认有点意外 Linus 也上车了」;另一条顶层评论里 vatsachak 写「这么多人从这个故事里读出『Linus 用了 Claude 改内核,所以谁都行』」,下面 atniomn 回他「别管为什么有人踩你,pilot LLM 是有技术门槛的」。mono442 则直接批评提交信息里的 AI 文风(「That llm yapping is annoying to read」)。中文侧目前只有 InfoQ 一篇(作者 Tina,10 月 16 日),oschina、知乎、IT之家等未见跟进。
编辑判断
这件事真正值得看的,是它把一个长期悬而未决的并发问题解掉了。「23 倍」是个合成测试的数字,经不起外推,但这个瓶颈 2024 年被提出、Linus 自己那个坏掉的版本跑了 18 个月,人写代码并没有更快解掉它;AI 在这里的作用更像把两年的工程推进集中释放出来。同时它给出了一份罕见完整的样本:8 补丁那版提交里的 Tools 一节能看到 AI 具体做了哪四件事(代码、测试、评审、文字第一稿),哪些没做(测量、最终判断、署名)。同一份提交信息把「已知问题」列成 10 条,包括分配器看不到在途页面(它们的引用计数为 0、不是 PageBuddy、不在任何 pcp 列表和计数器里)、alloc_contig_range() 会对含 page cache 的区间返回 -EBUSY、s390 的 __make_folio_secure() 会冻结引用计数而 RCU 读者挡不住它、以及没跑过 xfstests 和 KASAN——这种自曝程度在合并前的补丁里不常见,是评审能高效进行的原因。(这 10 条在 8 补丁那版里;rcu-free-v3 对应的提交只留 Numbers 表和 trailer,未再列。)
对写代码的人的用处有两层。第一层是机制本身:把引用计费的原子操作从热路径挪走、用 RCU 延迟释放换无锁读,这个套路不止 page cache 能用,任何「多核读同一对象、取放引用打爆一条 cache line」的场景都可以照这个思路拆。第二层是流程上的:Assisted-by: LLM 加 Signed-off-by 署名分离,意味着署名者对内容负全责;DCO 那一节写明 AI 不能代签,等于把责任钉在人身上。本站此前报道过 QGIS 全面禁止 AI 贡献后再进一步 和 Google 因 AI 报告泛滥冻结开源赏金,方向正好相反——内核这份样本显示的是第三种路:允许用,但人署名、人评审、人负责。
诚实的边界也要说清。23 倍是合成测试:64 个线程反复读同一页,没有任何真实负载长这样,Linus 在 10 月 13 日那封信的结尾自己写了「that’s not a real number in the sense that no real load will ever see it」。笔记本上单线程只快约 10%,读未映射用户页反而变慢,大量截断场景下的内存钉住问题被他称为「这组补丁里最没解决好的部分」(这句在 8 补丁那版的提交说明里)。10 月 16 日查证时,rcu-free-v3 仍在 Linus 自己的树里,master 的 mm/filemap.c 与 include/linux/page-flags.h 中均无 rcu_free 或 PG_rcu_free,未合入;Linus 已提议由 Shutsemau 接手后续开发,目标窗口是 Linux 7.4 合并窗口。The New Stack 写的是「Torvalds 已把后续开发交给 Shutsemau」,Linus 邮件里的原话是「Would you be willing to take this whole series over?」——是询问,不是交棒。