Meta 披露 Prometheus 超集群:一期已完成,并公布训练可靠性数据
Meta 10 月 19 日披露 Prometheus 数据中心:一期已完成,目标约 100 万块 GPU,预训练 goodput 超过 85%。
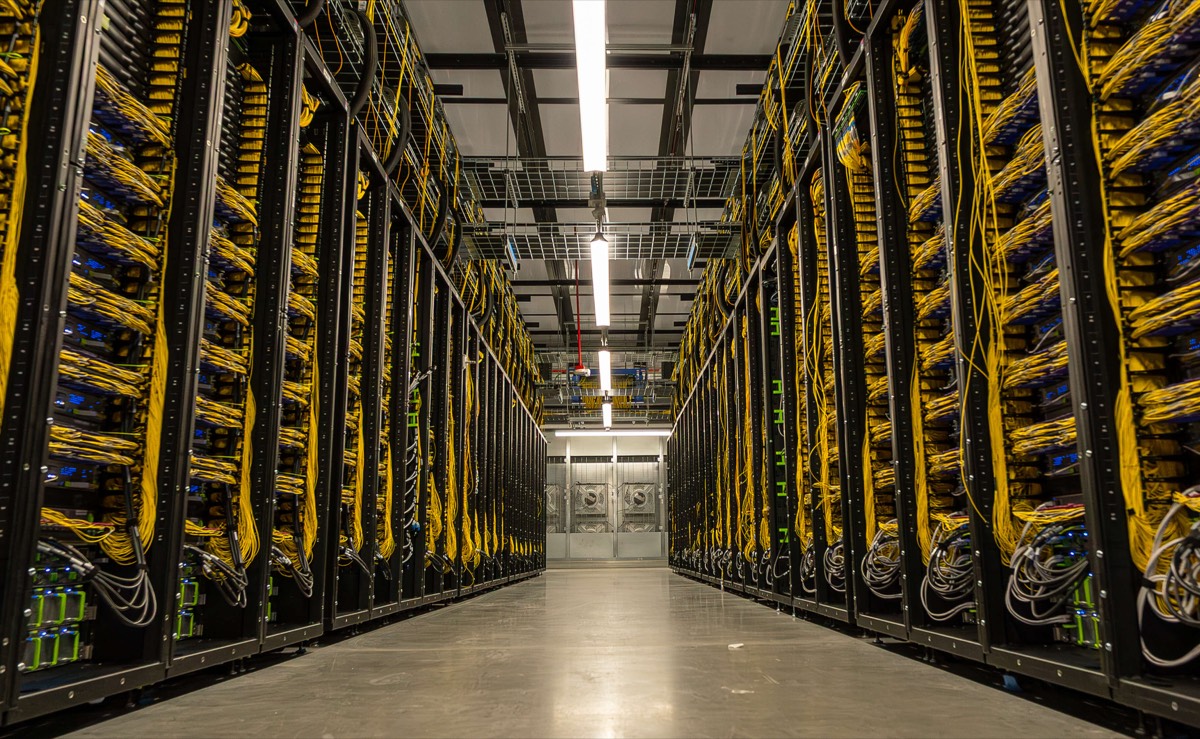
Prometheus 是 Meta 在俄亥俄州新奥尔巴尼(New Albany)建设的 AI 训练超集群。Meta 在 10 月 19 日的工程博文中称,它的一期已经完成,并用于训练 Muse 系列基础模型,包括 Muse Wonder;扩到约 100 万块 GPU 的目标尚未实现。同一篇博文还给出一组可靠性数字:Muse Wonder 训练中,预训练的 goodput 超过 85%,强化学习(RL)训练超过 90%。
要点
- Meta 称一期已完成并用于训练 Muse,但博文没有给出完成日期。集群目前有数十万块 GPU,分布在多栋互联的建筑里。
- 可靠性:Muse Wonder 训练中,预训练 goodput 超过 85%,RL 超过 90%;平均中断间隔(MTBI)约 4.7 万 GPU 小时,固件等改动落地后超过 5.4 万。
- 中断:2025 年中一期初期,中断峰值接近每 8K GPU 每天 1,000 次。Meta 称已从这一峰值降低 99%,北极星目标是每 8K GPU 每天 2 次。
背景
Prometheus 此前已有几份相关报道和博文。2026 年 1 月,据 CNBC 报道,Meta 与 Vistra、TerraPower 和 Oklo 签署核能协议,计划为 Prometheus 供电,当时预计它将于 2026 年内上线。2 月,Meta 的另一篇工程博文写道,Prometheus 建成后将提供 1 吉瓦的容量。这是建成后的目标,博文里没有对应的已实现功率数字。
10 月 12 日 Muse Wonder 发布时,Meta 称两款模型是在其吉瓦级 Prometheus 数据中心训练的。本站 10 月 13 日的 Muse Wonder 条目 已经写过这一归属,这里不再重复。谷歌与 Constellation 的核电购电协议也属于同一类电力安排。
事实部分
除标注来源的一行外,以下数字都来自 Meta 博文,属于 Meta 自报。表中「口径与限定」一列保留了博文的限定条件。
| 指标 | 数字 | 口径与限定 |
|---|---|---|
| 一期状态 | 已完成,用于训练 Muse 系列 | 未给完成日期 |
| 当前规模 | 数十万块 GPU,分布在多栋建筑 | 博文原文为 hundreds of thousands |
| 目标规模 | 约 100 万块 GPU | 目标,未给时间表 |
| 预训练 goodput | 超过 85% | Muse Wonder 训练 |
| RL 训练 goodput | 超过 90% | Muse Wonder 训练 |
| MTBI | 约 4.7 万 GPU 小时;固件等改动后超过 5.4 万 | 按 GPU 小时计,墙钟时间口径 |
| 中断峰值 | 2025 年中近 1,000 次 / 每 8K GPU / 天 | 一期初期 |
| 中断降幅 | 99%(Meta,10 月 19 日);约 50 倍(9 月讲话,GamesBeat 转述) | 99% 以 2025 年中峰值为基线、历时约一年;50 倍的报道未给基线,两者不合并 |
| 北极星目标 | 每 8K GPU 每天约 2 次中断,约 10 万 GPU 小时 MTBI | 目标值 |
博文对中断的定义很宽:任何迫使任务暂停并进入恢复流程的故障都算,包括 GPU 芯片缺陷、网络结构异常、存储瓶颈和热限制。博文把故障造成的拖慢或停机反映在 goodput 上。
硬件与电力的数字如下:
| 平台 | 机架形态 | 功率(博文数字) | 状态 |
|---|---|---|---|
| GB200 NVL72(Catalina,Ariel 变体) | 两机架一组,每机架 36 块 GPU | 约 120 kW(两机架合计) | 已部署 |
| GB300 NVL72(Clemente) | 单机架 72 块 GPU | 约 135 kW(单机架) | 已部署 |
| Vera Rubin NVL72(San Miguel) | 单机架 72 块 GPU | 超过 170 kW(单机架) | 博文称即将加入(原文 arriving soon) |
- 每个以太网后端网络结构最多连接 20,736 块 GPU。
- 从 NVL8 换到 NVL72 后,scale-up 域从 8 块 GPU 扩大到 72 块,故障影响半径因此扩大 9 倍。每个 NVL72 域用 64 块 GPU 跑训练,其余 8 块留作机架内备件。
- 同步训练时,集群负载可能出现 30% 到 40% 的突变。Meta 用 Dynamo Dimmer 在逼近电力上限时逐步下调 GPU 功率上限,而不是直接停掉任务。
各方说法
Prometheus 的可靠性数字大多只有 Meta 一方来源,外部报道主要用来核对时间线和口径。
- GamesBeat 9 月 23 日的报道转述了 Meta 基础设施负责人 Santosh Janardhan 在 AI Infra Summit 上的讲话。Janardhan 说 Meta 把中断降低了 50 倍,目标同样是每 8K GPU 每天约 2 次。同一篇报道写道,Prometheus 仍在建设中,同时服务训练任务、继续增加 GPU。
- 50 倍即降低 98%,与博文的 99% 接近。但 GamesBeat 的报道没有给出 50 倍的基线和时段;博文的 99% 则以 2025 年中的峰值为基线、历时约一年。两者不能直接比较,所以并列列出,不合并。
- 一期何时完成:9 月的报道仍把站点描述为在建,10 月 19 日的博文称一期已完成。博文没有给出日期,两者的先后我们无法判断。
- TechCrunch 10 月 12 日的报道称,Muse Wonder 是在一座今年早些时候投运的俄亥俄州中部数据中心训练的。这是记者的表述,博文没有给出投运日期。
- CNBC 1 月 9 日的报道称,Meta 预计 Prometheus 在 2026 年内上线。报道中的 6.6 吉瓦,是 Meta 与三家核能公司的项目到 2035 年预计新增的电力,并非 Prometheus 站点的功率。
- 截至本文写作,我们没有找到独立机构或工程师对这些可靠性数字的复核,也没有找到公开的反方意见。目前这些数字只有 Meta 一方的材料支撑。
编辑判断
对做大规模训练的团队来说,这篇博文的价值在于数字足够具体,可以拿来对照。有三点比单个数字更值得记:
- 机架内冗余压低了故障影响。每个机架用 64 块 GPU 跑训练,另留 8 块备件。单块 GPU 出故障时备件立即顶上,任务从最近的检查点恢复,机架留在任务中,不必等硬件维修。
- 修复靠批量下发。Meta 称,固件和驱动修复能在几小时内推送到超过 10 万块 GPU。
- 电力波动由几层共同承担:Dynamo Dimmer 调度功率上限,机架级电池模块处理瞬时尖峰,电容托盘负责削峰,设施级储能在更大范围内配合。
对多数应用开发者,这篇博文不会改变什么,它主要影响的是训练基础设施这一侧。读的时候有三点要留意:
- 中断的定义很宽。拿它和别家集群比较前,先确认对方是否用同样口径计数。
- 99% 是相对 2025 年中峰值的降幅,博文没有直接给出当前的绝对中断次数;50 倍的报道没有给出基线,两者都不能直接说明可靠性的绝对水平。
- 100 万块 GPU 是目标,一期完成也没有日期。博文没有给出站点当前的总功率;「吉瓦级」是 Meta 给项目的称呼,1 吉瓦是 2 月博文里建成后的目标。
接下来
- Prometheus 扩到约 100 万块 GPU 的时间表,Meta 没有给出。
- 博文称 Vera Rubin(San Miguel)即将加入,但没有给日期。
- Hyperion 是 Meta 在路易斯安那州 Richland Parish 的下一座超集群,博文称其设计借鉴了 Prometheus 的经验,同样没有时间表。
- 下一步可以看 Meta 会不会公布当前的绝对中断次数(博文只给了相对峰值的降幅),以及 50 倍一说的基线。