OpenAI、PerturbAI 与 Scripps 用 1,946 个 GPT-Rosalind 智能体并行重解小鼠全脑 CRISPR 图谱
OpenAI 等三方让 1,946 个 GPT-Rosalind 智能体各分析一个基因扰动,32 分钟重解小鼠全脑 CRISPR 图谱,报告全部公开。
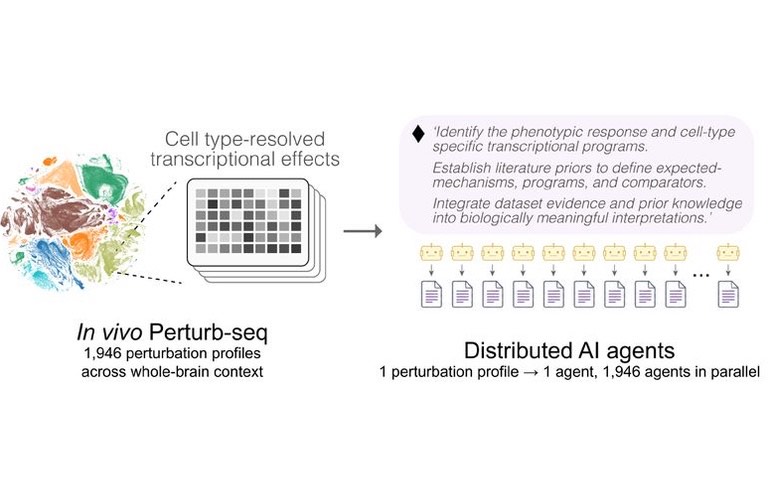
2026 年 10 月 21 日,OpenAI、PerturbAI 与 Scripps Research 公布了一项合作结果:把一份已公开的小鼠全脑 CRISPR 扰动图谱拆成 1,946 份,给每个基因扰动配一个 GPT-Rosalind 智能体,各自读数据、查文献、写机制假设,整轮并行跑完用 32 分钟,报告再合并成一张公开的「推理图谱」。三方把这种做法叫 distributed biological reasoning,中文可译作分布式生物推理。预印本 10 月 16 日先上线 bioRxiv(2026.10.15.759436,v1,CC-BY),代码以 MIT 许可放在 GitHub,图谱数据是 CC-BY-4.0。
要点
- 分工:1,946 个智能体各认领一个扰动,共享同一份 prompt、同一套工具和同一个代码环境;预印本记录整轮并行分析 32 分钟完成。
- 文献:全线记录 39,185 次论文阅读、16,445 条保留引用;在 893 个扰动的最大工作量上,单智能体对照只引了 11 篇,分布式保留了 711 倍的引用(预印本 Fig. 2E)。
- 复核:源论文 71 条结论中,智能体在看不到原稿的前提下匹配 35 条、改进 13 条、部分恢复 9 条;只看能由差异表达数据直接得出的 55 条,48 条匹配或改进(87.3%),含部分恢复共 52 条(94.5%)。
背景
被分析的图谱本身不是这次的新东西。Jin 实验室的 Shi et al. 用改良的 in vivo Perturb-seq 敲掉 1,947 个疾病相关基因、测了 770 多万个细胞,2026 年 3 月挂上 bioRxiv(2026.03.16.711480,页面显示 3 月 18 日发布)。Hugging Face 上的数据集分两个配置,datasets-server 显示 default 7,720,300 行、gene_metadata 19,070 行;仓库 350 个文件合计 204,953,167,236 字节,约 205 GB。
这类实验的产出是几万个「扰动 × 细胞类型」的响应。传统统计给出差异表达清单、模块和扰动相似度,要变成机制假设还得接上散在几十年文献里的知识。论文开头的说法是:做实验的能力在扩张,解读能力卡在人手上。GPT-Rosalind 是 OpenAI 2026 年 4 月 16 日发布的生命科学专用模型,9 月 11 日起脱离研究预览、走可信访问。这次用的是 GPT-Rosalind-5.5,论文写明其知识截止为 2025 年 12 月,早于源论文上线——「没看过答案」这个前提因此可查。
同一类主张今年已经出现过一次:本站 9 月 30 日记录过 Anthropic 约 950 个 Claude 智能体发现类 CRISPR 系统,那边的发现还在等实验验证;这一篇换了个方向,把已有的实验读得更透。
怎么分工
一个智能体只负责一个扰动。它拿到的是按细胞类型切好的差异表达谱、实验上下文,以及一份共享 prompt 和一个带分析工具与文献访问的代码环境。它可以自己翻数据、跨扰动比较、跑针对性分析。产出是结构化报告:发现、定量证据(例如 logFC)、生物学解释、参考文献、caveats、建议的后续实验。报告进一个可检索的库,同时挂进一张知识图谱,节点是扰动、发现、基因、通路、细胞类型和支撑证据。
单智能体对照的设计值得单独说。模型、prompt、reasoning 设置、工具、数据访问全部固定,只改一件事:一个智能体扛下全部 893 个扰动,还是每个扰动一个智能体。这条对照把「多智能体到底买到了什么」变成了可以量的东西:引用量、文献标注的分布,以及人类专家的偏好。
文献标注另有一层。下游一个智能体把每条发现标成四类:agree(有直接文献支持)、inferred(机制上有支持、但没有直接匹配的观察)、disagree(与文献推出的预期冲突)、no literature(没检索到先例)。1,519 条高置信发现里,420 条 agree(27.6%)、636 条 inferred(41.9%)、101 条 disagree(6.6%)、362 条没有先例(23.8%)。论文自己提醒,no literature 只表示检索没找到,不等于真没有相关研究。
事实部分
数字分三层:调度规模、复核成绩、预测能力。下表按预印本正文与图注整理,仓库里的原始 JSON 可以对上。
| 项目 | 数值 | 出处 |
|---|---|---|
| 智能体数 | 1,946 个,一个对应一个基因扰动 | 预印本正文、Fig. 1A |
| 并行运行时间 | 32 分钟 | 预印本正文、Fig. 2D |
| 论文阅读记录 | 39,185 次 | 正文;仓库 source_access_summary.json |
| 保留引用 | 16,445 条 | 同上 |
| 单智能体对照 | 893 个扰动时引用 11 篇,分布式为其 711 倍 | Fig. 2E |
| 源结论复核 | 71 条中 35 匹配、13 改进、9 部分恢复、14 未覆盖 | Fig. 1C |
| 可直接检验的 55 条 | 48 条匹配或改进(87.3%),含部分恢复共 52 条(94.5%) | 正文 |
| 盲评 | 30 位博士级专家评 60 份报告;另设 20 对配对比较,每对 3 人评,分布式被偏好 45/60(75%) | Fig. 4H–4K |
| held-out 预测 | 272 个留出扰动,balanced accuracy 0.705 | Fig. 3 |
| 神经元耗竭排序 | median recall@50 为 0.36;单智能体 0.18、DepMap 0.26、按 DEG 量 0.14 | Fig. 3K |
盲评的相关系数也公开:智能体自己的新颖性打分与人类均值 Spearman ρ=0.61,后续优先级 ρ=0.56,证据支持 ρ=0.49。那 20 对配对比较里单智能体被偏好 10 次(16.7%),5 次打平。
合成阶段还有几组数。跨扰动归纳规范化去重后得到 3,397 条关系型发现,优先级分数中位数 0.05、均值 0.46,注意力被压到少数候选上。把扰动身份随机打乱、表型谱保持不变之后,agree 比例从 29.3% 掉到 13.2%(同屏打乱)和 6.1%(换到屏外基因),no-literature 从 29.9% 升到 43.5% 和 61.0%;这个对照说明标注确实跟着扰动与表型的一致性走。通路摘要的写法更省:智能体每条通路中位数列 5 个基因,常规富集分析是 19 个,两者方向一致率 96.2%。
边界与口径
第一,「数月至一年」是估算,不是实测。Fig. 2D 图注原文是:「Human estimates assume $22/hour, 15 minutes to interpret one perturbation, and 10 minutes per paper read; this is not a measured human performance.」把它当成人类基线的成绩,会被原文直接否掉。
第二,三组引用数各算各的,很容易张冠李戴。R&D World 10 月 21 日的原文是分布式智能体「retained 7,586 references, approximately 711 times as many, according to the project’s public data」——「按项目公开数据」这半句是关键限定。预印本正文给的是全量口径:一轮跑完记录 39,185 次论文阅读、保留 16,445 条引用。7,586 是 893 个扰动那一档的对照切片:仓库 data/tables/scaling/replot_single_vs_multi_layered.csv 里 scale 为 893 的三行 multi 都记 7,586,三个 single 分别是 11、11、10。拿 data/runs/scaling/seed-017/n0893/targets.json 里的 893 个 target 去逐行筛 data/inputs/literature/source_access_per_report.csv,逐行相加正好得到 7,586 条 citation entries,其中 cited_sources 列为 7,528。这个列的计数单位是「报告-来源对」,不是去重后的来源数:仓库 source_access_summary.json 写明 counting_unit 为「report-source pair; duplicates across reports count separately」,2,046 行里有 72 行的 cited_sources 小于 citation_entries(例如 Arhgef9 是 6 对 7 条)。全部 2,046 行相加则是 16,555 与 16,445。7,586 ÷ 10.67(11、11、10 的均值)= 711.2,这就是「约 711 倍」的来处。也就是说,论文的 711 倍与 R&D World 的 7,586 互相吻合,只是它们和全量的 16,445 不是同一个数。顺带一提,7,586 这个字面值只印在仓库的 scaling 表里;预印本正文和图注都没有印出它,两个逐报告 CSV 里也搜不到这个字符串,它只能靠逐行求和得到——搜不到不代表没有出处。OpenAI 博客自己的说法是「超过 700 篇」。
第三,只验证了一张图谱。held-out 预测的 balanced accuracy 是 0.705,漏判和过度调用都有:Pomp、Thoc2、Pafah1b1 被预测分别产生 600、303、40 个差异表达基因,实测为 0,而这三个恰好属于耗竭最强的命中。作者的解释是被强影响的细胞没被采到,属于假设而非结论。
第四,最出圈的 DCTN1/胆固醇线索不能记在分布式架构账上。R&D World 明确写「单智能体基线也产出了让专家感兴趣的线索」,三位盲审给这条的后续优先级平均 4.3/5,两件事同时成立。
第五,作者构成与评审状态:6 位作者是 OpenAI 雇员、2 位是 PerturbAI 雇员,Grace X. Y. Zheng 与 Xin Jin 是 PerturbAI 联合创始人;预印本未经同行评审。
第六,扰动数是 1,946 而非 1,947:源图谱写的是 1,947 个疾病相关基因,这一轮跑了 1,946 个智能体,两个数不要混用。
各方说法
R&D World 的 Brian Buntz(10 月 21 日)把它定性为 proof of concept,并指出与人类分析师的比较「rests on the time estimate above」。他也把 DCTN1 那条线索的盲审分数单独拎出来:三位评审给的后续优先级平均 4.3/5,并认为它促成了「胆固醇运输受损可能触发神经元补偿性合成」这个可检验的问题。
Tom’s Guide 10 月 22 日的报道面向大众读者,自己加了一句免责:「AI has not discovered a cure for Alzheimer’s or Parkinson’s disease」,并强调这些是科学家仍需验证的早期线索。它没有给出 1,946 这个数字,全程写「数千个智能体」。
Hacker News 上的讨论截至 10 月 22 日核对时是 146 分、96 条评论,反对意见集中在「线索不缺」。用户 mdevere 说临床开发才是瓶颈,已有太多资金充足的 AI 制药公司手握大量候选靶点;pcrh 去 GeneCards 查了 DCTN1,指出它和帕金森样疾病的关联早有记录;Metacelsus 认为一个基因配一个智能体的做法效率存疑,「除非目标是烧掉几百万美元的 API 额度」。也有人把矛头对准新闻稿而非论文:anthuswilliams 写这是「我见过附着在科学论文上最懒、最说不通的新闻稿之一」,同时承认链接的论文「算不上变革性,但留下的印象比新闻稿好得多」。
同行评审这条线可以对照着看:本站 10 月 13 日写过 AlphaProof Nexus 的埃尔德什问题结果登上 Science,那是走完评审的版本;这一篇还是 v1 预印本。工程侧可以并读 Anthropic 的动态工作流,同样是「主控写编排、子智能体分头跑」,那边按程序分派,这边按数据分片。
编辑判断
值得抄的是形状,不是结论。把一张大规模扰动图谱按扰动切片、每个智能体只看自己那一格、共享同一套工具、输出结构化报告、最后做跨扰动归纳,这个模式能搬到任何「行是实验条件、列是测量」的数据集上。三个对照数字给了它可验证的骨架:引用量随工作量保持、盲评 75% 偏好、87.3% 的源结论复核率。这三件事的原料都在仓库里,谁都可以重算。
诚实的一面:这是对 2026 年 3 月已公开数据的再分析,实验不是这次做的;人类工时是估算;只测了一张图谱;预测在被敲除的细胞里会过度调用;最出圈的生物学线索单智能体也找到了。把这些放在一起看,它证明的是「解读可以并行化」,离「AI 做出生物学发现」还有一段距离,也完全没有涉及阿尔茨海默或帕金森的治疗。
对谁有用:手里压着单细胞或扰动筛选数据、又没有专职解读人力的实验室,可以先用 MCP 接口问几个已知答案的问题,看它答得怎么样;做 agent 编排的工程师可以直接读 distributed_agent 的 prompt 与报告 schema,那是这套方法里最难复制的部分。反过来说,数据只有几十个条件时,单智能体加人工复核更省事——这套架构的收益随扰动数量增长。
怎么试
最快是在线看。仓库 README 给的托管站点是临时地址 https://sites-publish-check-20261021.as-alexander-sun.chatgpt.site,不用装东西就能翻报告和知识图谱。
要把这份语料接进自己的助手,README 给的是两条 MCP 命令:
codex mcp add distributed-agents-shi \
  --url https://sites-publish-check-20261021.as-alexander-sun.chatgpt.site/api/shi-mcp
本地跑则要装好 pixi 与 Codex CLI,执行 pixi install -e minimal 和 codex login,然后:
pixi run -e minimal distributed_agents query \
  "What is the relationship between the proteasome subunits?" \
  --out-dir runs/starter
大数据走 Git LFS(git lfs pull)。原始图谱在 Hugging Face 的 perturbai/wholebrain_crispr_atlas,CC-BY-4.0,约 205 GB,按需下载比整仓拉取省事。托管服务不含原始数据文件,需要重算统计的问题只能在本地跑。