Sebastian Raschka 免费放出 11 小时「从零构建推理模型」视频课:8 集覆盖评测、测试时扩展、RLVR/GRPO 与蒸馏
Raschka 10 月 24 日把 8 集超 11 小时的推理模型从零构建课免费放上 YouTube,代码 Apache-2.0 开源。
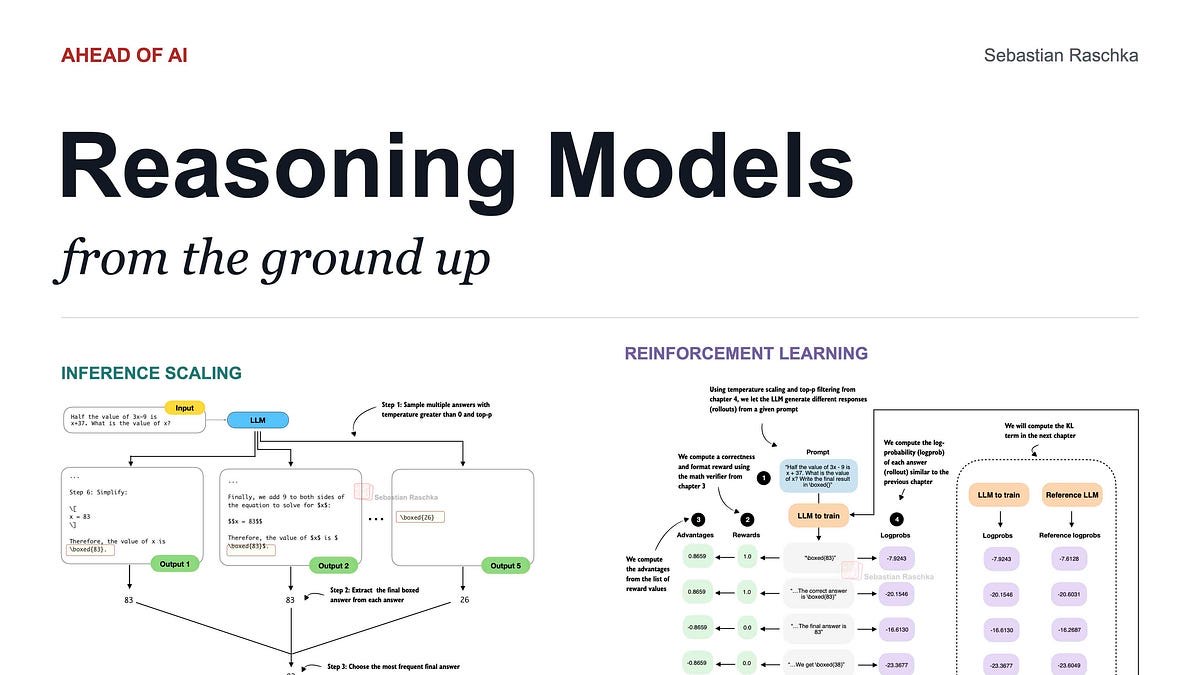
10 月 24 日,《从零构建推理模型》(Build a Reasoning Model (From Scratch))作者 Sebastian Raschka 在其 Substack「Ahead of AI」宣布:这门课的全部 8 集视频、共超过 11 小时的写码实录,已经免费放上 YouTube。Raschka 现为 LLM 研究工程师,此前曾任威斯康星大学麦迪逊分校统计学教授。课程从加载预训练的 Qwen3 0.6B 权重起步,一路手写出验证器、self-consistency、简化版 GRPO 强化学习,直到用 DeepSeek R1 教师数据做蒸馏;配套代码放在 GitHub 仓库 rasbt/reasoning-from-scratch,截至 2026-10-27 实测 5,639 stars、898 forks,Apache-2.0 许可。
要点
- 全免费:8 集视频全部公开在 YouTube,官方没设付费墙;付费的只有 Manning 的同名纸质与电子书,视频本身是书的延伸而非导购。
- 路线完整:从 Qwen3 0.6B 推理起步,依次实现 MATH-500 验证器、self-consistency 多数投票、简化版与进阶版 GRPO(含 clipping、KL 项、reward hacking),最后做 DeepSeek R1 蒸馏——这就是 DeepSeek R1、GPT-5 Thinking 这类推理模型的核心配方。
- 门槛不虚高:官方口径是 Python 与 PyTorch 熟练即可,前作《从零构建大语言模型》「推荐但不强制」;推理示例 CPU 能跑,训练环节官方明确建议上 GPU。
背景
Raschka 在机器学习教育这条线上不是新手:2015 年出第一本书,此后的《Build a Large Language Model (From Scratch)》是这一体裁里被引用最多的实现指南之一,仓库长期维持数万 stars。这次的推理课是它的续篇——上一本回答「一个基础 LLM 怎么被写出来」,这一本回答「推理能力是怎么加到模型上的」。把推理拆成可动手的步骤,此前主要靠 Andrej Karpathy 的视频:HN 评论里有人直接喊出「Karpathy 2.0」,也有人补了一句公道话——两人都在这条路上干了十年以上(Karpathy 的 CS231n 与 Raschka 的第一本书都出自 2015 年)。HN 帖子 10 月 26 日挂出,截至 2026-10-27 我们核对时拿到 518 分、77 条评论,正反两方都有可引用的具体论点。
事实部分
以下数字出自官方 Substack 宣布文、GitHub 仓库与 HN 页面,核对日期均为 2026-10-27。
| 集数 | 主题 | 对应章节 |
|---|---|---|
| 1 | 动机与环境搭建(uv、CUDA、Apple Silicon、远程 GPU 配 VS Code) | 第 1–2 章 |
| 2 | 加载 Qwen3 0.6B、分词、贪心解码、KV cache、torch.compile | 第 2 章 |
| 3 | 验证器:答案抽取、数学等价检查、MATH-500 评测 | 第 3 章 |
| 4 | 测试时扩展 I:温度与 top-p 采样、self-consistency 多数投票 | 第 4 章 |
| 5 | 测试时扩展 II:logits 打分、self-refinement 循环 | 第 5 章 |
| 6 | 简化版 GRPO/RLVR:相对优势、训练循环、RLHF 与 RLVR 对比 | 第 6 章 |
| 7 | 进阶 RL:clipping、KL 项、格式奖励、reward hacking 与检查点对比 | 第 7 章 |
| 8 | 蒸馏:soft/hard、on/off-policy、DeepSeek R1 教师数据 | 第 8 章 |
- 免费与付费的边界:视频免费,Manning 的书(ISBN 9781633434677,彩色印刷)是付费的深度延伸。官方称课程「镜像」了 DeepSeek R1、GPT-5 Thinking 等大规模推理模型的构建方法。
- 算力账:前几集推理在 CPU 上即可运行,Qwen3 0.6B 在近年的 MacBook 或一张游戏卡上就能跑;第 6–8 集的训练实验,官方明确建议配 GPU。
- 代码工程化程度:仓库带 Linux/macOS/Windows 三平台 CI,第 2–8 章各有主笔记本与练习解答(第 1 章无代码),另有附录 D(换更大模型)、附录 E(批处理与吞吐)、附录 F(常见 LLM 评测方法)。
各方说法
HN 帖子里的争论集中在「这类课程到底值不值」。批评方的代表是用户 hypfer:真要造模型的人看视频不够,不看视频的人买课买的只是「身份消费」(identity purchase);gradus_ad 把这类指南比作「十年前的自制 CPU 教程——有趣,但没有任何实用价值」。torben-friis 提出更普遍的两难:理论学浅了像「婴儿学步」,学深了是数学系;实践则需要家庭黑客拿不到的算力与数据。
辩护方的论据更贴着这门课的具体设计。libraryofbabel 引用书里「普通笔记本、无需特殊硬件」的原话,指出 Qwen3 0.6B 在近年 MacBook 或游戏卡上就能跑,并举《Crafting Interpreters》为例——这类书的价值在于看懂东西怎么造,不在于产出可用的产品;kadoban 补充后训练才是爱好者的可行路径,LoRA 微调「不需要改太多权重就能加上新能力」;fantispug 算了一笔账:40 亿参数以下的模型微调,一张消费级 GPU 就够。CamperBob2 用 Karpathy 的课做类比:跟完全程「你会得到一个 GPT-2.0 等价物」,玩具模型的意义是建立直觉,「一点也不徒劳」。
编辑判断
对想把「推理模型」从营销词变成自己能改的代码的工程师,这可能是目前成本最低的一条完整路径:免费、8 集、代码能跑、每一集都对着一个可以直接运行且可核对的基准或训练曲线。它和看论文的差别在于每一步都有梯度在流,和读书的差别在于有人陪你把代码写完。需要掂量的两点:一是产出物本身——一个 0.6B 参数的推理模型——在任何公开榜单上都不构成竞争力,价值在直觉与方法,不在权重——工业级开放权重推理模型的天花板在哪里,可对照我们此前对 Kimi K3.1 Pro 的报道;二是第 6 集之后的训练集数对硬件仍有实际要求,没有 GPU 的读者需要租卡或接受漫长的 CPU 训练,本地小机器能跑动什么,可参考 DGX Spark 本地模型实测。HN 上「身份消费」的批评并非全无道理:买课不等于学会。但这一门至少把「学」的门槛降到了零——截至发稿(2026-10-27),我们在 Google News 中文 RSS 与主要中文科技媒体均未检索到对这门课的报道,本文可能是该课程的首次中文介绍。