律师用 12 张二手 V100 跑满 DeepSeek-V4.1-Flash 的全部专家
12 张二手 V100 花约 9,450 美元跑 DeepSeek-V4.1-Flash:15,360 个专家全在显存,代码单流 153–184 tok/s。
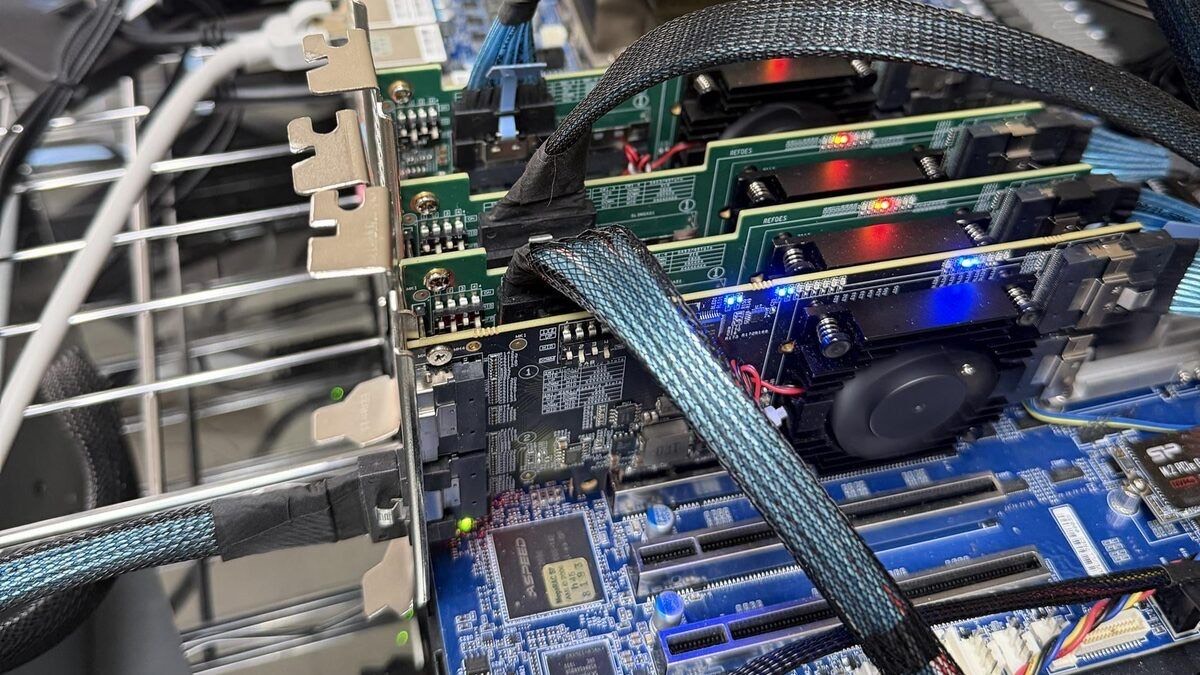
2026 年 11 月 19 日,律师 Nick Mermiges 在 GitHub 上发布了 12 卡构建的第四版记录:12 张 2018 年的 Tesla V100-SXM2 32GB 分成三个流水线阶段,把 DeepSeek-V4.1-Flash-1017 的 15,360 个路由专家全部以 NVIDIA 的 NVFP4 精度留在显存里,单条代码请求的解码速度 153–184 tok/s。12 张卡花了约 9,450 美元,按 11 月 21 日汇率约合 6.3 万元人民币。
要点
- 显存账算得平。 12 张卡每张 32,510 MiB,合计约 381 GiB;NVFP4 专家权重需要 278.9 GiB,占 73%,剩下约 100 GiB 留给 524,288 token 的上下文、KV 缓存和激活。8 张卡只有 254 GiB,这就是上一版装不下的原因。
- 速度是单请求的。 153–184 tok/s 指一条代码请求在 1K 到 256K 六个上下文长度上的解码速度;三条并发时合计 344–443 tok/s,作者自己写明「这不是批量解码引擎」。
- 全部专家常驻,一个都没再压。 12 个 worker 上 15,360 个专家全在显存,按阶段分 5,376 / 5,376 / 4,608 个,主机内存里 0 个;上一版只能把全部专家压到 2-bit,再把最常用的 5,949 个(38.7%)换回 NVFP4。
背景
DeepSeek-V4.1-Flash-1017 是 DeepSeek 在 10 月 17 日更新的一版开放权重模型,MIT 许可。按官方 config.json,它有 40 层、每层 384 个路由专家、每个 token 激活 6 个,最大位置 1,048,576,专家权重的量化格式就是 fp4。40 × 384 正好是 15,360,即这个构建反复提到的专家总数。我们此前记录过这版模型的基准变化。
这些专家是模型参数的大头。每个专家是三个 5120×2304 的矩阵,约 3,540 万参数;15,360 个合起来约 5,436 亿参数(算术)。它们如果放在主机内存,每层路由都要过一次 PCIe,解码速度会被总线拖死,所以这类 MoE 的本地部署争的从来不是算力,而是「专家能不能全塞进显存」。
这位作者不是第一次做这件事。10 月底以来,他先后公开了 8 卡的 Volta sPLIt、Volta Max uPLIft 和 Volta Full NVFP4 三个构建;1Cat-vLLM 上游的三阶段补丁(#1031)在 12 张卡上只跑到约 3 tok/s,是这次 150 tok/s 量级的起点。V100 本身也到了尾声:NVIDIA 的 R580 驱动分支是最后支持这一代卡的版本。
事实部分
速度表来自作者仓库 docs/measurements.md,测试窗口 b4a 与 14:09Z 的基准,2026 年 11 月 19 日。条件是贪心解码、关闭思考、输出 1,024 token、四个槽、单条请求,每个格子取两次重复的平均值:
| 上下文 | 代码 (tok/s) | 法律 (tok/s) | 一般文本 (tok/s) | 首字冷读(秒) | 预填(tok/s) |
|---|---|---|---|---|---|
| 1K | 183.8 | 101.5 | 86.1 | 0.65 | 1,567 |
| 8K | 175.5 | 92.9 | 89.6 | 2.51 | 3,267 |
| 32K | 175.8 | 92.5 | 94.7 | 7.32 | 4,478 |
| 64K | 157.4 | 93.4 | 83.3 | 13.95 | 4,697 |
| 128K | 157.4 | 93.1 | 85.6 | 28.07 | 4,670 |
| 256K | 153.4 | 92.4 | 84.5 | 58.03 | 4,518 |
256K 上下文的 58 秒首字,是这份数据里最值得记住的一个数:它比上一版 8 卡的 108.4 秒快了近一倍。文档已经读过一次之后再问,首字是 0.43 秒(128K)到 0.64 秒(256K)——前缀缓存命中与冷读差两个数量级。
| 项目 | 数值 |
|---|---|
| 显卡 | 12 × Tesla V100-SXM2 32GB(2018 年),32,510 MiB/张 |
| 显存合计 | 约 381 GiB(算术) |
| NVFP4 专家权重 | 278.9 GiB,15,360 个,主机内存 0 个 |
| 上下文 | 524,288 token/请求,4 个槽(4 个会话常驻) |
| 拓扑 | PP3 × TP4,层 0–13 / 14–27 / 28–39,板内 NVLink、板间 PCIe |
| 功耗上限 | 175 W/卡,12 张合计 2,100 W(算术) |
| 时钟上限 | 1,452 MHz(实际 1,447 MHz) |
| 采购价 | 约 9,450 美元,12 张卡折合每卡约 790 美元(算术) |
价格需要说清口径。9,450 美元是 12 张卡连同三块四卡载板的价钱,不是单卡价,也不是含主机的整机价:按 Tom’s Hardware 11 月 9 日的报道,作者最早的 8 卡版本两块载板各约 2,400 美元,当时单卡约 400 美元;Tom’s Hardware 在 11 月 9 日的报道里查到,二手 V100 SXM2 32GB 在 eBay 上已涨到约 900 美元一张,而且还在涨。主机、内存和电源是上一版就有的(Threadripper Pro 主板、8 条 32 GB DDR4、两只合计 2,800 W 的电源),从这份清单看,9,450 美元对应的是卡和载板。
功耗与噪音同样要标清。每张卡的功耗上限从 150 W 提到 175 W,时钟上限从 1,522 MHz 降到 1,452 MHz,作者称这一升一降带来了明显收益。12 × 175 W 正好是 2,100 W(算术),与 IT之家 报的功耗上限对得上,但这个数只算显卡,不含主机;该报道同时称噪音较大,不适合普通办公环境。作者试过把单卡推到 200 W 跑一天,四路长对话时主机跳过一次电。
为什么 V100 能跑 FP4
V100 没有 FP4 或 FP8 张量核心,只有 FP16 的 mma.sync.m8n8k4。作者的仓库把代价写得很直白:每一种 4-bit 格式都要先在软件里解包成 FP16 操作数,「低比特专家省下的是读取的字节数,不是算得更快」。Tom’s Hardware 由此解释了一个反直觉的结果——一张 2018 年的卡能跑 Blackwell 时代的格式,靠的是 900 GB/s 的显存带宽,而不是算力。
这个解释与时间分布对得上。作者用引擎自己的计时器和 profiler 拆过一次解码步骤:专家 29%、稠密矩阵乘 21%、drafter 10%、14% 在核外,其余是注意力和索引。一轮解码在短对话上是 26.25 ms,128,000 token 时 28.1 ms,249,000 token 时 31.0 ms;多出来的部分几乎全在稀疏注意力的索引上。
板间拓扑是另一处工程细节。三块板各四卡,板内走 NVLink,板间只能过 PCIe:前两块板共用一个 PEX88096 交换芯片,第一次交接留在交换机内部;第三块板在独立的 PLX 8749 后面,第二次交接要多穿一层主机桥,延迟更高。这也是为什么作者把 0–13 层、14–27 层、28–39 层这样切——让每个阶段的计算都留在自己那块板上。
各方说法
Tom’s Hardware 11 月 20 日的报道是这次最完整的一篇,补上了显存演进的过程:8 卡时全部专家 2-bit、5,949 个换成 NVFP4 直到塞满;12 卡才做到「一个都没再压」,作者称专家数值「与 DeepSeek 官方发布的一致」,但模型的其它部分仍用压缩形式。
IT之家 11 月 21 日的中文报道把数字搬得相当准,256K 首字 58.0 秒、预填 4,518 tok/s、128K 首字 28.1 秒都对得上仓库里的原始表格;但有一句译错了:「每个专家被压缩至约 15,360 个参数」。15,360 是路由专家的总数(384 × 40 层),不是单个专家的参数量。按公开 config 算,单个专家约 3,540 万参数。
作者自己的限定比转述更严。仓库里写着,这些数字只说明构建与全精度模型的接近程度,「不说明答案在具体工作里更好」,答案质量「尚未确立」。他还承认 Engram 表用的是 4-bit 版本(103.0 GiB,官方 188.8 GiB),这项没有做等价验证;批量解码、会话存储都还没上线。
「比任何已公开的 4 卡 DGX Spark 栈更快、价格是三台 Spark 的一半」是作者在 Reddit 帖子里的说法,没有第三方复现。按我们 10 月记录的 DGX Spark 售价(64GB 版 4,999 美元、128GB 版 6,950 美元),三台分别是 14,997 和 20,850 美元,「一半」只在 128GB 版本上大致成立。
编辑判断
这次构建的价值不在「旧卡也能跑」,而在它把一笔账算给了所有人看:一类必须常驻显存的 MoE,用 2018 年的卡、约 9,450 美元的硬件,在单用户、长文档的场景里能到 150 tok/s 以上。对数据不能出门的律所、诊所、小团队,这个组合比买三台 DGX Spark 更现实——前提是你愿意接手它背后的软件工程量。
门槛几乎全在软件。引擎是 1Cat-vLLM 的 SM70 分支,加 PLI Labs 自己的三阶段补丁、11 条环境变量、每张卡 31,998 MiB 的显存上限、PCIe ACS 重定向必须关掉、还有 164 到 197 秒的加载时间。作者公开了 kit、测量脚本和判别器,但没有一键安装;照着他的文档复现,仍然是一次需要耐心的移植。
代价也要照实说。它同时只服务一条请求,多用户并发时总吞吐 344–443 tok/s,而冷读会互相拖累:三条 128K 代码请求同时发出,首字分别是 77.4、90.5、90.5 秒,单独一条只要 28.1 秒。2,100 W 的显卡功耗和噪音决定了它只能待在机房或储藏室。R580 之后没有新驱动,这张卡的时间是借来的。4-bit 的 Engram 表让「专家与官方一致」这句话只对专家成立。
所以别把 184 tok/s 当成通用性能。它是单条代码请求、1K 上下文、贪心解码下的一个格子的值;同一段文本重复两次能差 2%,不同文本之间能差 ±9%。这是一个人、一台机器、一套公开测量方法的记录,不是基准测试,也没有第二个人复现过。
接下来
作者把批量解码列在下一步的第一位,原话是「Spark 有而我没有的那一样」;然后是让会话存储上线,让一个案子的文档能跨重启保留;再往后是 Engram 读取器的质量窗口。他还欠一件小事:跳电之后按记录重启的工具还绑在旧 kit 上。这些做完,12 张 V100 才算从「能跑」走到「能日常用」。