Claude Code 官方最佳实践:一条被忽视的约束,决定了其余所有建议
拆解 Claude Code 官方最佳实践:上下文是唯一硬约束,四阶段工作流、验证闭环、CLAUDE.md 减法与五种失败模式。
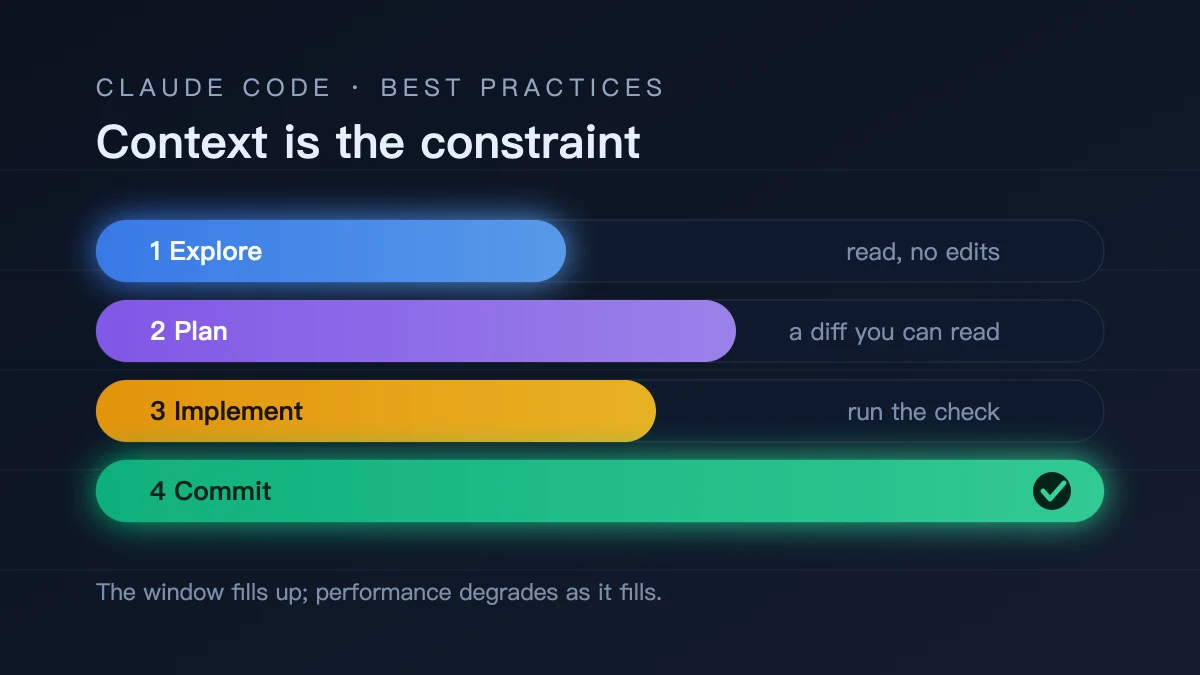
Anthropic 在 Claude Code 官方文档里挂着一份《Best practices for Claude Code》,篇幅不长,但开头就把整份指南的支点说清楚了:上下文窗口会快速填满,模型性能随填充下降。文档原话是「大多数最佳实践都基于同一个约束」——后面关于计划模式、子智能体、/clear、CLAUDE.md 的所有建议,都是这条约束的推论,而不是彼此独立的技巧清单。这也解释了为什么照抄别人的提示词往往没用:约束没变,但你的任务把窗口填满的速度不一样。
上下文才是唯一的硬约束
官方给的解释很直白:上下文窗口装的是整个会话——每条消息、Claude 读过的每个文件、每条命令输出。一次调试或一次代码库探索就可能吃掉数万 token。窗口越满,Claude 越容易「忘掉」前面的指令或开始出错。所以文档把上下文称为「最需要管理的资源」,而不是之一。
这个判断能解释一批看起来零散的做法。为什么要在不同任务之间 /clear?因为上一个任务的残留会持续占据窗口。为什么要用子智能体做调研?因为它们在自己的上下文里读文件,只把摘要带回主会话。为什么要给 CLAUDE.md 做减法?因为它每次会话都加载,冗余内容会挤掉真正的指令。理解这条主轴,比记住二十条技巧有用。
四阶段工作流
官方推荐的工作流是探索、计划、实现、提交,核心是把研究和执行分开。直接让 Claude 开写,最常见的失败是它解决了错误的问题。
具体做法是进计划模式(Shift+Tab 循环到状态栏显示 plan mode,或启动时加 --permission-mode plan),让它先读文件、回答问题而不做修改。读完之后要一份详细计划,Ctrl+G 可以把计划拉到编辑器里直接改。确认之后再切出计划模式,让它按计划实现并跑测试。最后让它提交并开 PR。
文档同时给了止损条件:计划模式有额外开销,改动范围清楚、一句话能描述完 diff 的任务(改个 typo、加一行日志、重命名变量)直接做就行。计划真正有用的场景是:不确定方案、改动跨多个文件、或者你对要改的代码不熟。
让 Claude 自己验证
文档把「给 Claude 一个能跑的检查」放在很靠前的位置,理由是一个闭环问题:Claude 在工作「看起来完成」时就会停。没有它能运行的检查,「看起来完成」就是唯一信号,于是你变成了验证回路——每个错误都要等你发现。给它一个能产出通过/失败的东西,回路就自己闭上了。
能当检查的东西很宽:测试套件、构建退出码、linter、跟 fixture 比对的脚本、跟设计稿比对的浏览器截图。官方还给了三种强度:写在同一条提示里让它自己迭代;用 /goal 设成跨会话条件,由独立的评估器每轮复查;或者用 Stop hook 做成确定性闸门,检查不过就不许结束这一轮。
这一条和前面 Office 里常见的「AI 写完就交付」形成对照。同一个模型,有没有检查,产出质量差一个量级;差别在于错误有没有被自动发现。
CLAUDE.md 要做减法
官方的立场比多数人预想的更激进:CLAUDE.md 的每一行都该问一句「删掉这行 Claude 会不会犯错」,不会就删。原文甚至说,臃肿的 CLAUDE.md 会让 Claude 忽略你真正的指令。
文档给了一张该写与不该写的对照:该写的是 Claude 猜不到的 Bash 命令、与默认不同的代码风格、测试方式和偏好的测试运行器、分支与 PR 约定、项目特有的架构决策、必填环境变量、不显然的坑。不该写的是读代码就能知道的东西、标准语言惯例、详细 API 文档(给链接就行)、经常变的信息、逐文件描述、以及「写干净代码」这类自明的要求。
还有一条诊断规则很实用:如果 Claude 一直做你不想要的事,而你已经写了规则,那多半是文件太长、规则被淹没了;如果 Claude 问的是 CLAUDE.md 里已经回答过的问题,那是措辞有歧义。把它当代码对待——出问题时审一遍,定期修剪,改完看行为有没有真的变。要强调某一行,只给那一行加 IMPORTANT;如果到处都强调,就没有一行突出。
会话是可以回退的
文档反复强调会话是持久且可逆的,这改变了试错的经济账。Esc 可以中途打断并保留上下文;连按两次 Esc 或 /rewind 打开回退菜单,可以恢复对话、恢复代码,或从某条消息开始重新总结;/clear 用于切换不相关的任务;/compact 可以带指令压缩,比如 /compact Focus on the API changes。
一条硬性经验值得单独记:同一个问题纠正超过两次,就该 /clear 重开。官方判断是此时上下文里已经塞满了失败的尝试,一个干净会话配一条更好的提示词,几乎总是胜过一条堆满纠错的長会话。
回退到检查点有个明确边界:它只跟踪 Claude 通过文件编辑工具做的改动,Bash 命令或外部进程改的东西不会被记录,所以它不能替代 git。
五种失败模式
文档末尾列了五种常见错误,每一种都配了一行修法,基本可以当检查表用。
大杂烩会话:一个任务没做完就插进另一个不相关的问题,上下文塞满无关信息。修法是在不相关任务之间 /clear。
反复纠正:改不对就再改,上下文被失败方案污染。修法是纠正两次之后清空重开。
过度膨胀的 CLAUDE.md:规则太多导致重要规则被淹没。修法是狠心删。如果 Claude 本来就做对,删掉那条或改成 hook。
信任但不验证:产出看起来合理,却没处理边界情况。修法是永远提供验证手段,验不了就别交付。
无限探索:让它「调研一下」而不限定范围,它会读几百个文件把窗口填满。修法是缩窄范围或用子智能体。
值得照抄的几条原文
文档里有些表述比转述更有力。关于验证:「这是你盯着看的会话与你走开的会话之间的差别」。关于评审:让一个全新上下文的子智能体只看 diff 和你的验收标准,它看不到产出改动的那套推理,所以能独立判断。但文档也提醒,被要求找问题的评审者通常总能找出问题,追着每一条改会导致过度工程——要明确告诉它只报影响正确性或既定需求的缺口。
关于并行,官方给了几种方案,按你自己愿意承担多少协调成本来选:worktree 里跑独立 CLI 会话、跨会话消息、桌面端多会话、云端、claude agents(研究预览)、agent teams(实验性、默认关闭)。还有一个 Writer/Reviewer 模式:一个会话实现,另一个用新鲜上下文评审,因为新上下文不会被自己刚写的代码带偏。
关于自主运行,claude -p 可以非交互执行,配 --output-format json 或 stream-json 给脚本解析。批量迁移用 /batch 拆给 5 到 30 个子智能体,或在脚本里循环 claude -p 并配 --allowedTools。无人值守时 --permission-mode auto 会让一个分类器模型在命令执行前审查,拦下权限升级、未知基础设施和恶意内容驱动的操作。
别把指南当教条
文档最后一节的标题是「培养你的直觉」,内容反而在拆自己的台:这些模式不是铁律,某些情况就该让上下文积累(深陷一个复杂问题时历史很有价值),某些探索性任务就该跳过计划,某些模糊提示恰恰是对的(你想先看 Claude 怎么理解问题)。
它给的方法是观察:产出的好东西时,记住你做了什么——提示词结构、给了什么上下文、当时在哪个模式;卡住时问为什么,是上下文太吵、提示词太模糊,还是任务对单轮来说太大。这套东西写不进文档,只能自己积累。
怎么用这份指南
如果你的 Claude Code 用得别扭,建议按这个顺序排查,而不是从头背技巧。
先看上下文:会话说得越久越糊,就是该 /clear 或改用子智能体了。再看验证:如果每件事都得你手动确认,就是缺一个能跑的检查。然后看 CLAUDE.md:如果写了规则还是不听,先怀疑文件太长。最后看任务粒度:如果它老解决错问题,说明该先走计划模式。
这份文档没有讲模型能力,也没有承诺效果数字。它讲的是在同一套模型上,怎么把窗口、验证和会话管理摆对——这大概是官方文档里最不花哨、也最经得起用的一部分。想接着看同类内容,站内拆过 Opus 5.5 的官方提示词指南,那份讲的是档位与删指令,和这份讲上下文管理正好互补;CLAUDE.md 与 AGENTS.md 的关系则补上了配置文件这一层。