VoiceStudio:把 ElevenLabs 搬回本机的开源语音工作台
VoiceStudio 是 ElevenLabs 的本机开源替代:克隆、配音、转写不联网,17 套 TTS、9 套转写引擎,MCP 供 Agent 调用。
项目资料
GitHub Ecosystem- 许可证
- AGPL-3.0
- 主语言
- Python
- 星标
- 53,811
- 核查时间
- 2026-10-06
以上快照资料以核查当日为准,可能随版本或运营策略变化。
给视频配音、做有声书,云端语音工具顺手是真顺手,可按字符计费、音频要上传、API 有额度,量一大就难受。开源项目 VoiceStudio 把这套工作台整个搬回本机:声音克隆、虚拟音色设计、视频配音、全局听写、批量转写、有声书制作,全部装进一个 Electron 应用,核心处理在本机完成,音频和音色档案默认留在你的硬盘上。它的底座是一个引擎矩阵——17 套语音合成引擎、9 套转写引擎随装随切,默认引擎是 k2-fsa/OmniVoice,全部引擎合计覆盖 646 种语言变体。公众号「AI开源求索」10 月 6 日推荐了它:仓库今年 4 月开源,查于 2026-10-06 已有 53,811 星、3,827 次提交,最新版 v0.5.6。
核心功能
VoiceStudio 把语音能力拆成几个工作区,每个都对齐一条真实生产线。
- 零样本克隆:3–10 秒干净单人参考音频就能克隆音色,官方引擎指南写明这是支持区间,超过 20 秒的素材会被
clone_ref_too_long直接拒绝;克隆好的音色存进本地档案库,可导出.ovsvoice音色包换机迁移。 - 文字造声:用自然语言描述性别、年龄、口音、语速、情绪,直接生成一个不存在的声音,批量配角配音不用再找真人样本。
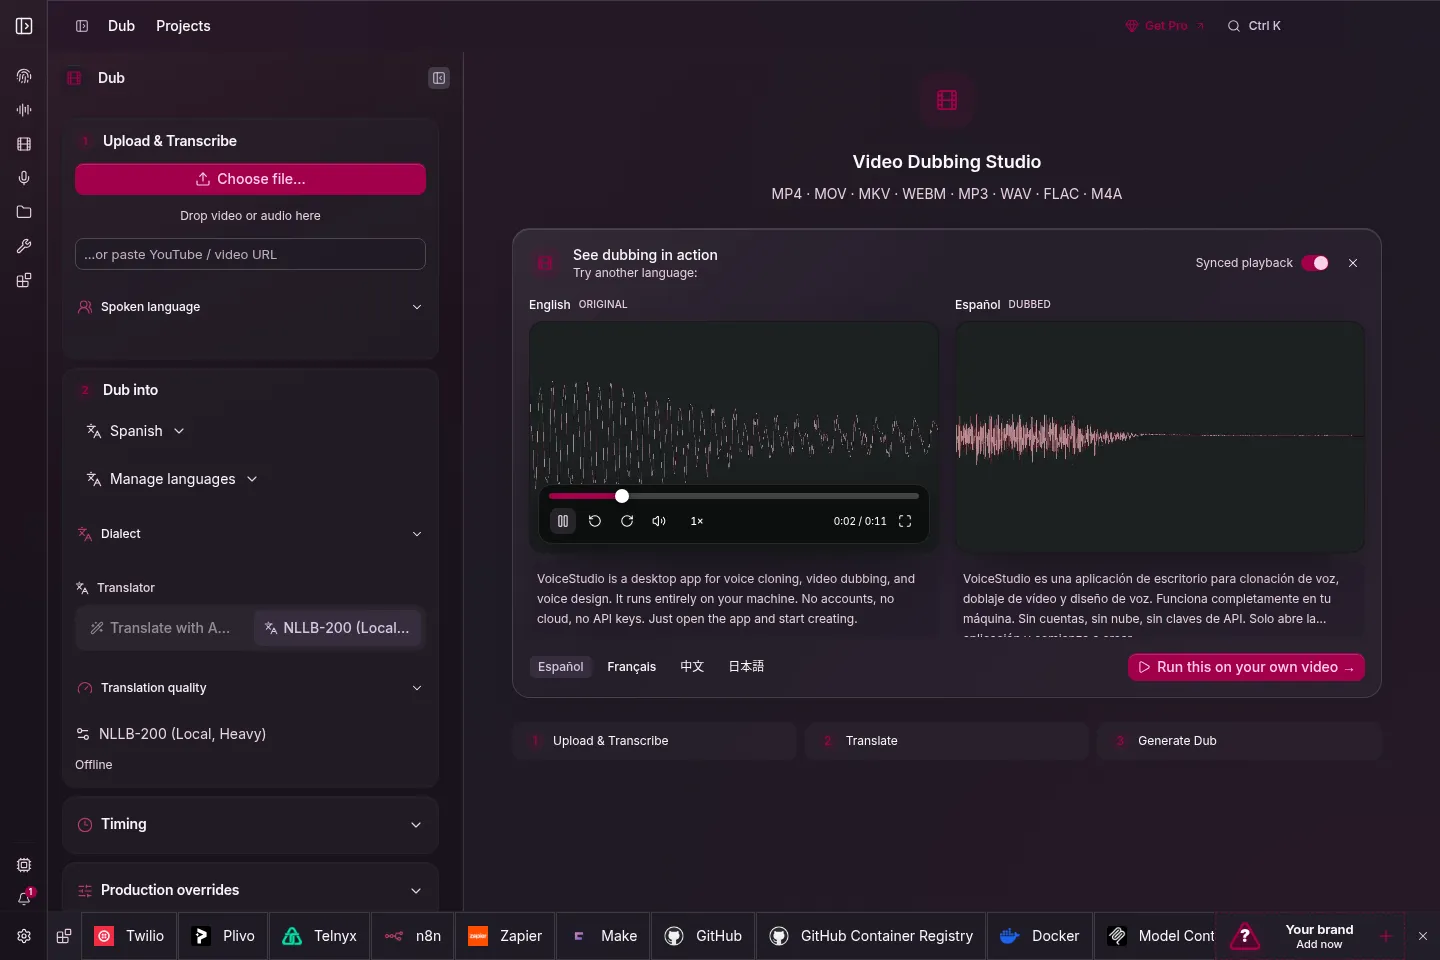
- 视频配音流水线:导入视频或链接后自动走完转写、说话人分离、翻译、按角色分配克隆音色、合成的全链路,保留原片背景音只替换人声,支持批量队列。
- 听写与转写:系统级悬浮听写,全局快捷键说完即转、直接粘进光标处;音频视频文件批量转写,输出带时间戳的文稿;另有人声分离和说话人分离。
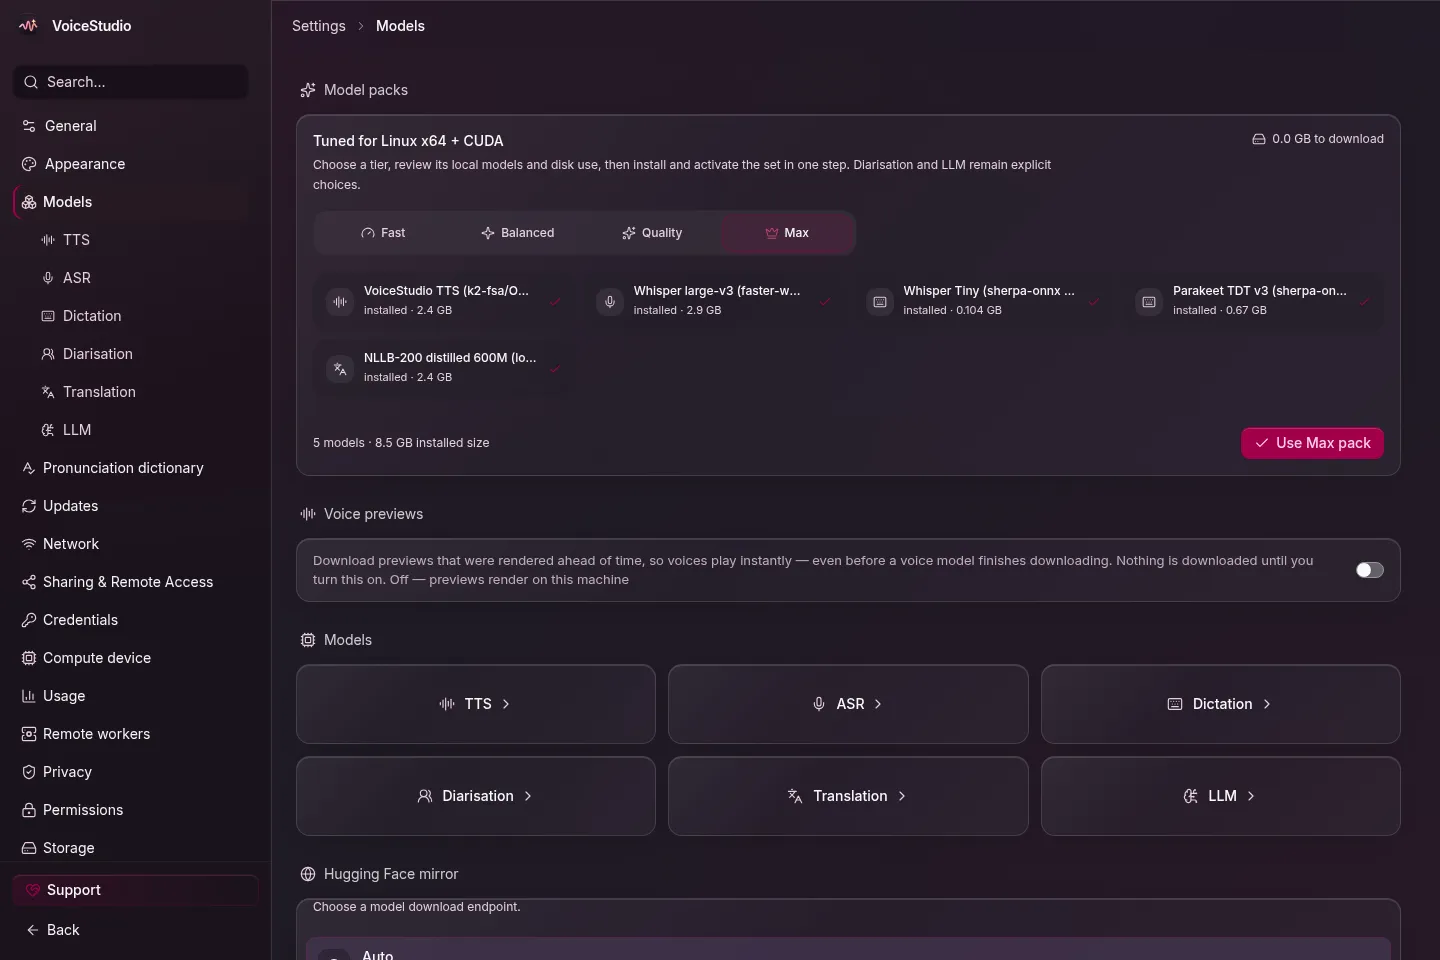
- 引擎矩阵:17 套 TTS、9 套转写引擎在模型面板里按需安装卸载,NVIDIA CUDA 和 Apple M 系列 MPS 加速,纯 CPU 也能跑(精简版 PyTorch 约 5 GB 磁盘)。
- 给 Agent 的接口:本地服务开在 3900 端口,提供 OpenAI 兼容转写端点、WebSocket 流式接口,MCP 有 HTTP 和 stdio 两种接入,Claude Code、Codex、Pi 都能直接调用本机语音工具。
典型使用场景
- 课程与视频批量配音:讲师把整季课程的旁白排队合成,或者给已有视频换一种语言的配音,一次跑完。
- 有声书与故事:导入 EPUB、PDF 长文自动分章节,剧本模式逐行给角色分配音色,导出带章节标记的 m4b;只想要电子书转音频这一步,可以看更轻的 ebook2audiobook。
- 出不了门的音频:采访素材、客户录音这类不便上云的文件,转写和克隆全程不出本机。
快速上手
macOS 和 Linux 一条命令安装:
curl -fsSL https://voicestudio.sh/install | sh
Windows 在 PowerShell 里跑 irm https://voicestudio.sh/install | iex,或者从 Releases 下载 .dmg、.exe、.AppImage、.deb 安装包。装完打开 Voice cloning 工作区,用内置演示音色或传一段 3–10 秒参考音频,输入文本点 Synthesize audio 就能听到第一段成品。把安装交给 Agent 也行:把官方安装指南链接粘给 Claude Code 或 Cursor,或者跑 npx skills add debpalash/VoiceStudio。Intel Mac 只能跑 UI 连远程后端;还在用老 Tauri 版的用户要按迁移文档另装 Electron 版。
小结
VoiceStudio 适合配音量大、在意隐私或不想续费云端的创作者和 Agent 开发者;只想开个网页输入文字就出音频、或硬盘放不下模型文件的人,它就太重了。许可要看两层:应用本体是 AGPL-3.0,改完拿去对外提供网络服务必须开源修改;默认 OmniVoice 引擎的预训练权重是 CC-BY-NC,禁止商用,商用前逐个核对你所用引擎的模型许可。还有一条底线:克隆别人的声音,先拿到本人同意。项目 2026-04-09 创建,最新版 v0.5.6 发布于 9 月 23 日,累计 3,827 次提交、最近一次推送就在昨天,迭代很勤。想要更轻的本地语音工作台,可以看 yovoice——同样本地优先的配音创作工具。