VoxCPM2:清华团队 2B 参数开源 TTS,30 语种语音克隆与设计,48kHz 录音棚音质
清华 NLP 实验室(OpenBMB)开源 TTS:2B 参数、30 语种、声音设计与可控克隆、48kHz 输出,RTF 低至 0.3,Apache-2.0。
项目资料
GitHub Ecosystem- 许可证
- Apache-2.0
- 主语言
- Python
- 星标
- 41,134
- 核查时间
- 2026-11-07
以上快照资料以核查当日为准,可能随版本或运营策略变化。
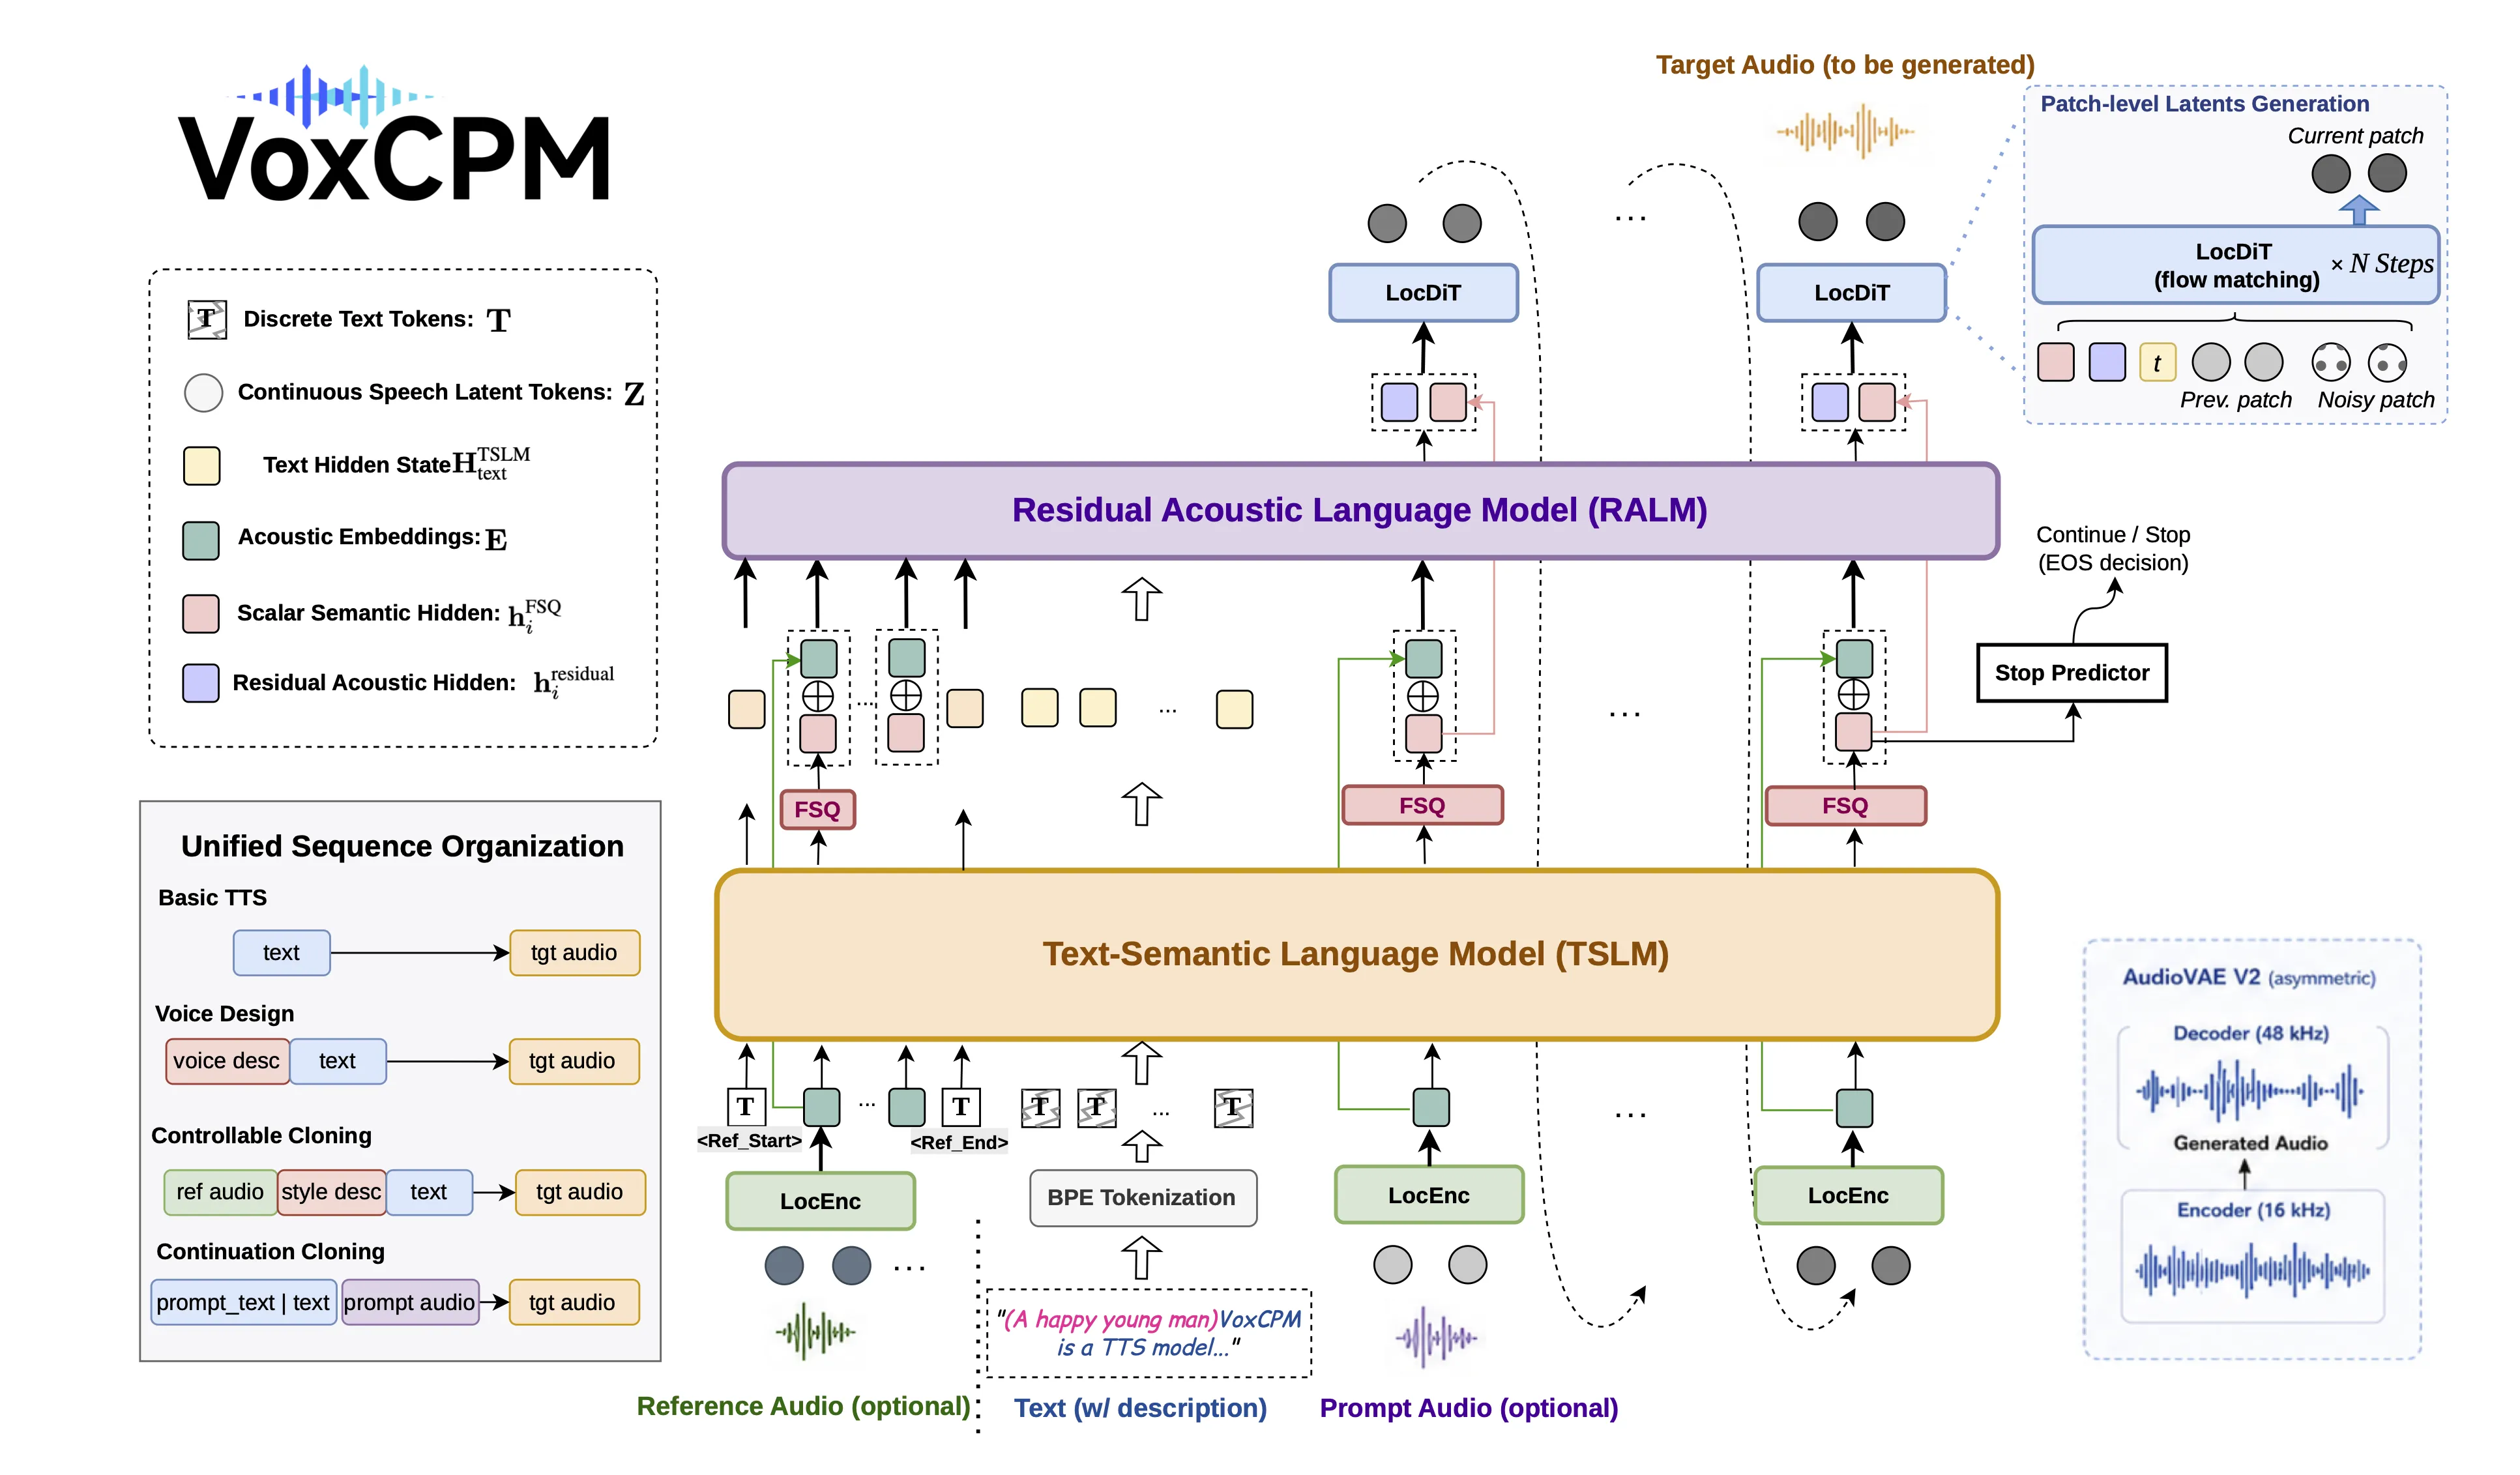
清华 NLP 实验室(OpenBMB)的 VoxCPM 系列从 0.5B 版本起就两度登顶 GitHub/HuggingFace Trending,2026 年 4 月发布的 VoxCPM2 是当前旗舰:2B 参数、超过 200 万小时多语种语料训练、30 种语言,新增语音设计(Voice Design)与可控克隆,输出 48kHz 录音棚音质(Apache-2.0,截至 2026-11-07 仓库 41,134 星;arXiv 技术报告 2606.06928)。部署注意:官方推荐至少 24GB 显存才能流畅运行——WhatsApp 笔记提醒得对,普通办公电脑带不动,需要推理卡或云 GPU。
核心功能
- Tokenizer-Free 架构:免分词器设计直接建模连续语音,基于 MiniCPM-4 底座——这也是「用文字描述就能生成音色」得以实用的技术前提。
- 30 语种 + 声音设计 + 可控克隆:除常规 TTS 外,可描述想要的声音特征生成音色,或按参考音频做可控克隆。
- 48kHz 录音棚音质:输出规格直接对齐专业音频工作流,做后期不再有升采样损失。
- 实时流式:RTX 4090 上 RTF 低至约 0.3,配合 Nano-vLLM 或 vLLM-Omni 加速至约 0.13;vLLM omni-modal 官方服务化方案带 PagedAttention 与 OpenAI 兼容 API。
- 微调友好:VoxCPM1.5 起开源 SFT 与 LoRA 微调脚本,把自家语料灌进基座即可定制音色库,不必从零训练。
典型使用场景
- 有声内容量产:多语种有声书、播客、新闻播报的本地化批量生产。
- 声音资产定制:为品牌或角色设计专属音色,克隆可控。
- 实时语音对话:流式输出可接实时对话管线,RTF<1 即可支撑;RTX 4090 上约 0.3 的 RTF 意味着 3 倍速实时合成还有余量。
快速上手
Python 3.10+ 环境 pip install 后从 HuggingFace 拉权重(openbmb/VoxCPM2);RTX 4090 级显卡可跑流式推理,低配走云 GPU;HuggingFace Spaces 有在线 Playground 可先试效果。项目沿革值得一看:0.5B 版本(2025-09)与 1.5 版本(2025-12)两度登顶 GitHub/HuggingFace Trending,VoxCPM2 在此基础上把语言数翻到 30、加声音设计与克隆并升级到 48kHz,权重、文档站、Playground 与 arXiv 技术报告全链齐备。
小结
VoxCPM2 适合有 GPU 资源、要本地化部署高质量多语种 TTS 的团队;24GB 显存门槛把普通办公电脑挡在门外——低显存需求请看社区变体(如 4GB 显卡跑土耳其语音色的二次封装,代价是限定语种)。要点与边界:Apache-2.0、Python、2B 参数;声音克隆的使用责任在调用方——克隆他人声音需获得授权。本站写过的 VoxWeft(Apple Silicon 同传)走的是端侧低延迟路线,VoxCPM2 走的是服务器级高保真路线——按部署条件选。