DeepSeek-V4.1-Flash-20261017 登顶 Code Arena WebDev 开源榜首:价格约为被超越者十分之一
Code Arena WebDev 榜单:DeepSeek 新快照以 1670 分居开源第一,Arena 称价格约为被超越的 Kimi K3 十分之一。
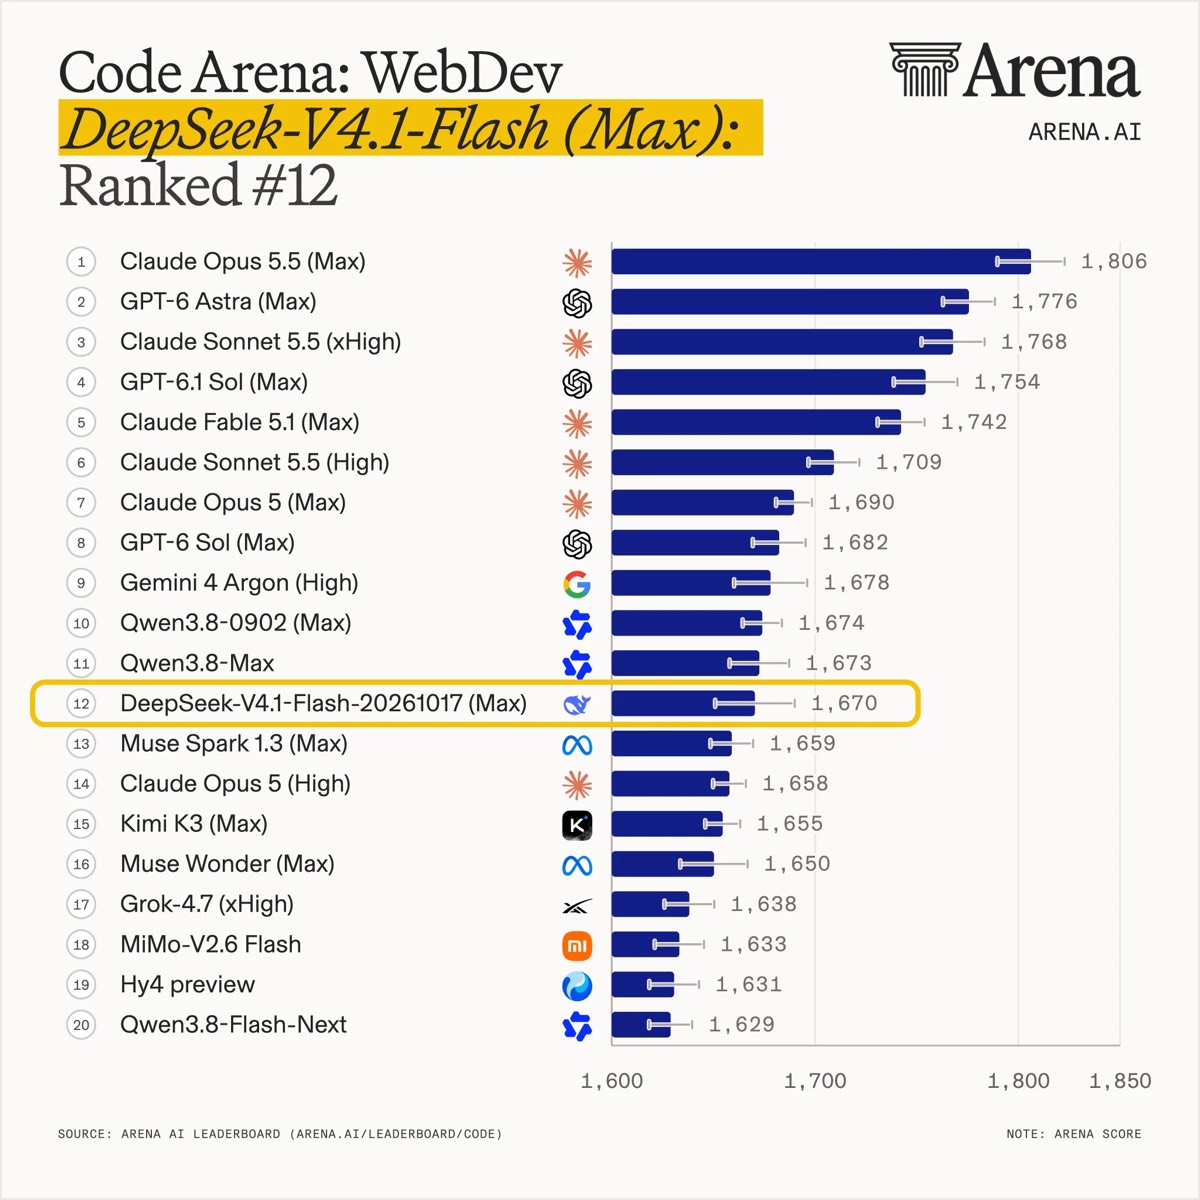
据 Arena 官方 X 帖(2026 年 10 月 18 日 18:56),DeepSeek 的 DeepSeek-V4.1-Flash-20261017 以 1670 分登顶 Code Arena WebDev 榜单的开源模型第一,总榜排第 12,超过排第 14 的 Claude Opus 5 (High),距第 8 的 GPT-6 Sol (Max) 约 10 分。Code Arena WebDev 是运营 LMArena 的公司 Arena 旗下按真实前端编码对局计分的榜单;这是这条产品线两天内的第二个事件:10 月 17 日 DeepSeek 在 Hugging Face 上架 1017 模型卡(见我们此前的报道),10 月 18 日榜单名次与价格信息把它推到开源编码模型的头名位置。
要点
Code Arena WebDev 榜单给出的新座次是开源模型第一、总榜第 12、1670 分。
- 据 Arena 官方 X 帖,DeepSeek-V4.1-Flash-20261017 以 1670 分列开源模型第一、总榜第 12;被其超越的前开源第一 Kimi K3 (Max) 在榜图为第 15、1655 分。
- 同帖给出价格 $0.3/$1.2 每百万 token(输入/输出),并称这约为 Kimi K3 (Max) 的十分之一,比上一版 V4.1-Flash-20260910 高 52 分。
- 有一处口径需要说清:榜图中 Qwen3.8-0902 (Max)(1,674 分)与 Qwen3.8-Max(1,673 分)排在 DeepSeek 之上;Arena 称前者为开源第一,未说明这两个条目的权重口径。
背景
这次登顶的对象 Kimi K3,和被比较的两个模型,都带着自己的时间线。Kimi K3 是月之暗面的旗舰,9 月底上线;10 月 12 日发布的 Arena 智能体榜(数据截至 10 月 8 日)上,DeepSeek V4.1 Flash 以 3.80% 的净提升分排第 17,Kimi K3 以 3.78% 居第 18,两者几乎并排(见我们此前的报道);到了 WebDev 榜单,两者又同处开源头部,这次是 DeepSeek 把 Kimi 从开源头名上挤了下来。
DeepSeek 这边,两天前的 10 月 17 日,V4.1 Flash 1017 模型卡在 Hugging Face 创建,列出 11 项高于旧版的基准成绩,标注 MIT 许可、7630 亿参数、约 510.3 GB 权重文件。本条榜单事件的主体 DeepSeek-V4.1-Flash-20261017 是同一条产品线的新快照:X 帖称其比上一版 20260910 高 52 分;Crypto Briefing 转述的三项基准(DeepSWE v1.1 77.0、Terminal-Bench 4.0 42.3、Automation-Bench 60.5)与 1017 卡的数字一致。无法直接确认 20261017 与 1017 是否同一仓库:X 帖所指的 20261017 模型卡受门控(访问返回 401),本站只能读 1017 卡,数字对上不等于仓库相同。
运营榜单的 Arena 本身也在变化。它 10 月 8 日完成 2 亿美元 B 轮融资、估值 31 亿美元(见我们此前的报道),榜单从文本盲测投票扩展到真实任务实测,Code Arena 是其编码产品线。
Code Arena WebDev 榜单
按 Arena 官方 X 帖与所附榜图,相关名次如下(数据为 X 帖发布时点的 Arena 计分;arena.ai 榜单页在写作时无法直接打开,以下名次以官方帖为准):
| 排名 | 模型 | Arena 分 |
|---|---|---|
| 8 | GPT-6 Sol (Max) | 1,682 |
| 10 | Qwen3.8-0902 (Max) | 1,674 |
| 11 | Qwen3.8-Max | 1,673 |
| 12 | DeepSeek-V4.1-Flash-20261017 | 1,670 |
| 13 | Muse Spark 1.3 (Max) | 1,659 |
| 14 | Claude Opus 5 (High) | 1,658 |
| 15 | Kimi K3 (Max) | 1,655 |
| 16 | Muse Wonder (Max) | 1,650 |
X 帖文本给出的事实:1670 分、开源第一、总榜第 12、超过 Claude Opus 5 (High)、距 GPT-6 Sol (Max) 约 10 分、$0.3/$1.2 每百万 token、约十分之一于 Kimi K3 (Max) 的价格、比上一版高 52 分;官方评价这个组合是「shifting the performance-cost Pareto frontier for open models in coding workflows」(改变了开源模型编码工作流的性能-成本帕累托前沿)。榜图补充了逐行分数与置信区间。
价格信息目前只有 X 帖一个来源:每百万 token 输入 0.3 美元、输出 1.2 美元,Arena 称约 10 倍低于 Kimi K3 (Max)。注意这是榜单发布方标注的模型单价,实际编码 Agent 的一次任务花费还取决于 token 用量、工具调用和重试;10 月 12 日智能体榜的单任务成本口径下,DeepSeek V4.1 Flash 为 0.13 美元、Kimi K3 为 0.94 美元,价差约 7 倍——同一对模型在两个口径下倍数不同。
各方说法
Arena 作为榜单运营方给出的口径:开源第一、第 12 名、10 倍价差,并恭喜 DeepSeek「为开源生态又一次有力贡献」。这个口径值得核对的部分是「开源」的定义——榜图里有两个 Qwen 条目分数更高。一个可能的解释是 Qwen3.8-0902 (Max) 与 Qwen3.8-Max 的 (Max) 档不开放权重或未列在开源组,但 Arena 帖与榜图都没有给出分组标准,本站无法验证。
独立媒体角度目前主要是 Crypto Briefing 10 月 18 日的报道(作者 Diego Almada Lopez),其榜单数字与 X 帖完全一致,并转述了 DeepSeek 模型卡的架构细节:MoE 架构、552B 骨干加 196B「Engram」参数、prefill 激活 8B、解码激活 16B、1M token 上下文。需要指出两点:一是该文分别列出 552B 与 196B 两个数(相加为 748B,文章未给合计),与站内 10 月 17 日从可读的 1017 模型卡读到的 763B 对不上,两处口径均注明出处、不做取舍;二是 Crypto Briefing 是从加密媒体转型的 AI 报道,单一署名,把它当作数字互证的第二个来源而非权威定论。
中文媒体与社区批评角度,本站以 X 帖摘要级信息和两轮中英文检索交叉确认,暂未检索到独立复核或质疑这条名次的报道;X 帖下的讨论以称赞为主(如「flash 档做到这样很了不起」)。这意味着 1670 分这个数字目前没有第三方复测。
编辑判断
对在低价位跑编码 Agent 的团队,这条榜单信息的价值不在「DeepSeek 赢了」,而在选型边界移动了:一个每百万 token $0.3/$1.2 的模型,在真实前端编码对局里排进总榜第 12、压过 Claude Opus 5 (High)。10 月 12 日发布的智能体榜上,DeepSeek V4.1 Flash 与榜首的差距还是 4 倍(15.53% 对 3.80% 的净提升分);不到一周后,同一公司的另一个榜单把它放到开源第一。对预算敏感、任务以 Web 前端为主的团队,值得用自己的任务集跑一轮对照。
要保留的怀疑有三层。其一,Code Arena 的分数来自用户自愿提交的对局,任务分布和提交人群有偏,滚动更新,这个 1670 分是快照不是证书;本站 10 月 12 日发布的智能体榜报道里(数据截至 10 月 8 日),DeepSeek 还排第 17。其二,「开源第一」的说法撞上两个更高分的 Qwen 条目,分组标准未公开。其三,价格与 10 倍价差目前是 Arena 单方标注,DeepSeek 官方定价页与 Kimi K3 的现价本站本轮未能直接核对(arena.ai 与 X 帖所指新模型卡均访问失败)。想试的话:DeepSeek 网页版与 API 在 10 月 17 日已更新到这条产品线(IT之家 10 月 17 日报道口径),用一段自己熟悉的前端任务跑一次,成本在 1 美元以内——这也是这条榜单信息的落点。