Menlo 年度报告:美国企业开源模型支出 89% 流向中国模型
Menlo Ventures 年度报告:美国企业开源模型支出 89% 流向中国模型,Kimi 占 61%, Llama 仅 7%,样本近 400 名美企决策者。
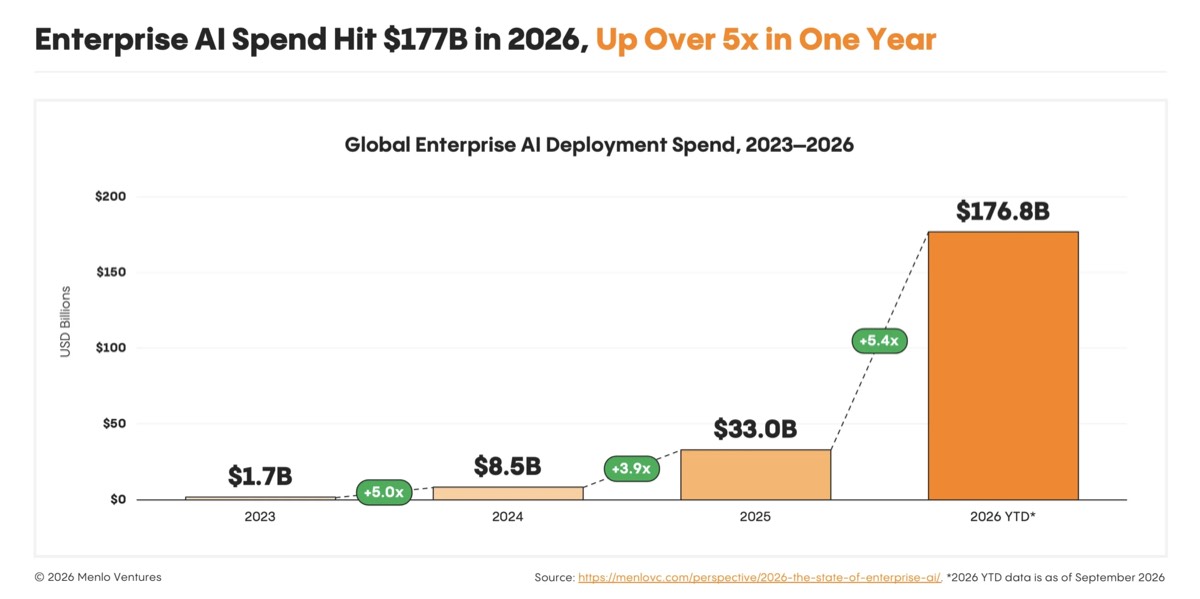
Menlo Ventures 11 月 3 日发布年度报告《2026: The State of Enterprise AI》,其中最能反映选型风向的一个数字是:美国企业的开源模型支出中,89% 流向中国模型——Kimi 占 61%,DeepSeek 占 15%,GLM 占 11%,Meta 的 Llama 只有 7%。数字来自 Morning Consult 在 2026 年 9 月 8 日至 26 日对近 400 名美国企业 AI 决策者的调查,这些受访者掌管的 AI 支出合计超过 40 亿美元;同一份报告还把全球企业 AI 部署支出记到 1,768 亿美元(报告图注口径),是一年前的 5.4 倍。
要点
- 据报告原文(2026-11-03 发布,11-08 核对):「Chinese models grew to 89% of open-source spend, led by Kimi (61%), DeepSeek (15%), GLM (11%), and Qwen (3%)」;西方阵营最高的 Llama 只占 7%。
- 调查由 Morning Consult 执行(2026-09-08 至 09-26),样本为近 400 名美国企业决策者,AI 支出合计超 40 亿美元;口径是美国企业,中文转述标题里的「全球」与原文不符。
- 另一口径方向一致:OpenRouter 称中国模型 6 月初起 token 份额超过美国模型;10 月 26 日当周 DeepSeek 以 29.8% 的请求份额居其平台之首。
背景
先把口径说清。这份报告的调查对象是美国企业的决策者,报告原文写的是「nearly 400 U.S. enterprise decision-makers」,由 Morning Consult 在 9 月 8 日至 26 日完成访问。IT之家 11 月 8 日的转述标题把口径放大成「全球」,正文注明源头是《南华早报》前一天的报道,但没有给出样本量和调查日期——要核对这些数字,报告原文页仍是唯一出处。
调查窗口也有讲究:9 月 26 日收尾,意味着 11 月初这批新权重带来的变化都不在这份数据里。月之暗面 11 月 4 日开放 Kimi K3.1 Pro 权重,Unsloth 10 月 30 日放出 DeepSeek-V4.1-Flash 量化版让 64GB 内存的机器也能跑,西方阵营里 Mistral 10 月 29 日开放 Large 4 权重。更早的 7 月,Kimi K3 发布当天 TechCrunch 以「Kimi: Threat or menace?」为题记录了华尔街的反应:纳斯达克当日跌约 1%,OpenAI 一位高管称 Kimi 是「a very good model」,其性能「不能简单归结为蒸馏」。开放权重模型从跑分选手变成企业账单上的常客,是这一年逐步完成的事。
事实部分
报告页原文给出的美国企业开源模型支出份额如下(2026-11-08 抓取):
| 模型 | 开源模型支出份额 |
|---|---|
| Kimi(月之暗面) | 61% |
| DeepSeek | 15% |
| GLM(智谱) | 11% |
| Llama(Meta) | 7% |
| Qwen(阿里) | 3% |
大盘数字同样出自报告页:全球企业 AI 部署支出到 2026 年 9 月达 1,768 亿美元(2023 年 17 亿、2024 年 85 亿、2025 年 330 亿),同比扩张 5.4 倍;其中「建设侧」支出 1,025 亿美元,增长 5.3 倍。报告作者(Tim Tully、Joff Redfern、Deedy Das 等)还给出一个效率估算:每 1 美元流向部署侧的 AI 支出,对应约 1.70 美元的部署侧 AI 收入。
支出份额不是调用量份额,两个口径要分开读。OpenRouter 6 月 30 日的博客分析写道,2025 年美国模型占 token 量的约四分之三,而 2026 年「中国模型 6 月初在 token 份额上超过了美国模型」;DeepSeek 从 1 月的 9% 升至 6 月初的近 20%,自 5 月中旬起是其平台上用量最大的模型。最新一期公开排名(10 月 26 日当周)里,DeepSeek 以 29.8% 的请求份额居首,OpenAI 18.8%、Google 14.4%、智谱 11.9%、Anthropic 5.7%,Meta 的 Llama 只剩 1.5%。两个口径指向同一方向,排序却不相同——支出榜上 Kimi 一家过半,调用量榜上 DeepSeek 才是第一。低价模型的 token 花不掉多少钱,出现这种分歧是正常的。
各方说法
OpenRouter 把 2025 年概括为「美国 token 之年」,并把 2026 年 6 月初的交叉点当作今年的分水岭,这份数据来自其平台 450 万亿 token 的真实用量。从业者侧,Hacker News 的一则帖子估计,经美国推理厂商托管的 GLM、Kimi 等开放权重模型「应付日常工作没问题」,成本「有时便宜 5 到 7 倍」。Meta 没有出现在报告页的引述里,报告对 Llama 的全部评价就是「西方开源模型中最受欢迎」一句——7% 对 89% 的落差,页面没有展开归因。
中文传播路径上,IT之家的转述把口径写成「全球」,这一偏差已经扩散到多个转载站点。另外要提醒:本文写作时有传言称 OpenRouter 数据显示「中国模型 token 量连续 27 周超过美国模型」,我们在 OpenRouter 的报告页、博客和公开排名里都核对不到这个「27 周」,可核对的表述是 6 月初的交叉点和当前周榜,本文只用后者。
编辑判断
这份数据改变的不是模型能力榜,而是「企业愿意把预算交给谁」这个问题的答案。对在美国市场做选型的工程团队,开放权重模型已经从「要不要试」变成「为什么不」;对开源阵营里的西方厂商,7% 的支出份额已经低到需要给出解释。同时要诚实地说:61% 是支出口径下已发生的选择,不等于未来最优解——调用量口径上 DeepSeek 领先,而 token 价格与前沿闭源模型差出量级(OpenRouter 博客举的例子:V4 Flash 每百万 token 输入 0.09 美元,GPT-5.5 是 5 美元)。报告页没有解释 Qwen 为什么只有 3%,也没有给 Llama 下滑的时间线;样本近 400 家、集中在 9 月,全年图景要等下一版。想自己核对的读者,报告页就一页,图表齐全,值得直接读。