微软发布自研推理芯片 Maia 300,2027 年起多吉瓦级部署
微软 10 月 12 日发布自研推理芯片 Maia 300:官方称每兆瓦 token 产出比主流 GPU 系统高 40%,2027 年投产、多吉瓦级部署。
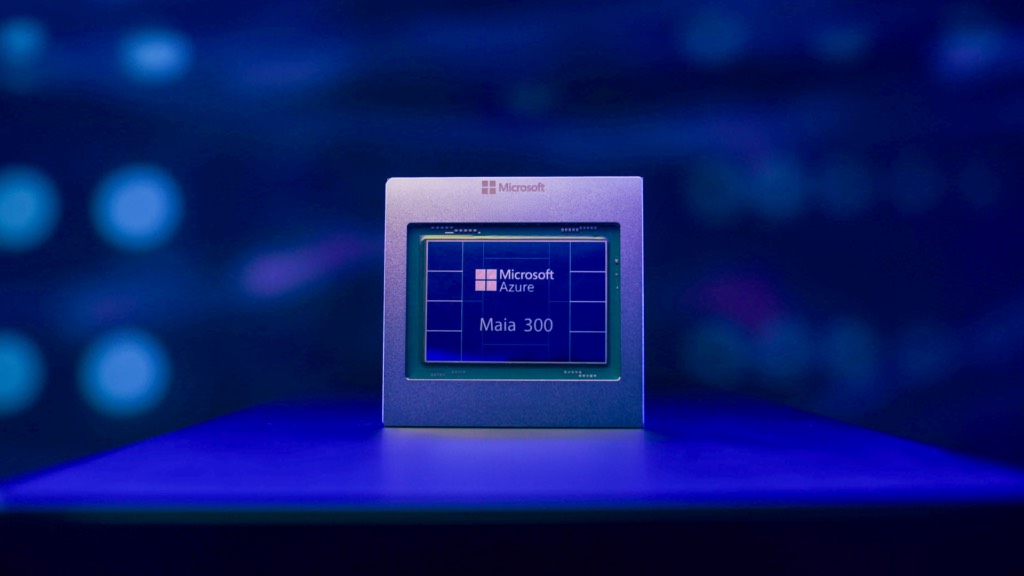
微软 10 月 12 日发布第三代自研 AI 加速器 Maia 300,一款专为推理设计的芯片:官方博客给出的预期是「每兆瓦 token 产出比主流 GPU 系统高 40%」,同时宣布从 2027 年起把 Azure Maia 家族扩展到多吉瓦级部署——按微软云与 AI 事业部执行副总裁 Scott Guthrie 的说法,Maia 将成为「微软产品与服务的首要推理系统」。上一代 Maia 200 如今已在美国、欧洲和澳大利亚的数据中心运行。
要点
- 微软 2026-10-12 官宣 Maia 300,2027 年投产;官方称其每兆瓦 token 产出比主流 GPU 系统高 40%,96 卡满配机架的 token 吞吐最高达 Maia 200 的 7 倍。
- 单卡 8 栈 HBM4 共 288 GB、峰值带宽 18 TB/s、TDP 950 W;机架级 96 卡、167 kW,聚合 27.6 TB HBM 与 1.7 PB/s 带宽;最大 superpod 12,288 卡(128 机架)。
- 更多细节将在 Microsoft Ignite 2026(旧金山)公布;所有性能数字均为官方预期,尚无第三方实测。
背景
Maia 300 是微软自研芯片产品线的第三代,不是一步到位的产物。上一代 Maia 200 于 2026 年 1 月发布(据 The Verge),目前已在生产环境承接 Microsoft Copilot 的推理负载,微软称 GitHub Copilot 与 Microsoft Foundry 也会在年底前用上它;Guthrie 称 Maia 200 是「我们机群里表现最好的 AI 基础设施」。这条产品线的进度并非没有波折:Reuters 2025 年 6 月曾援引 The Information 报道,新一代 Maia 芯片的量产从 2025 年推迟到 2026 年。把推理负载搬上自研或定制硅片的也不止微软一家——DeepSeek 此前为华为昇腾开源了全套算子组件(见本站报道),头部玩家正在把推理成本押注在自己能控制的芯片上。
事实部分
Maia 300 的一手规格来自 Azure 官方架构深潜文,署名是 Azure 硬件系统与基础设施总裁 Rani Borkar 与系统规划与架构企业副总裁 Saurabh Dighe。以下数字全部是厂商口径——芯片 2027 年才投产,第三方基准目前不存在。
| 项目 | 官方数字 | 对比 Maia 200 |
|---|---|---|
| 计算芯粒工艺 | 台积电 N2P | — |
| 单卡显存 | 288 GB(8 栈 HBM4) | 容量 +33% |
| 单卡显存带宽 | 18 TB/s | 约 2.5 倍 |
| 单卡 TDP | 950 W | — |
| 机架配置 | 96 卡 / 167 kW | 卡数翻倍 |
| 机架聚合 | 27.6 TB HBM、1.7 PB/s 带宽 | — |
| 最大 superpod | 12,288 卡(128 机架) | — |
| scale-up 对等带宽 | 最高 750 GB/s | +14% |
| 液冷 | 带走机架 80% 以上热量 | — |
| 计算与能效 | — | FLOPs +36%,每瓦性能超 2.5 倍 |
架构上有几处值得留意的设计。Maia 300 把芯片拆成计算、内存控制与 I/O 三类芯粒,计算芯粒用台积电 N2P 工艺,官方称选这个节点是为了每瓦性能;内存改为 NUMA 布局,把数据放在靠近使用它的计算单元旁边。数据格式上,微软强化了 MXFP4 并引入低于 3 bit 的存储格式,配合硬件加速的类型转换,官方称这是为了在同样显存里装下更长的上下文。机架内是 24 个四卡托盘、50 V 母线供电,液冷直接负责加速器、调压模块和交换芯片的散热。网络设计的变化更大:scale-up 与 scale-out 共用同一张以太网 fabric,跨机架通信不经过主机、也不需要独立的 scale-out 网卡,单个 superpod 最多 12,288 颗加速器,作业打包方式决定跨机架流量的比例。
部署计划同样具体:微软计划让 MAI 团队用它做模型开发、GitHub 的编码与智能体负载、Foundry 的模型服务以及医疗场景的 Dragon Copilot。模型生态方面,官方博客写明:在这些负载上,目前由 Maia 200 运行 OpenAI 模型、微软自研 MAI 系列与主流开源模型。
各方说法
The Verge 把 Maia 300 放进「降低对 Nvidia 与 AMD 依赖」的框架里解读,并提示这颗芯片关系到微软 AI 团队追赶 Google DeepMind、OpenAI 与 Anthropic 的目标。该文引用 Microsoft AI CEO Mustafa Suleyman 的表态:「我们需要一个自己拥有的、与我们的模型协同设计的平台。」
HN 上的讨论规模不大(抓取时 4 条评论、24 分),但观点有代表性。有人替微软算账:不用支付 Nvidia 的利润率,「拿到手的成本可能便宜 2 到 3 倍」。也有评论指向微软与 OpenAI 的关系:坐拥 OpenAI IP 授权,却没有拿出一颗让人惊艳的自研芯片。技术讨论则集中在设计取舍上,多位评论者认可从 UMA 转向 NUMA——跨机器扩展本来就绕不开非一致访存,把它下沉到芯片层是顺势的选择。
编辑判断
对在 Azure 上跑推理的团队来说,Maia 300 的直接影响要到 2027 年才兑现,眼下更值得读懂的是「首要推理系统」这个定位:微软第一次把自研芯片摆在 Azure 成本结构的核心位置,此后的模型定价与容量规划都会绕着它走。对这颗芯片本身,保留意见也要说清楚:40% 与 7 倍都是官方预期而非实测——7 倍对比的是自家上一代 Maia 200,40% 的参照则是「主流 GPU 系统」,两者都缺乏第三方基准,也没有价格;这条产品线的量产时间表此前推迟过一次。类似的推理效率竞赛本站写过另一头——Inferact 用 16 块 TPU v7 跑 Kimi K3,比 GB200 快 57%——芯片选型正在从生态惯性问题变成成本问题。下一个可核实的节点是 Ignite 2026,官方承诺届时公布更多细节。
接下来
- Microsoft Ignite 2026(旧金山):官方承诺公布 Maia 300 更多细节。
- 2026 年底前:GitHub Copilot 与 Microsoft Foundry 切换到 Maia 200。
- 2027 年:Maia 300 投产、多吉瓦级部署启动,届时才有可验证的实测数字。