阿里发布 Qwen4-Max:2.4 万亿参数,官方称单任务平均费用降 58%
阿里发布 Qwen4-Max:2.4 万亿主干参数、71B 激活、百万上下文与原生视觉;官方称单任务平均费用较上代降 58%,API 已上线。
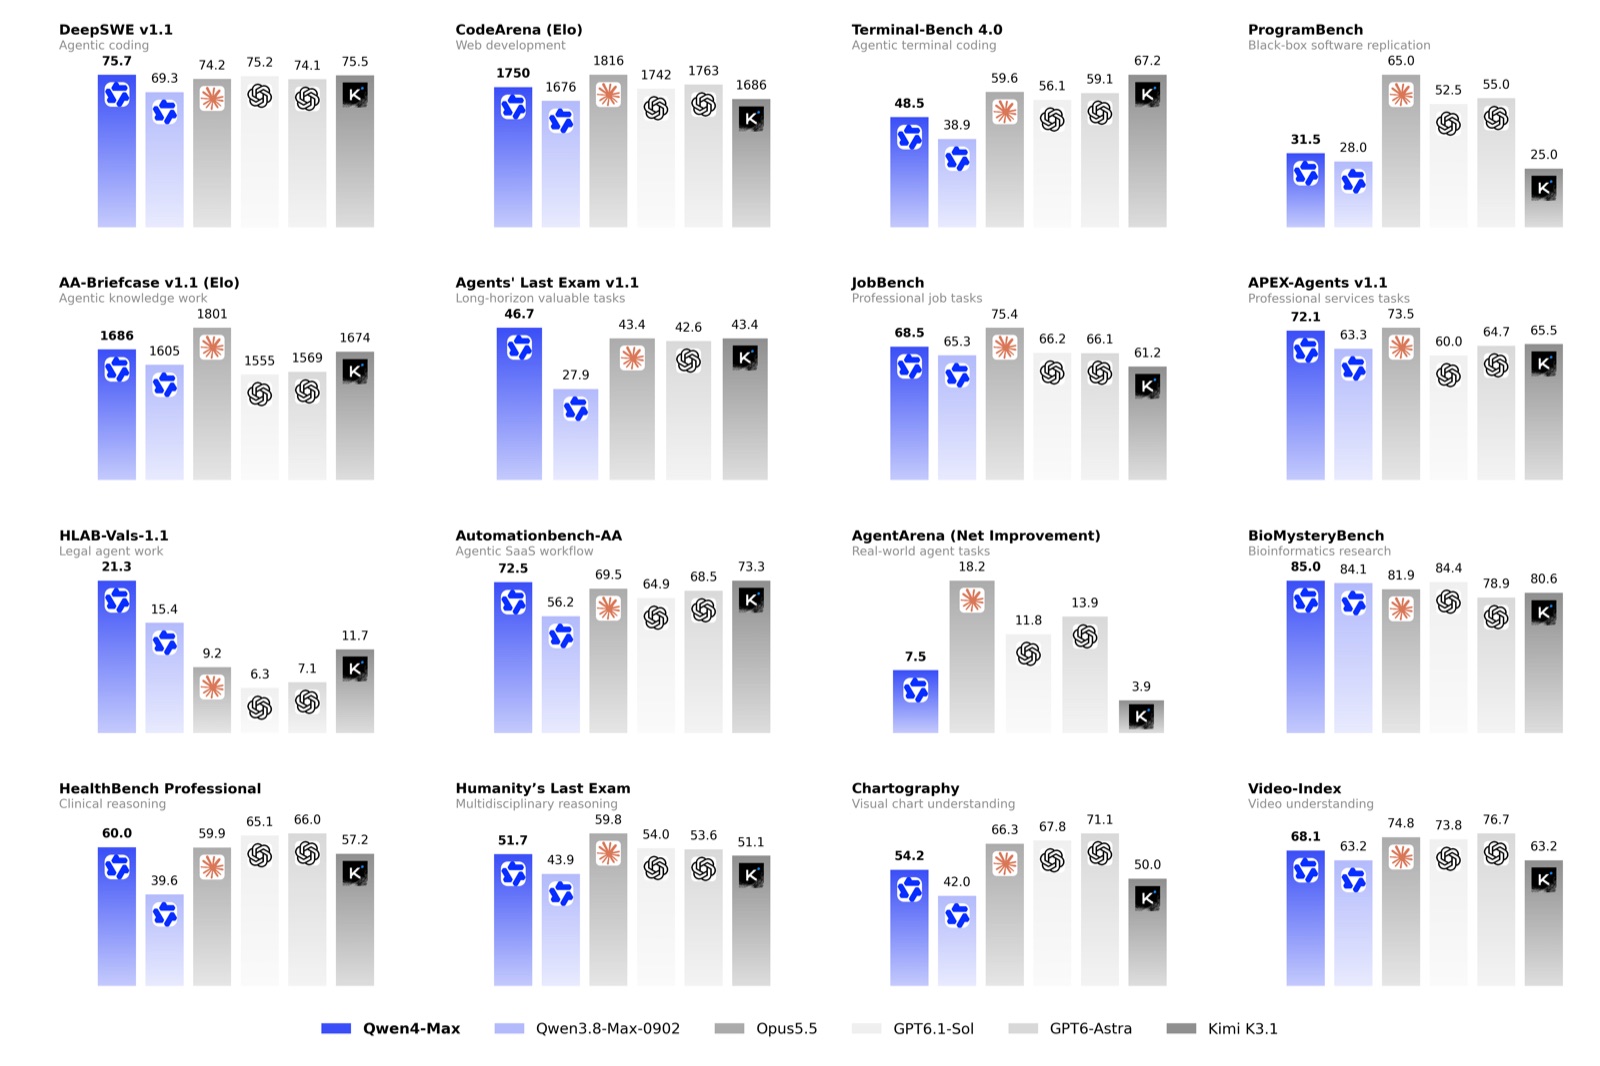
阿里 11 月 16 日发布新一代基座模型 Qwen4-Max:2.4 万亿主干参数、每个 token 激活 71B,另有 328B 的 N-gram Embedding 参数;具备原生视觉能力,支持百万 token 上下文。官方博客把它定位为”与你并肩工作、创作和探索的全天候 AI 新同事”,重点不在跑分,而在专业工具使用、长程任务执行与成果交付。模型已在千问 AI 平台提供 API 服务,快科技同日报道称单任务平均费用较上代大降约六成。
要点
- 架构围绕稀疏 MoE 升级:每四层里三层用 Gated DeltaNet 把历史压缩成固定状态,一层用 Qwen 稀疏注意力(QSA)以 block 粒度挑选相关上下文;Gated Residual 把残差流扩成四条并行分支;N-gram Embedding 在第二层提供局部 token 模式表示。官方称 2.4T 规模的预训练全程无 loss spike。
- 官方主打 token 效率与成本:Work360 评测中单任务平均费用从 26.58 元降到 11.16 元(-58%);Terminal-Bench 4.0 上 Xhigh/High 档 token 消耗分别降约 48% 和 49%,Work360 上降约 24% 和 35%。缓存命中价格低至 0.5 元/百万 token。
- 第三方转述的跑分需标注来源:快科技报道称 Qwen4-Max 在 CodeArena 前端(Webdev)盲测全球第 6,介于 GPT6-Astra 与 Claude Fable5.1 之间;ALE 46.7、Chartography 54.2、JobBench 67.3、Terminal-Bench 4.0 48.5(较上代 37.9 提升近 28%)。这些数字来自媒体报道与官方自述,尚无独立复现。
发布背景
Qwen4-Max 是 Qwen4 系列的首个 Max 规格。官方博客给出四个方向的能力展示:Blender 三维建模与场景创作、Unity/Unreal/Godot 游戏开发(它会实际运行游戏、按画面与交互反馈迭代)、汽车制造的产线规划与零件设计验证、以及金融法律医疗与前沿科学的长周期任务。Work360 是官方为此构建的行业基准框架,覆盖 26 个一级领域、182 个二级与 721 个三级细分领域。
与上一代 Qwen3.8-Max 相比,官方给出三组效率数字:基座 BPB 在知识、代码、问答、STEM 四类内部评测中下降约 5–13%,同时每 token 激活参数减少约 25%。这类”更少 token 做同样的事”的优化,直接决定了单任务成本,也是这代模型最值得核对的宣传点。
谁现在能用
Qwen4-Max 已上线千问 AI 平台的 API,缓存命中价格大幅下调;也可通过阿里 Token Plan 调用,或在千问办公、Qoder、千问 APP 中体验。官方称 Qwen4 系列的中小尺寸模型将陆续开源——本轮查阅未见具体时间表,关注开源权重的读者需要等后续公告。
怎么看
- 成本数字要看任务口径:58% 的降幅对应 Work360 的任务集与计价方式,换到你的任务上,输入长度、缓存命中率与输出长度都会改变结果;建议用自家任务做 A/B。
- 跑分以”厂商口径”对待:CodeArena 第 6、ALE 46.7 等由媒体转述官方数据,独立评测出来之前不宜写进选型结论。可对照 Gemini 4 Carbon 发布时同样的口径问题。
- 长程任务值得单独测:官方演示强调多步工具调用与迭代(例如游戏开发中自行运行调试),这类能力在短问答里看不出来,评估时应设计 20 步以上的真实任务。
编辑摘要
如果你的工作负载是编程、办公文档或长周期行业任务,Qwen4-Max 值得进一次候选池:先固定一小组真实任务,记录 token 用量、缓存命中率与最终账单,再与现用模型对比。官方博客与媒体报道给出了足够多的评测线索,但迁移收益只能靠自己的对照测试确认。同期的端侧语音方案可看 谷歌端侧语音。