论文用计数加全局最小代价切分重构分词,压缩率较 BPE 提升最高 67%
arXiv 论文提出 CNF-MCE 分词:250K 词表下压缩率较 o200k_base 提升 26.7%,百万词表 67.0%。
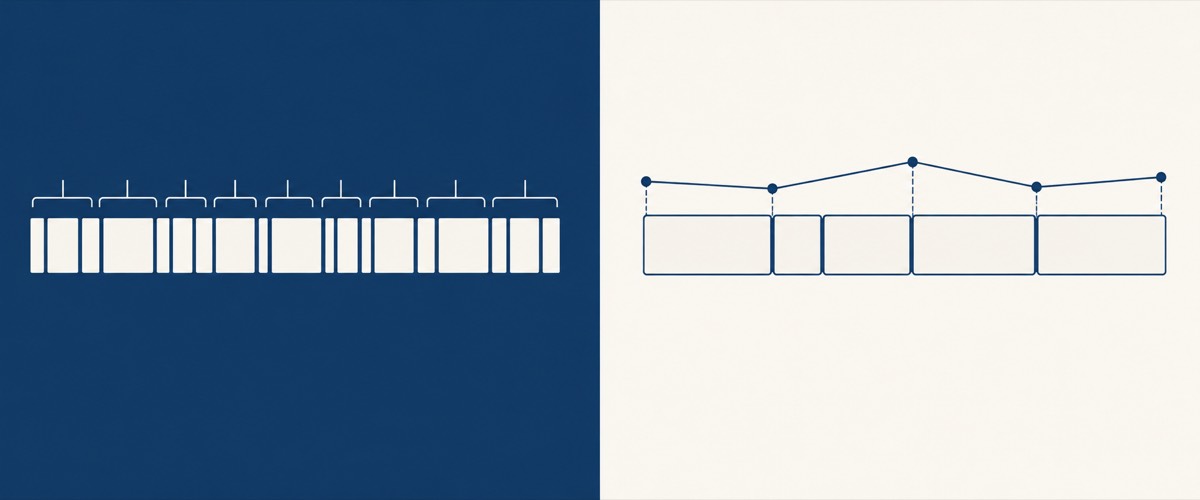
2026 年 10 月 1 日提交到 arXiv 的论文《Counting and Min-Cost Encoding for Tokenization in Large Language Models》(arXiv:2610.01127,作者包括 Shuming Shi、Ning Jiang 等十人)提出一套叫 CNF-MCE 的分词框架:不再按 BPE 的「自底向上逐步合并」构建词表和切分文本,而是先直接统计候选子串、再按实际使用过滤词表,编码时用动态规划找全局代价最低的切分。在 250K 词表上,英文网页文本的字符级压缩率相比 o200k_base 和 qwen250k 分别提升 26.7% 和 32.4%;词表扩到约百万条目时,提升达 67.0%。
要点
- 论文 10 月 1 日提交 arXiv(cs.CL),方法是词表构建与编码解耦:CNF 负责「统计候选再按使用频率过滤」,MCE 负责「整段文本上找最低代价切分」。
- 250K 词表组在六类文本(英文网页、PDF、数学、代码、中文、多语言)上全面领先 BPE 基线;英文网页 CPT 相比 ds128k 和 qwen152k 分别提升 20.6% 和 23.2%。
- 1.8B 与 8B 两个规模从头训练的模型,在 11 项基准上的平均表现与 BPE 分词模型「持平」——论文的收益主张是压缩率,不是下游质量。
背景
大模型效率优化的主流叙事是「让每个 token 算得更快」:更高效的注意力、KV-Cache 压缩、量化推理,直到微软把推理芯片 Maia 300 也算进这条线(见 微软发布自研推理芯片 Maia 300)。这条路径的共同前提是 token 序列长度不变。CNF-MCE 切的是另一头——同样的文本编码成更少的 token,推理耗时随 token 数等比例下降。InfoQ 10 月 14 日的编译报道把它放进了这个框架里讨论,并指出其动机针对 BPE 的两个结构性局限:合并历史约束(长 token 的中间产物占据词表容量)和预分词边界(「the United States」这类高频短语难以成为单个 token)。
事实部分
论文报告的主要数字(均为论文自报,InfoQ 编译同源):
| 指标 | 数值 | 条件 |
|---|---|---|
| 英文网页压缩率提升 | 26.7% / 32.4% | 250K 词表,对比 o200k_base / qwen250k(字符级) |
| 英文网页 CPT 提升 | 20.6% / 23.2% | 较小规模组,对比 ds128k / qwen152k |
| 百万词表提升 | 67.0% | 英文网页,约 1M 条目 |
| 词表利用率 | 52.9% → 96.9% | 1K 到 1M 的扩展实验中 |
| 下游表现 | 持平 | 1.8B 与 8B 从头训练,11 项基准平均 |
工程细节上,CNF 的计数阶段按长度区间分轮进行,靠已有前缀频率提前停止无效扩展,论文称 32 线程下百万篇英文文档的原始词表构建耗时不到一小时;混合词表训练用了 690 万篇文档,先建 500 万条目原始词表,再筛出约 138K 和 250K 两档。MCE 在 UTF-8 字节序列上编码,词表包含全部 256 个单字节 token,任意输入都有可用编码路径。
各方说法
论文自己给的两个例子说明了切分差异:用同一份 qwen250k 词表,BPE 把「pysimplesoap」切成五个 token,MCE 得到三个;「memory_efficient」两者 token 数相同,但 MCE 把下划线独立出来、保留两侧完整单词。InfoQ 的编译同时提醒,压缩率与 CPT 是两个指标——英文网页 CPT 提升 32.4% 换算成 token 数量约减少 24.5%,「实际延迟和成本还取决于模型与部署配置」。
需要说明的证据边界:这是一篇 10 月 1 日提交的预印本(v1),arXiv 页面只有摘要,没有第三方复现;论文未提供代码与数据链接,压缩与下游数字都出自作者自述。
编辑判断
对做推理成本优化的人,这篇论文的价值在于把「分词」重新变成可优化的变量——过去词表几乎等同于 BPE 的产物,CNF-MCE 说明词表构建与编码算法可以分开研究、分别替换。但落地上要先过两关:一是没有开源实现,「百万词表利用率从 52.9% 到 96.9%」这类数字目前只能信作者;二是收益集中在压缩率,下游质量只是持平——token 变少省下的算力,能不能抵消换分词器带来的迁移成本(词表、embedding、已有模型全部作废),每个团队要自己算。
真正该盯的下一个信号是代码与数据是否发布,以及有没有独立团队复现那组压缩数字。